1 总体设计
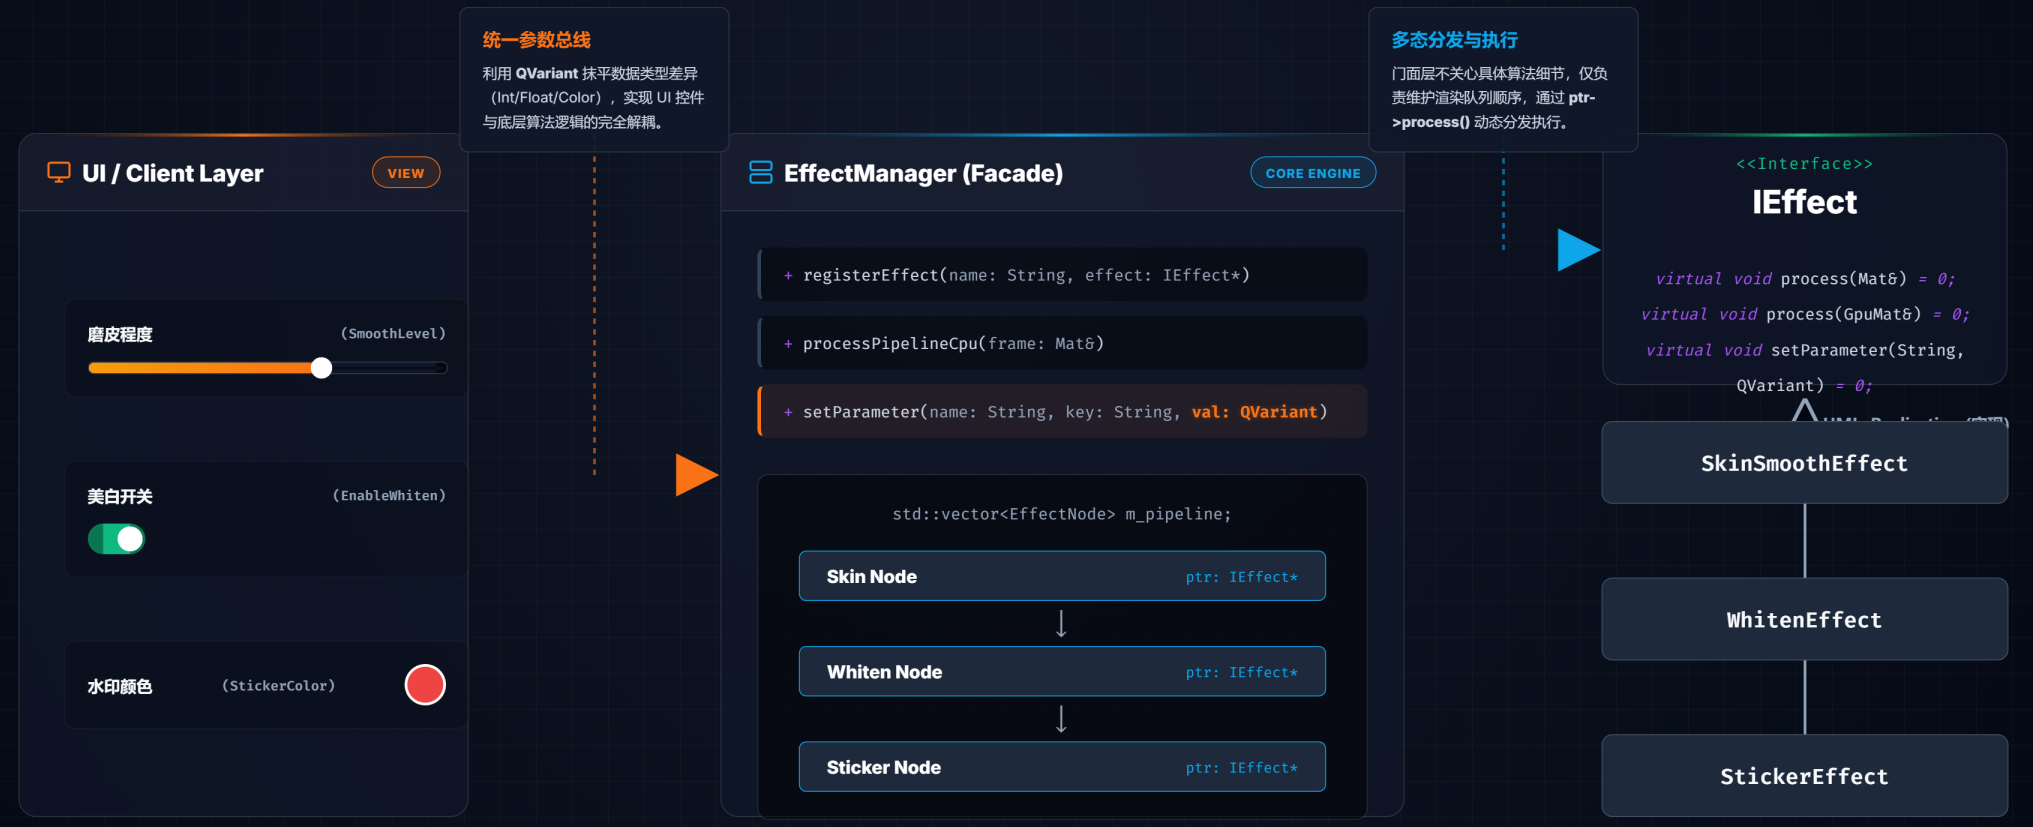
引擎在顶层设计上采用了面向接口编程的思想,主要分为两个核心部分:
- 统一的特效契约(IEffect接口):所有特效(无论是磨皮、美白还是贴纸)都必须继承IEffect基类。这个基类抽象出了三个核心动作:process(处理图像)、setParameter(设置参数)和开关状态控制。
- 集中的大管家(EffectManager):充当门面(Facade),对外隐藏了所有滤镜的具体调用细节。业务层只需要告诉Manager我要开启美白,参数设为50,Manager就会找到对应的特效对象并下发指令。
1.1 为什么要这样做?(优势)
极致的解耦(符合开闭原则OCP):如果新增一个“变脸”特效,不需要修改EffectManager的核心逻辑,只需要新建一个类继承IEffect,然后再EffectConfigurator中注册即可。
统一的参数总线:利用std::string和QVariant作为参数传递的载体,打破了不同特效参数类型不一致(有的需要float,有的需要string)的壁垒,这使得UI层利用反射或数据绑定动态生成调节滑块变得简单。
2 特效管线设计
特效管线是一种基于责任链模式(Chain of Responsibility)的变形,他将各种独立的图像处理操作(如磨皮、美白、贴纸)串联起来,按严格的顺序依次执行。
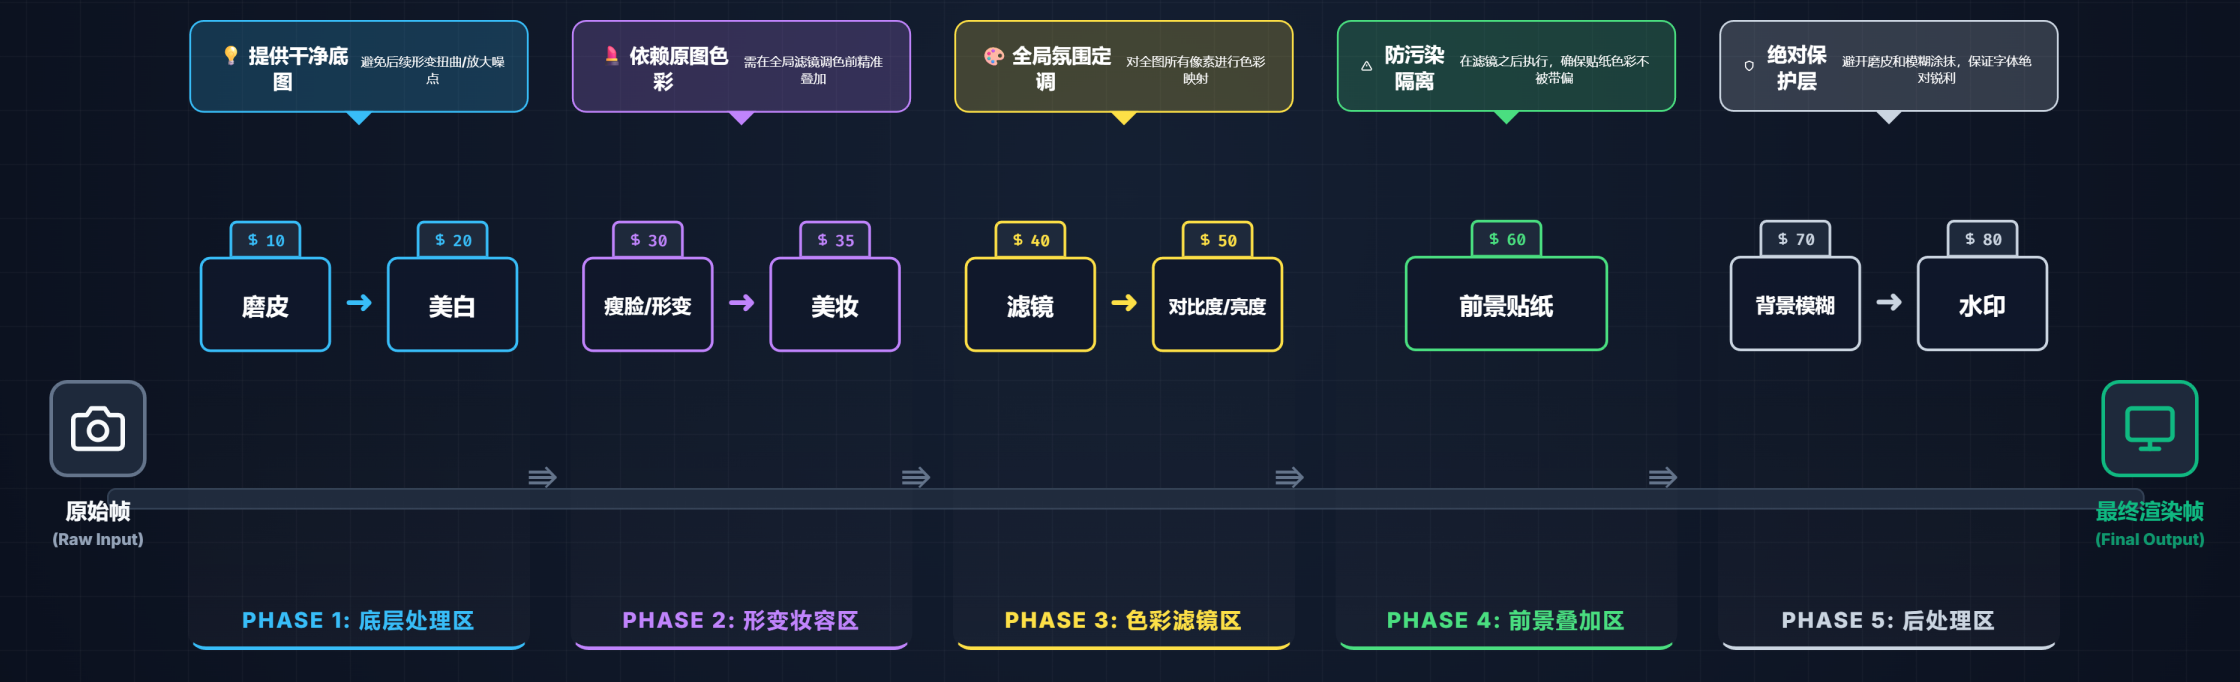
统一的抽象接口:定义了IEffect基类,规定了所有特效必须实现process和setParameter等方法。这使得管线可以按统一的方式对待所有特效,而不需要知道具体的实现细节。
有序的执行队列:在 EffectManager 中,管线被存储为一个包含EffectNode的std::vector,每个节点都有一个order(权重/优先级)。当调用registerEffect注册特效时,系统会自动根据order进行排序。
科学的处理顺序:在EffectConfigurator::configureDefaultPipeline中,定义了执行顺序:
- 底层处理:磨皮(10)->美白(20)。必须最先执行,为后续提供干净的底图。
- 形变与妆容:瘦脸/形变(30)->美妆(35)。
- 色彩与滤镜:滤镜(40)->对比度/亮度(50)。
- 前景叠加:贴纸(60)。必须在色彩调整后加上,否则贴纸会被滤镜影响导致偏色。
- 后处理:背景模糊(70)->水印(80)。水印放在最后,防止被前面的任何特效(比如磨皮或模糊)破坏。
3 人脸检测
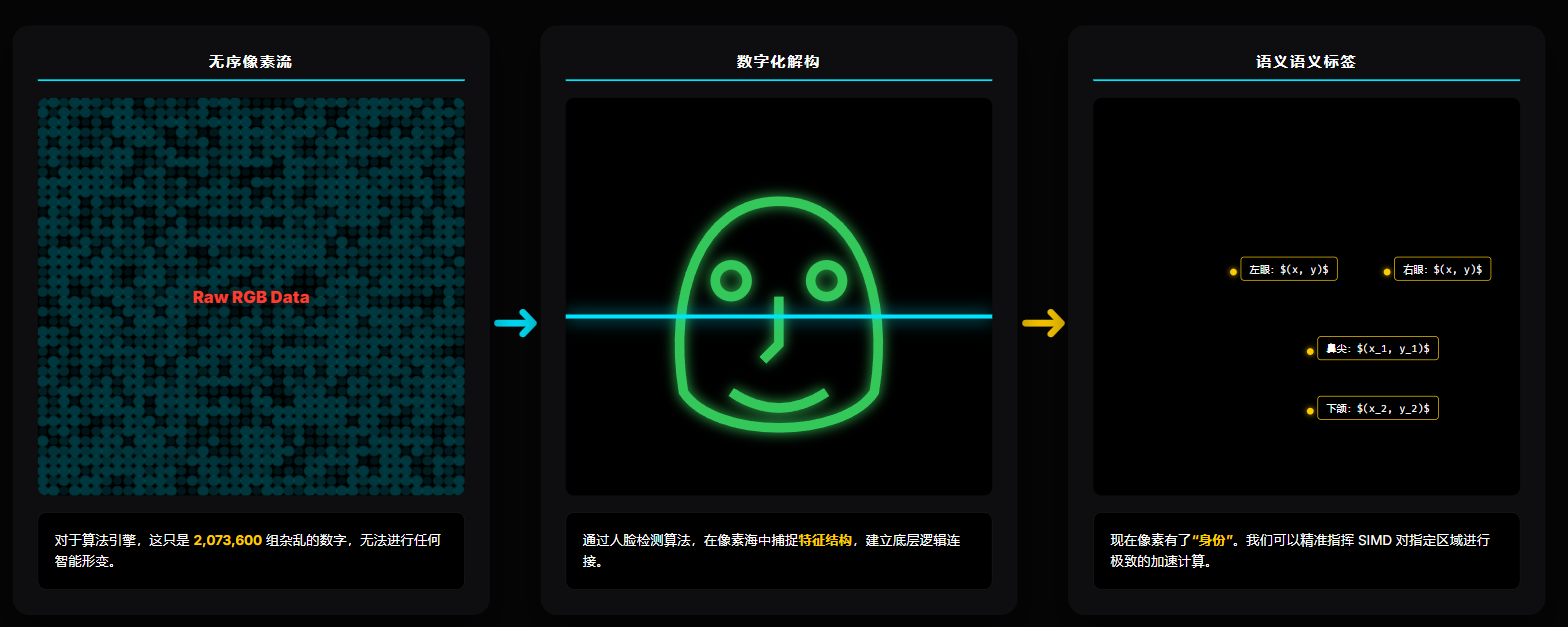
在数字图像处理的世界里,所有的操作本质上都是对像素点坐标的数学运算。
算力与目标的脱节:如果没有人脸检测,极致的SIMD液化算法(如:瘦脸、大眼)将面临”盲人摸象“的困境。虽然算法拥有每秒处理数百万像素的强大”肌肉“,但在缺乏引导的情况下,程序无法识别”眼睛“或”下巴“的具体像素位置。
从像素到语义的跨越:人脸检测的任务是将无意义的RGB像素流翻译为计算机可理解的 ”语义坐标“ 。通过锁定人脸,程序才能精准下达指令:在指定的(x,y)坐标处执行局部形变或特效叠加。
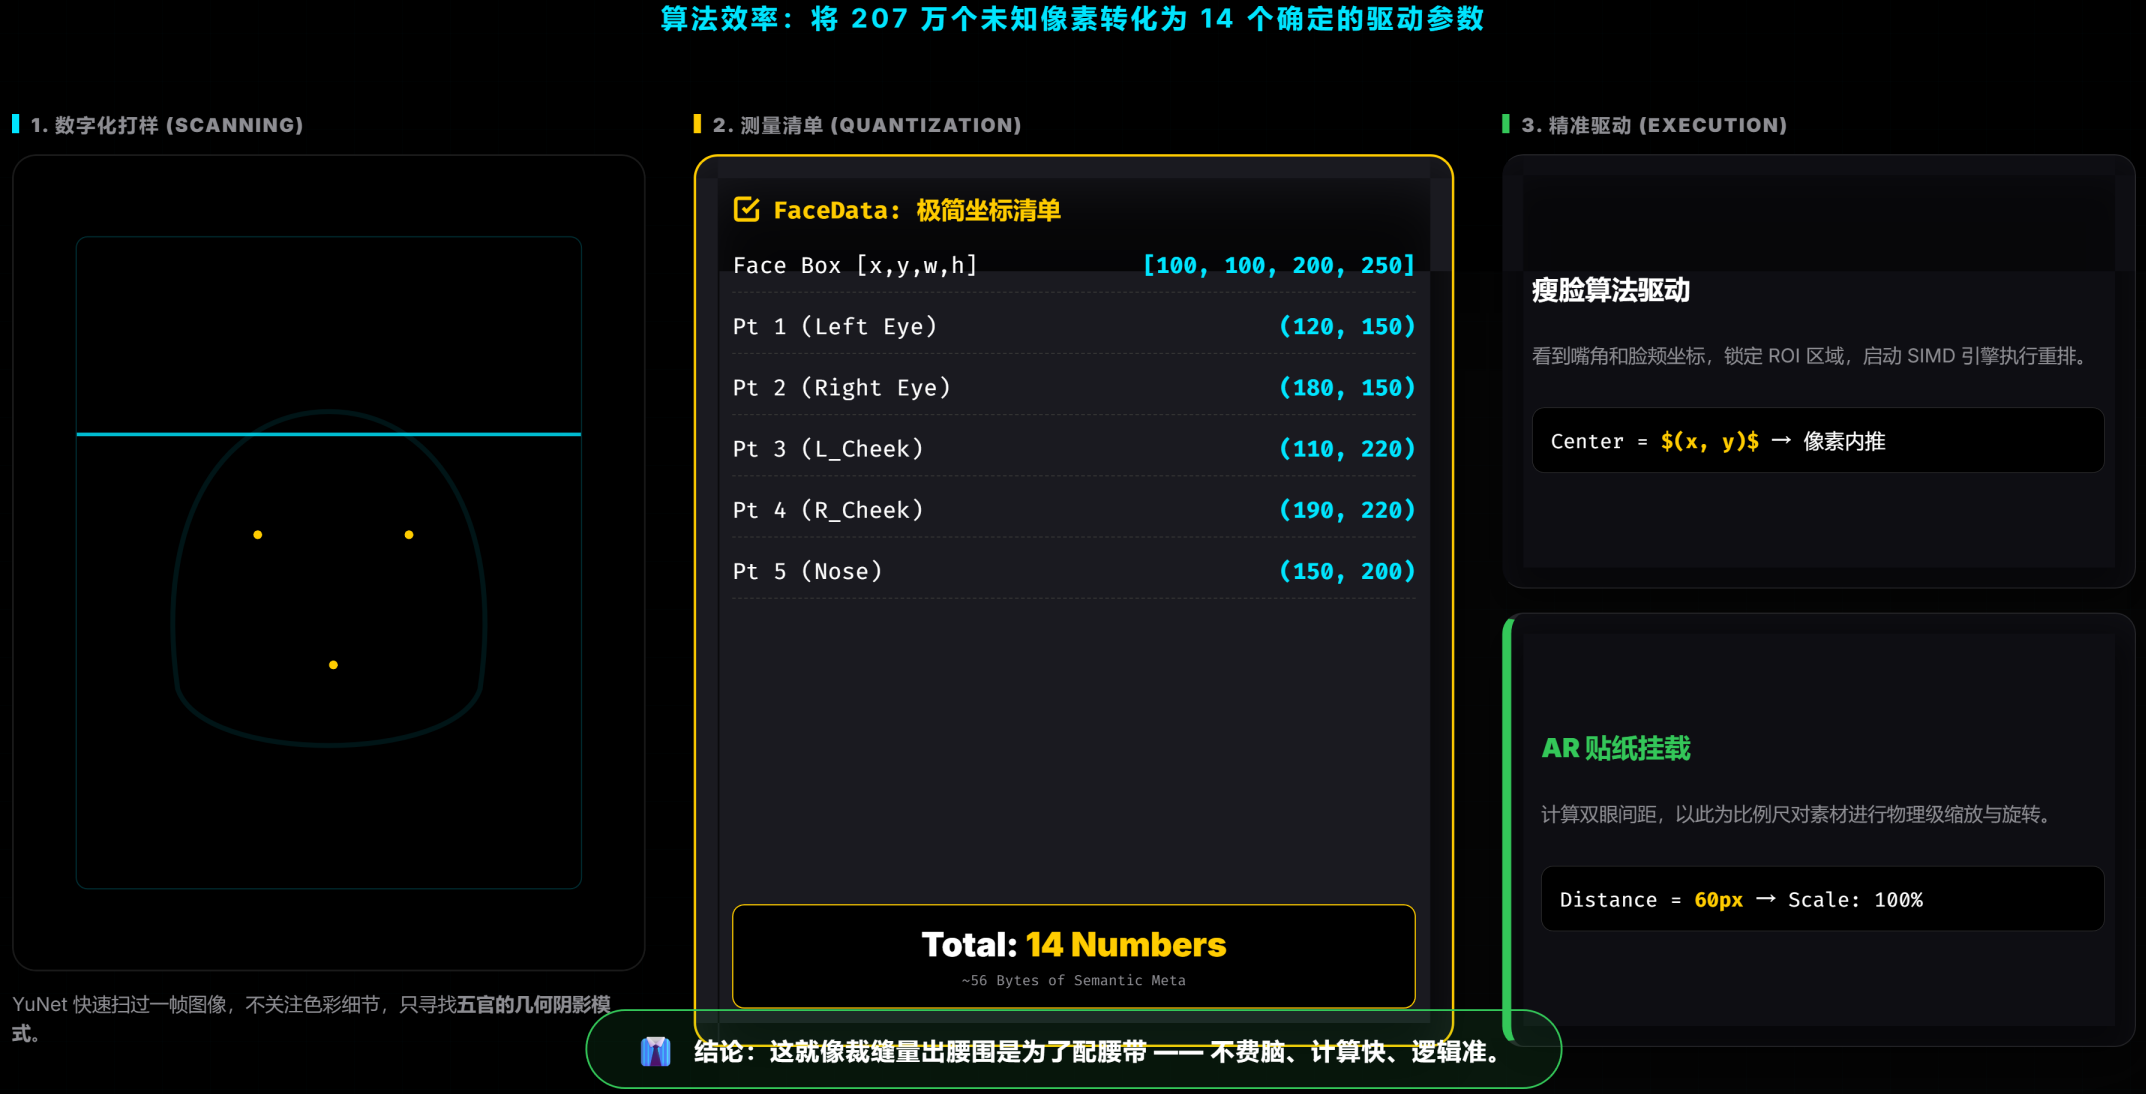
YuNet五点模型:本项目采用高性能的YuNet模型,通过FaceData结构体导出5个核心关键点:左眼、右眼、鼻尖、左嘴角、右嘴角。
特效驱动基础:
- 瘦脸/大眼:利用关键点确定的中心点(Center)和半径(Radius)驱动SIMD液化核。
- AR贴纸:根据双眼间的距离(Dist)和斜率计算贴纸的缩放比例与旋转角度。
3.1 人脸检测 vs 人脸识别
在实时音视频领域,清晰定义”检测“与”识别“的边界对系统架构优化至关重要。
- 人脸检测(Detection):
其中:
- 核心目标:回答”人脸在哪里?“。
- 技术焦点:关注矩形框位置与关键点精度。
- 实时性要求:极高。为了保证特效不掉帧,检测逻辑通常需要锁定在毫秒级执行。
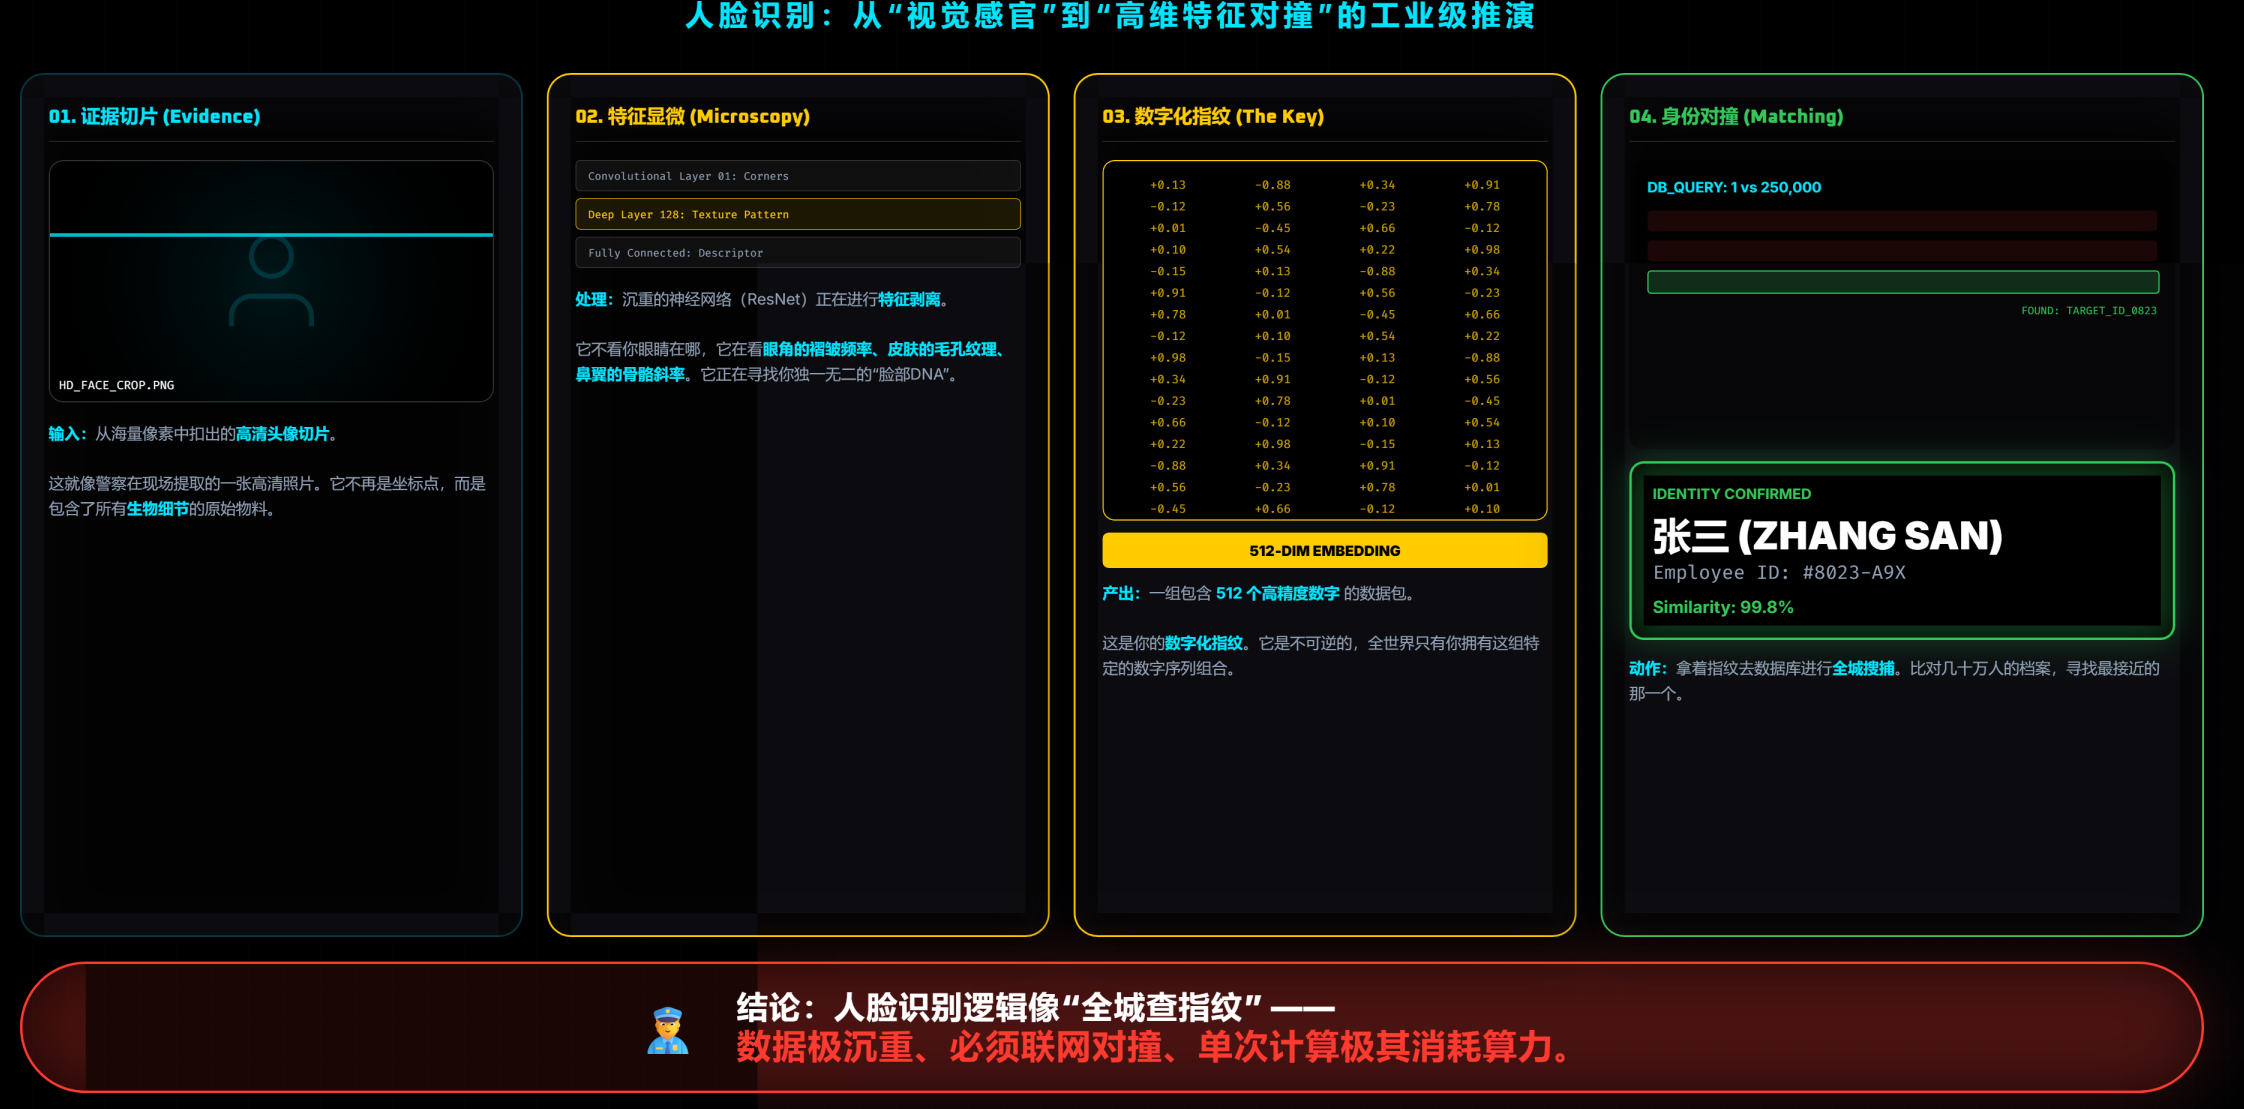
人脸识别(Recognition)
- 其中:
- 核心目标:回答“人脸是谁?”。
- 技术焦点:提取面部特征向量并与数据库比对。
- 应用差异:直播特效仅需“位置”数据来驱动渲染,并不关心用户身份。因此,本项目专注于检测,以换取极高的执行效率。
- 工程妥协策略:
- 由于AI推理依然存在性能开销,代码中采用了抽帧检测策略(每两帧检测一次:m_frameCounter++ %2 == 0),以平衡CPU占用率并保持画面流畅。
3.2 实现细节
在FaceTracker.cpp中,有几个点需要注意的:
- 路径与编码保护:
- OpenCV的C++接口在Windows系统下,底层往往调用的是标准C的文件接口I/O。他们通常不支持UTF-8。如果用户的电脑用户名或模型路径包含中文,直接传std::string会导致OpenCV找不到文件触发内存崩溃。而**toLocal8Bit()**会根据操作系统的当前区域设置(Local)将字符串转换为正确的编码(如GBK)。
// FaceTracker.cpp -> loadModel 函数
QString qPath = QString::fromStdString(modelPath);
// ... [略去路径检查代码] ...

// 核心:将 Qt 的 UTF-16 字符串转为当前系统的本地编码 (ANSI/Local8Bit)
std::string safePath = qPath.toLocal8Bit().constData();

m_detector = cv::FaceDetectorYN::create(safePath, "", ...);
- 坐标还原映射
- 因为是在320尺寸下检测的,所有必须通过scaleX/scaleY将坐标还原到原始分辨率(如1080P),否则特效位置会全部错位。
// FaceTracker.cpp -> detect 函数
const cv::Size inferenceSize(320, 320); // 1. 固定推理尺寸
cv::resize(imgBGR, inputBlob, inferenceSize);

// ... [推理得到 faceData] ...

// 2. 计算缩放因子 (从 320 还原到原始 w x h)
float scaleX = (float)w / 320.0f;
float scaleY = (float)h / 320.0f;

// 3. 物理空间坐标还原
m_currentFace.rect.x = (int)(faceData[0] * scaleX);
m_currentFace.rect.y = (int)(faceData[1] * scaleY);
// ... [同理还原 landmarks] ...
- 线程安全:
- 由于检测时异步或多模块共享的,代码通过std::lock_guard < std::mutex >确保了m_currentFace数据在读取和更新时不会发生数据竞争。
// FaceTracker.h
mutable std::mutex m_mutex;

// FaceTracker.cpp -> detect / getFaceData 函数
void FaceTracker::detect(const cv::Mat& imgBGR) {
    // ...
    std::lock_guard<std::mutex> lock(m_mutex); // 1. 更新时加锁
    m_currentFace = ...;
}

FaceData FaceTracker::getFaceData() const {
    std::lock_guard<std::mutex> lock(m_mutex); // 2. 读取时也必须加锁
    return m_currentFace;
}
4 CPU与GPU差异
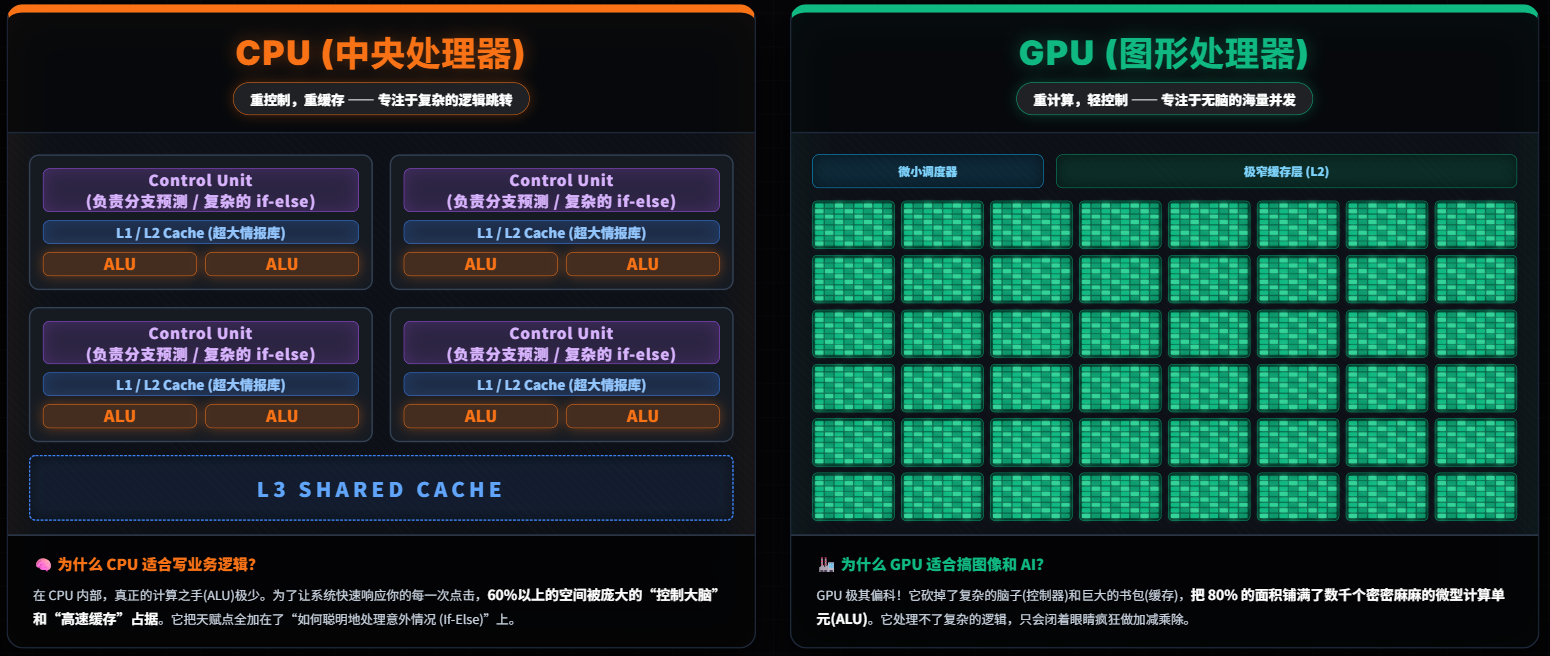
CPU和GPU在芯片设计上存在根本分歧:“低延迟”、“高吞吐量”的博弈。
4.1 CPU低延迟导向
- 架构优势:CPU的芯片面积大部分被巨大的多级缓存(L1/L2/L3 Cache)和复杂的控制单元(Control Unit)占据,仅保留极少数量的算术逻辑单元(ALU)。
- 核心优势:极高的单核时钟频率。其复杂的控制单元支持超标量执行、分支预测和乱序执行。这使得CPU在处理复杂的串行逻辑分支(如密集的if-else条件判断)时,能够以极低的延迟快速响应。
4.2 GPU高吞吐量导向
- 架构特征:GPU摒弃了复杂的控制流和庞大的缓存结构,将绝大部分晶体管全部分配给了计算核心(成千上万个精简的ALU)。
- 核心优势:基于SIMT(单指令多线程)架构。虽然GPU的单核主频较低,且不具备复杂的逻辑预测能力,但它能够在同一时钟周期内,调度成千上万个轻量级线程执行完全相同的指令。
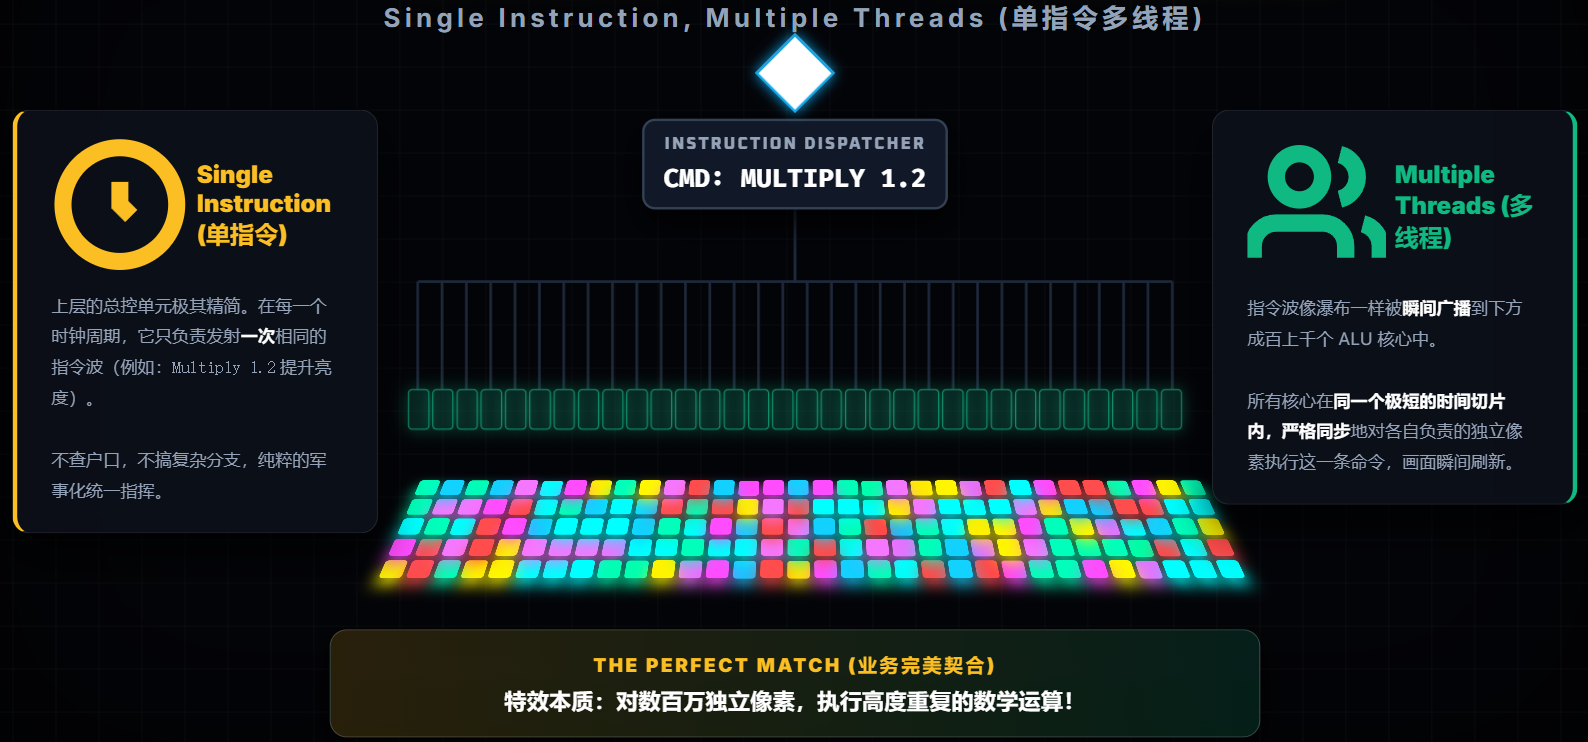
- 业务映射:视频画面由数百万个独立的像素点组成。如,亮度调节、色彩映射等特效操作,本质上是对这数百万个像素执行高度重复的数学运算。这完美契合了GPU的SIMT架构特征,使其在此类任务中展现出极其恐怖的吞吐能力。
5 双流设计
- 双流设计是指系统同时拥抱CPU计算和GPU(CUDA)计算两条平行的处理链路,并能在运行时根据硬件条件动态切换。这是保证软件在高端显卡和低端核显机器上都能稳定运行的我关键。
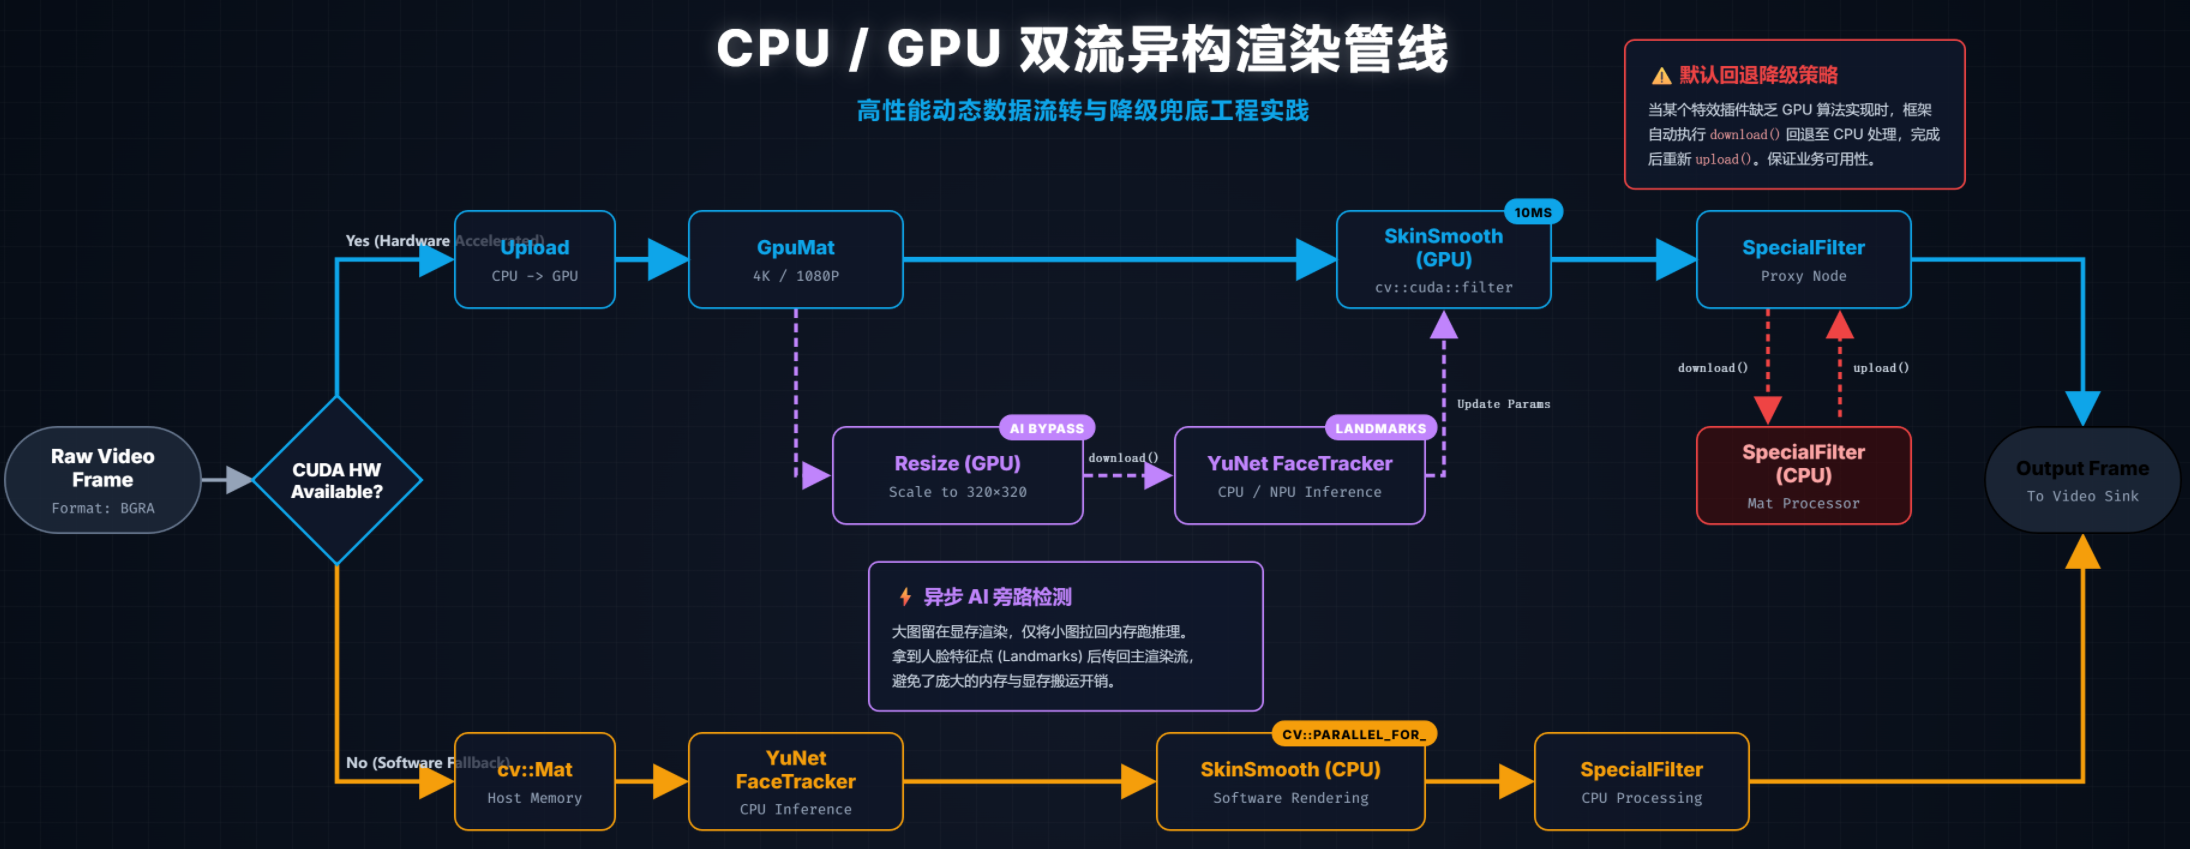
- 接口层的双路重载:IEffect接口强制(或默认)提供了两个process重载函数:一个是**cv::Mat&的CPU版本,另一个是接收cv::cuda::GpuMat&**的GPU 版本。
- 优雅的降级机制(Fallback):如果某个特效还没有来得及实现GPU版本,在IEffect::process(cv::cuda::GpuMat&)基类中提供了一个非常巧妙地默认实现:将显存数据下载到内存(download)->调用CPU的process->在上传回显存(upload)。这保证了即使有部分特效支持GPU,整条管线依旧能跑通。
- 智能的硬件检测与分发:EffectManager在初始化时会调用checkCudaHardware()检测是否有支持CUDA的设备。
- 如果有,默认走processPipelineGpu,直接操作GpuMat显存数据。
- 如果没有,自动回退到processPipelineCpu处理流水线。
6 降级CPU处理逻辑
如果写了a = b + c 一行代码,CPU实际要执行多少步骤。
取值、解码、执行、写回;
void scalar_add(int* a, int* b, int* res, int len) {
    for (int i = 0; i < len; i++) {
        res[i] = a[i] + b[i];
    }
}
#include <stdio.h>
#include <xmmintrin.h>  // SSE核心头文件
#include <time.h>       // 性能测试
#include <stdlib.h>     // 生成随机数
// 【SIMD版本】源码优化版,核心优化逻辑
void simd_add(int* a, int* b, int* res, int len) {
    // 优化点1:按SIMD寄存器宽度批量处理(128位=4个int)
    int batch_len = len - (len % 4);  // 计算能被4整除的长度
    int i = 0;
    // 优化点2:批量处理核心逻辑(一次算4个数)
    for (; i < batch_len; i += 4) {
        // 步骤1:非对齐加载——把a[i]~a[i+3]装进XMM寄存器
        __m128i vec_a = _mm_loadu_si128((__m128i*)(a + i));
        // 步骤2:非对齐加载——把b[i]~b[i+3]装进XMM寄存器
        __m128i vec_b = _mm_loadu_si128((__m128i*)(b + i));
        // 步骤3:SIMD并行加法——一次算4组a[i]+b[i]
        __m128i vec_res = _mm_add_epi32(vec_a, vec_b);
        // 步骤4:非对齐存储——把4个结果一次性写回res
        _mm_storeu_si128((__m128i*)(res + i), vec_res);
    }
    // 优化点3:边界处理——剩余不足4个的数,标量兜底
    for (; i < len; i++) {
        res[i] = a[i] + b[i];
    }
}
6.1 SIMD与CPU底层原理
执行模型的差异:
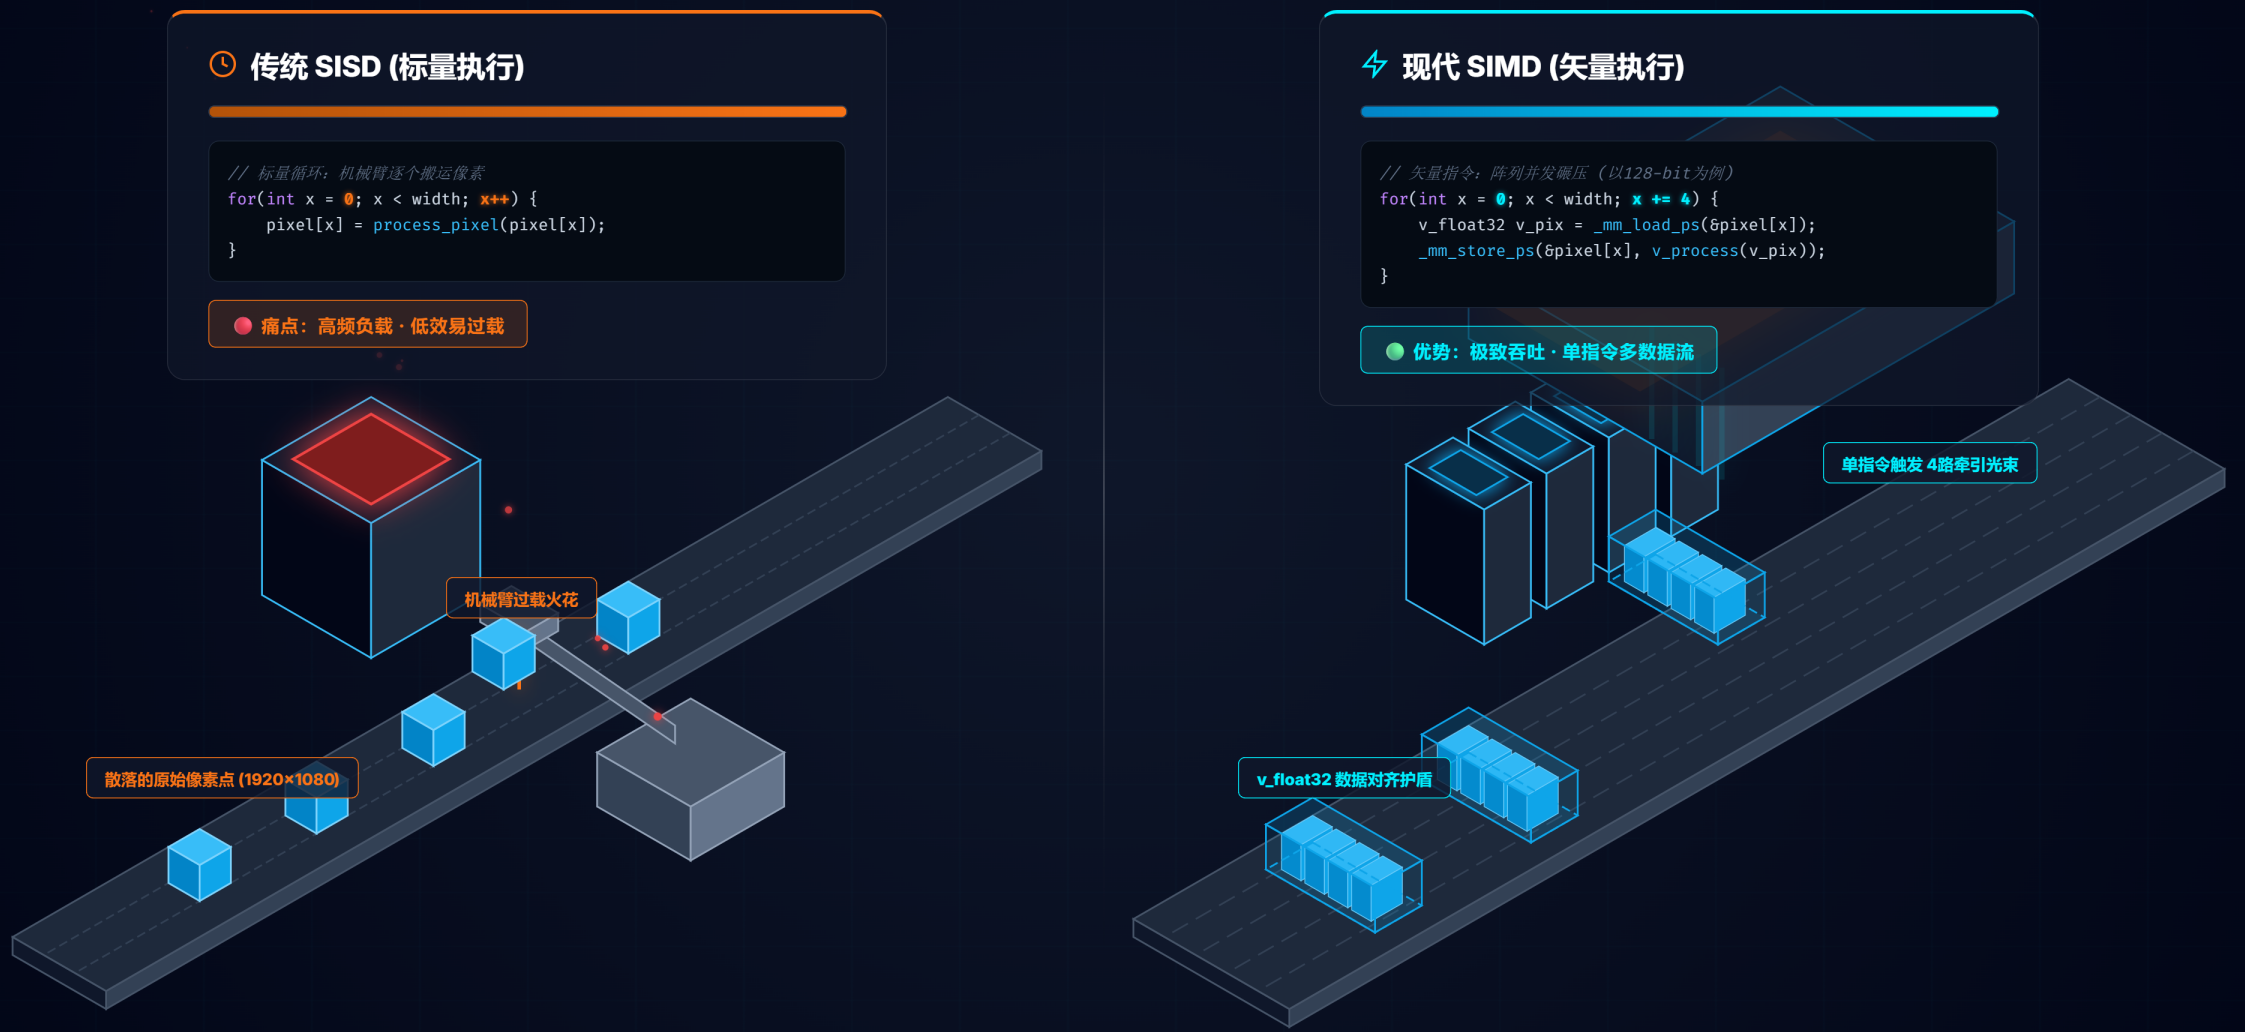
- 传统的标量执行(SISD):全称是Single Instruction Single Data(单指令单数据流)。传统的for循环就像是一个工人搬砖,每次只能处理单个数据单元(例如:一个像素的一个颜色通道)。
- 矢量执行(SIMD):全称是Single Instruction Multiple Data(单指令多数据流)。可以理解为给这个工人配了一台叉车。指令依然是“搬运”,但一次操作可以同时处理4个、8个、甚至更多的数据单元。
CPU的底层架构秘密:
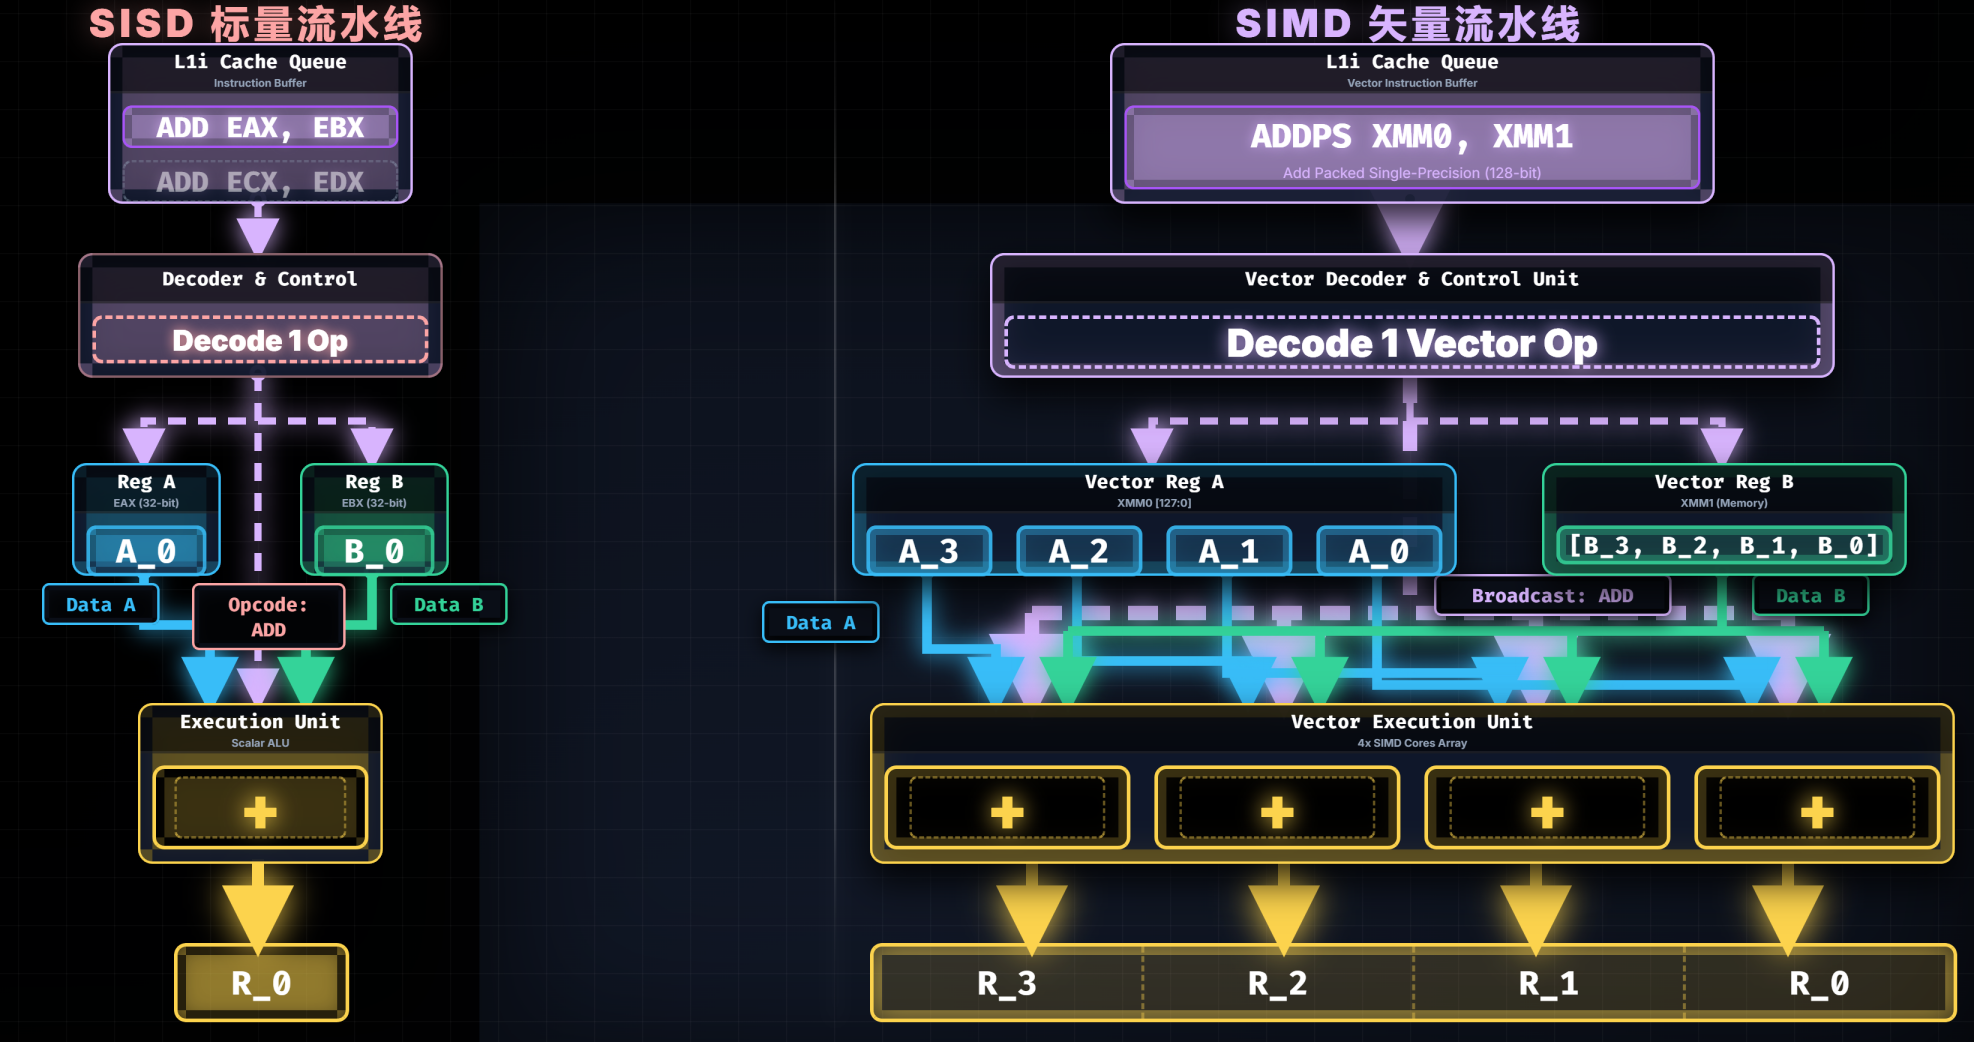
- 通用寄存器:标准的32位或64位寄存器,一次只能存1个float或double数据。
- 超宽矢量寄存器:现代CPU内部集成了专用的宽字节寄存器。例如,XMM寄存器(128位)可以同时容纳4个32位的float;YMM寄存器(256位)可以同时容纳8个float。
- 硬件级并行:当调用SIMD加法指令时,CPU的算术逻辑单元(ALU)会在同一个时钟周期,对寄存器中的4个或8个浮点数同时完成加法计算。这是一种指令级别的纯硬件加速,而非软件层面的多线程。
6.2 SIMD与图像处理
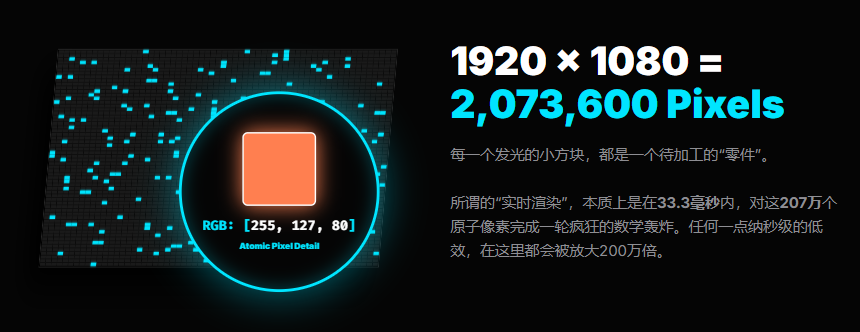
- 严苛的算力与时间约束:
- 以1080P分辨率为例,一帧画面包含1920x1080 ≈ 207万个像素。
- 对于“瘦脸”或”大眼“这种空间形变(液化)算法,每一个像素坐标的重映射都涉及大量的浮点数乘法运算和极其耗时的开平方(sqrt)运算。
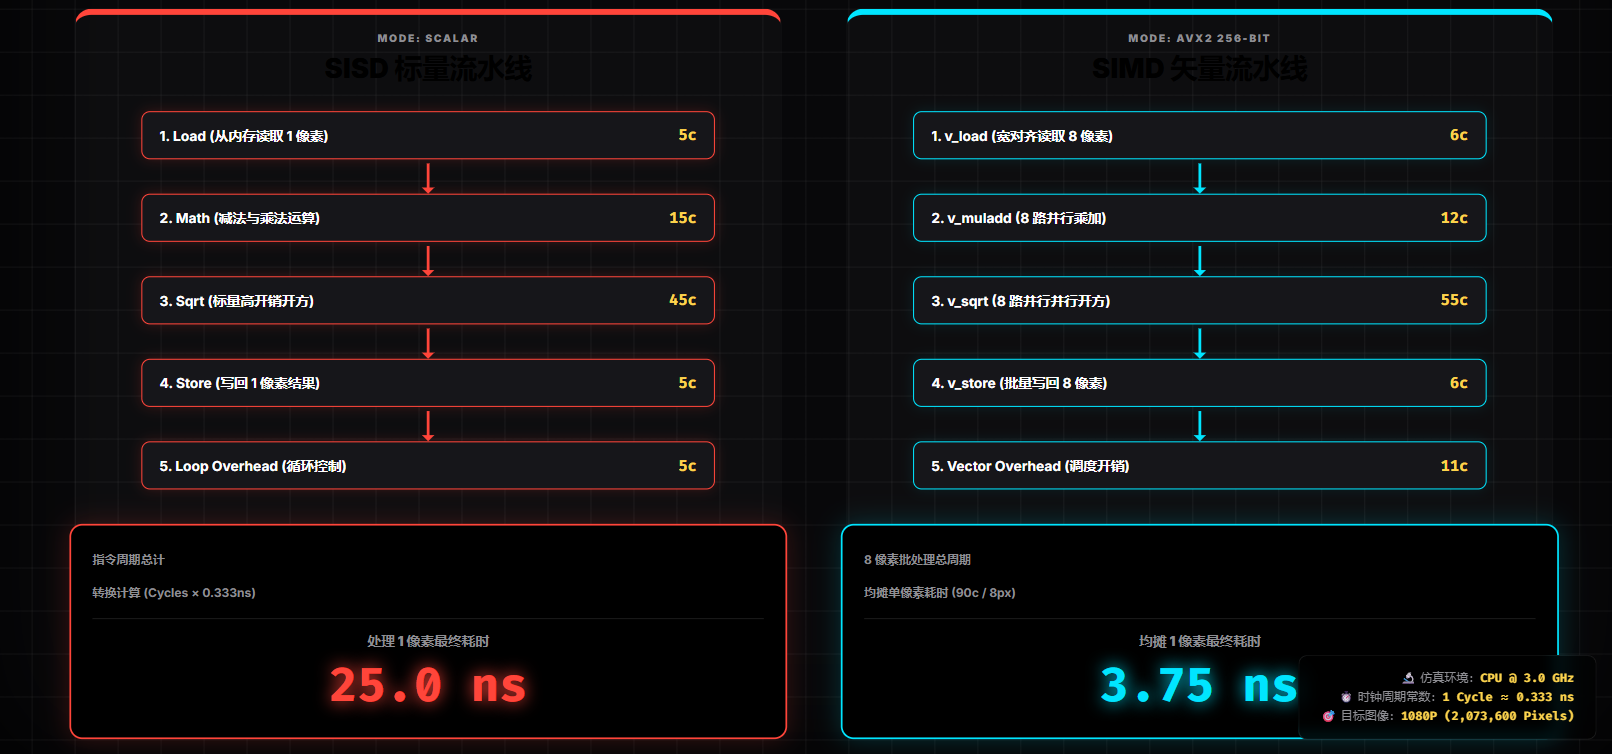
- 在 30FPS的实时处理标准下,CPU只有约33毫秒的时间来完成这一整帧的计算。传统的标量for循环在如此高频、密集的数学运算前,极易遭遇性能瓶颈,导致画面掉帧。
- GPU的局限性与CPU的不可替代行:
- 虽然GPU天生适合大规模并行计算,但在实际工程架构中,为了避免 CPU内存 与 GPU显存 之间 频繁拷贝 带来的巨大总线延迟
- 或者在 缺乏高端独立显卡 的设备上,往往需要在CPU端预先计算好复杂的形变网格。此时,利用SIMD榨干CPU多核算力就成了最佳选择。
6.3 OpenCV通用指令集封装
直接编写底层的SIMD汇编指令,不仅编写困难,难以阅读,且无法跨平台运行。但OpenCV提供的封装库。它提供了一套通用的指令集。
以下结合AdvancedEffects.cpp中的FaceReshapeEffect::warpLocal 函数,剖析普通的标量逻辑是如何转换为SIMD矢量逻辑的。
- 第一步:数据的批量加载(Load)
//FaceReshapeEffect: `void FaceReshapeEffect::warpLocal(cv::Mat& mapX, cv::Mat& mapY, const cv::Point2f& center, float r, float strength)`
cv::v_float32 v_x = cv::v_load(ptrX + x); [cite: 1]
使用 cv::v_load(ptrX + x) 指令,CPU可以越过逐个读取的限制,一次性从内存地址中连续读取4个或8个像素的X坐标,加载到矢量寄存器中。
- 第二部:矢量数学运算(Math)
//FaceReshapeEffect: `void FaceReshapeEffect::warpLocal(cv::Mat& mapX, cv::Mat& mapY, const cv::Point2f& center, float r, float strength)`
cv::v_float32 v_dist2 = cv::v_muladd(v_dx, v_dx, v_dy2); [cite: 1]
并行减法:cv::v_sub(v_x,v_cx) 能同时计算出多个像素距离中心点的横向偏移量。
融合乘加(FMA):代码中使用的 cv::v_muladd(v_dx, v_dx, v_dy2) 的指令。他在底层将乘法和加法融合为一步,直接算出
dx^2+dy^2
不仅速度翻倍,还减少了中间结果的精度损失。
- 第三步:数据的批量写回(Store)
cv::v_store(ptrX + x, v_res_x); [cite: 1]
计算完成后,使用 cv::v_store(ptrX + x, v_res_x) 将寄存器中的多组新坐标一次性安全地写回内存。
7 CUDA 架构与封装
拥有了庞大的GPU核心阵列,开发者需要一套标准化的接口来指挥这支”算力大军“。
什么是CUDA?
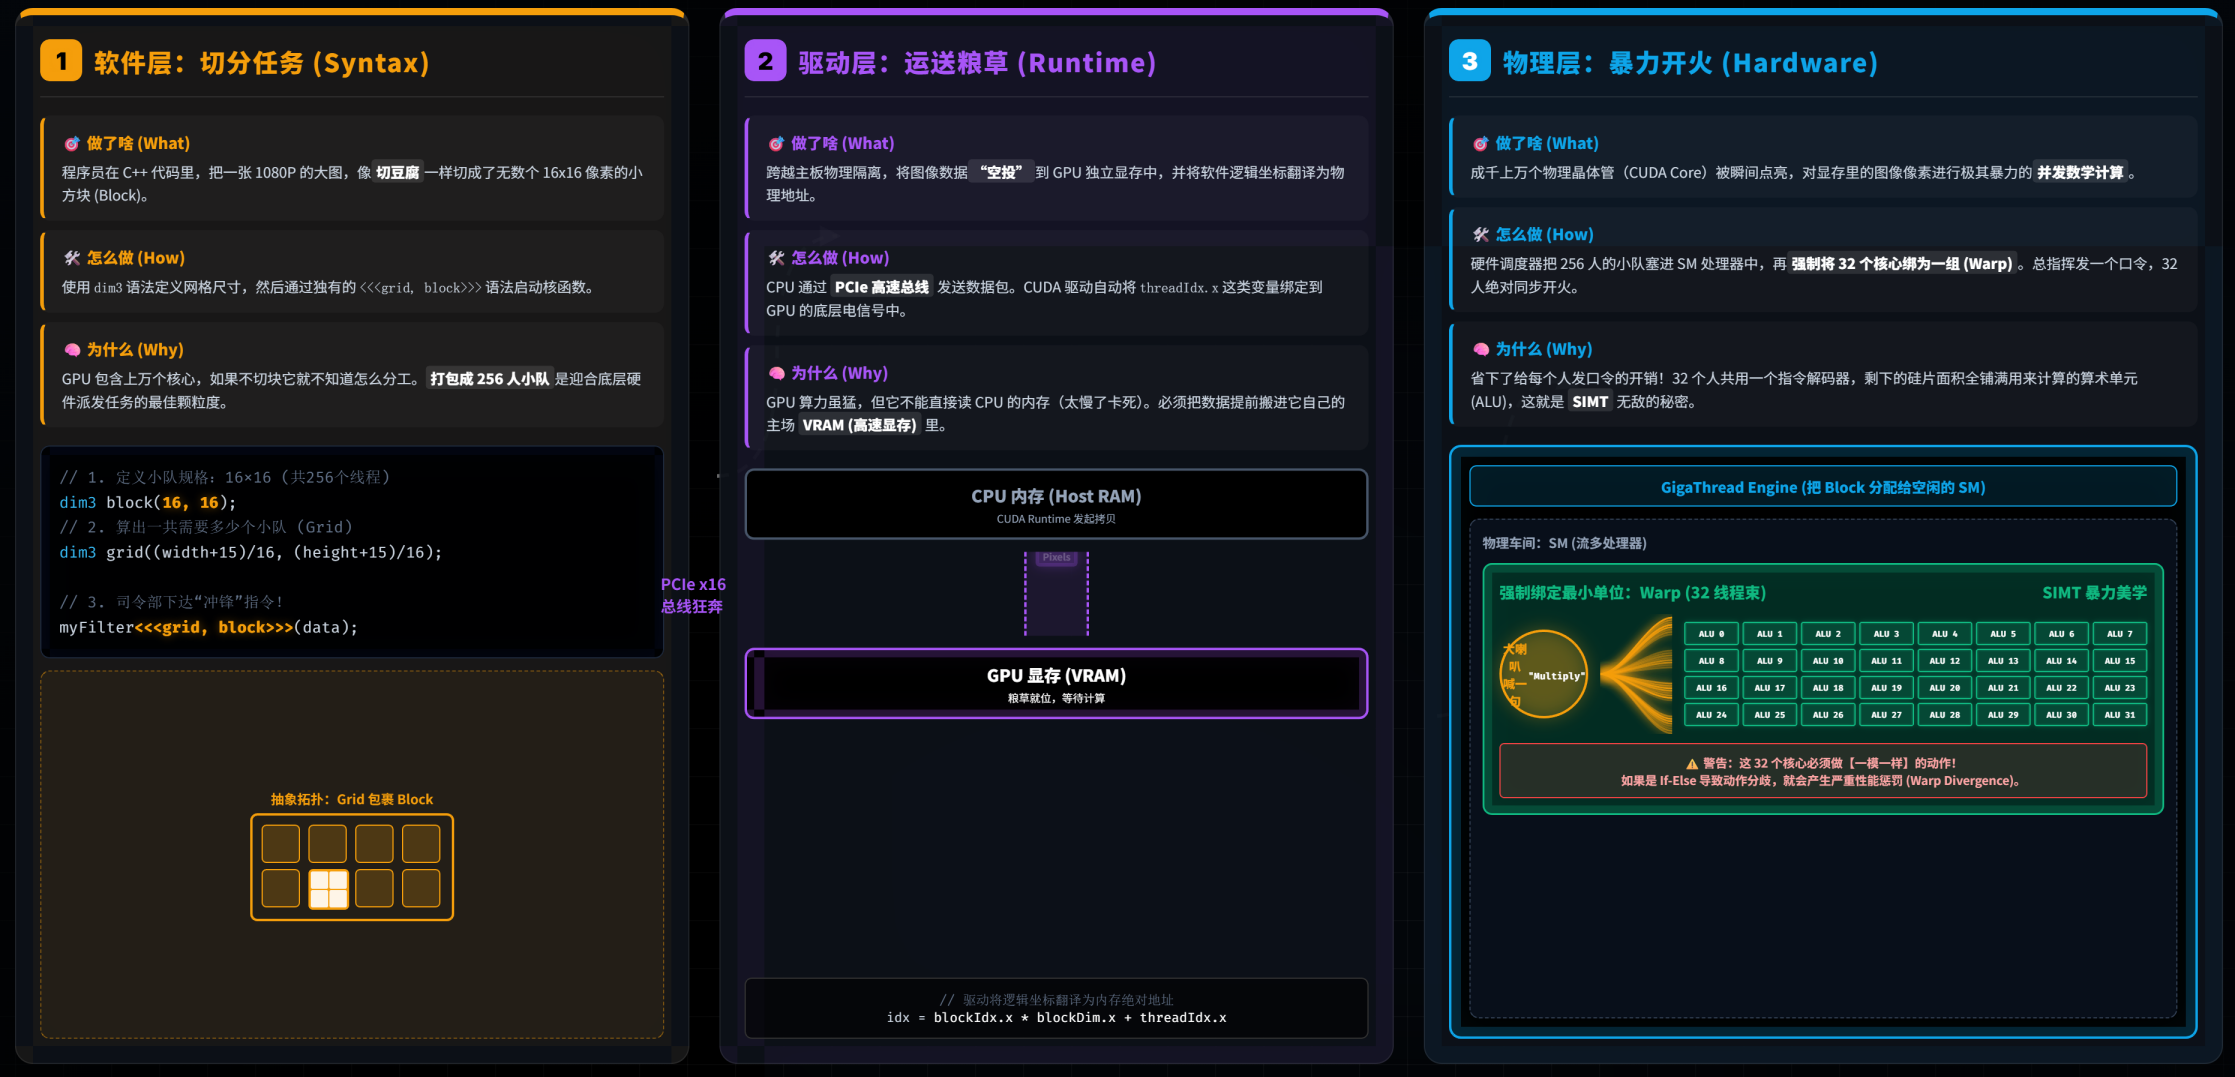
CUDA(Compute Unified Device Architecture,统一计算架构)是NVIDIA推出的一种通用并行计算平台的编程模型。
他打破了早期GPU只能通过图形API(如OpenGL/DirectX)进行图形渲染的限制,允许开发者使用拓展的C/C++语法,直接操作底层GPU线程、线程块和网格,将GPU转化为通用计算引擎。
7.1 OpenCV封装
在实际的企业级开发中,纯手工编写底层的CUDA Kernel函数(管理线程同步、共享显存分配等)开发成本极高。
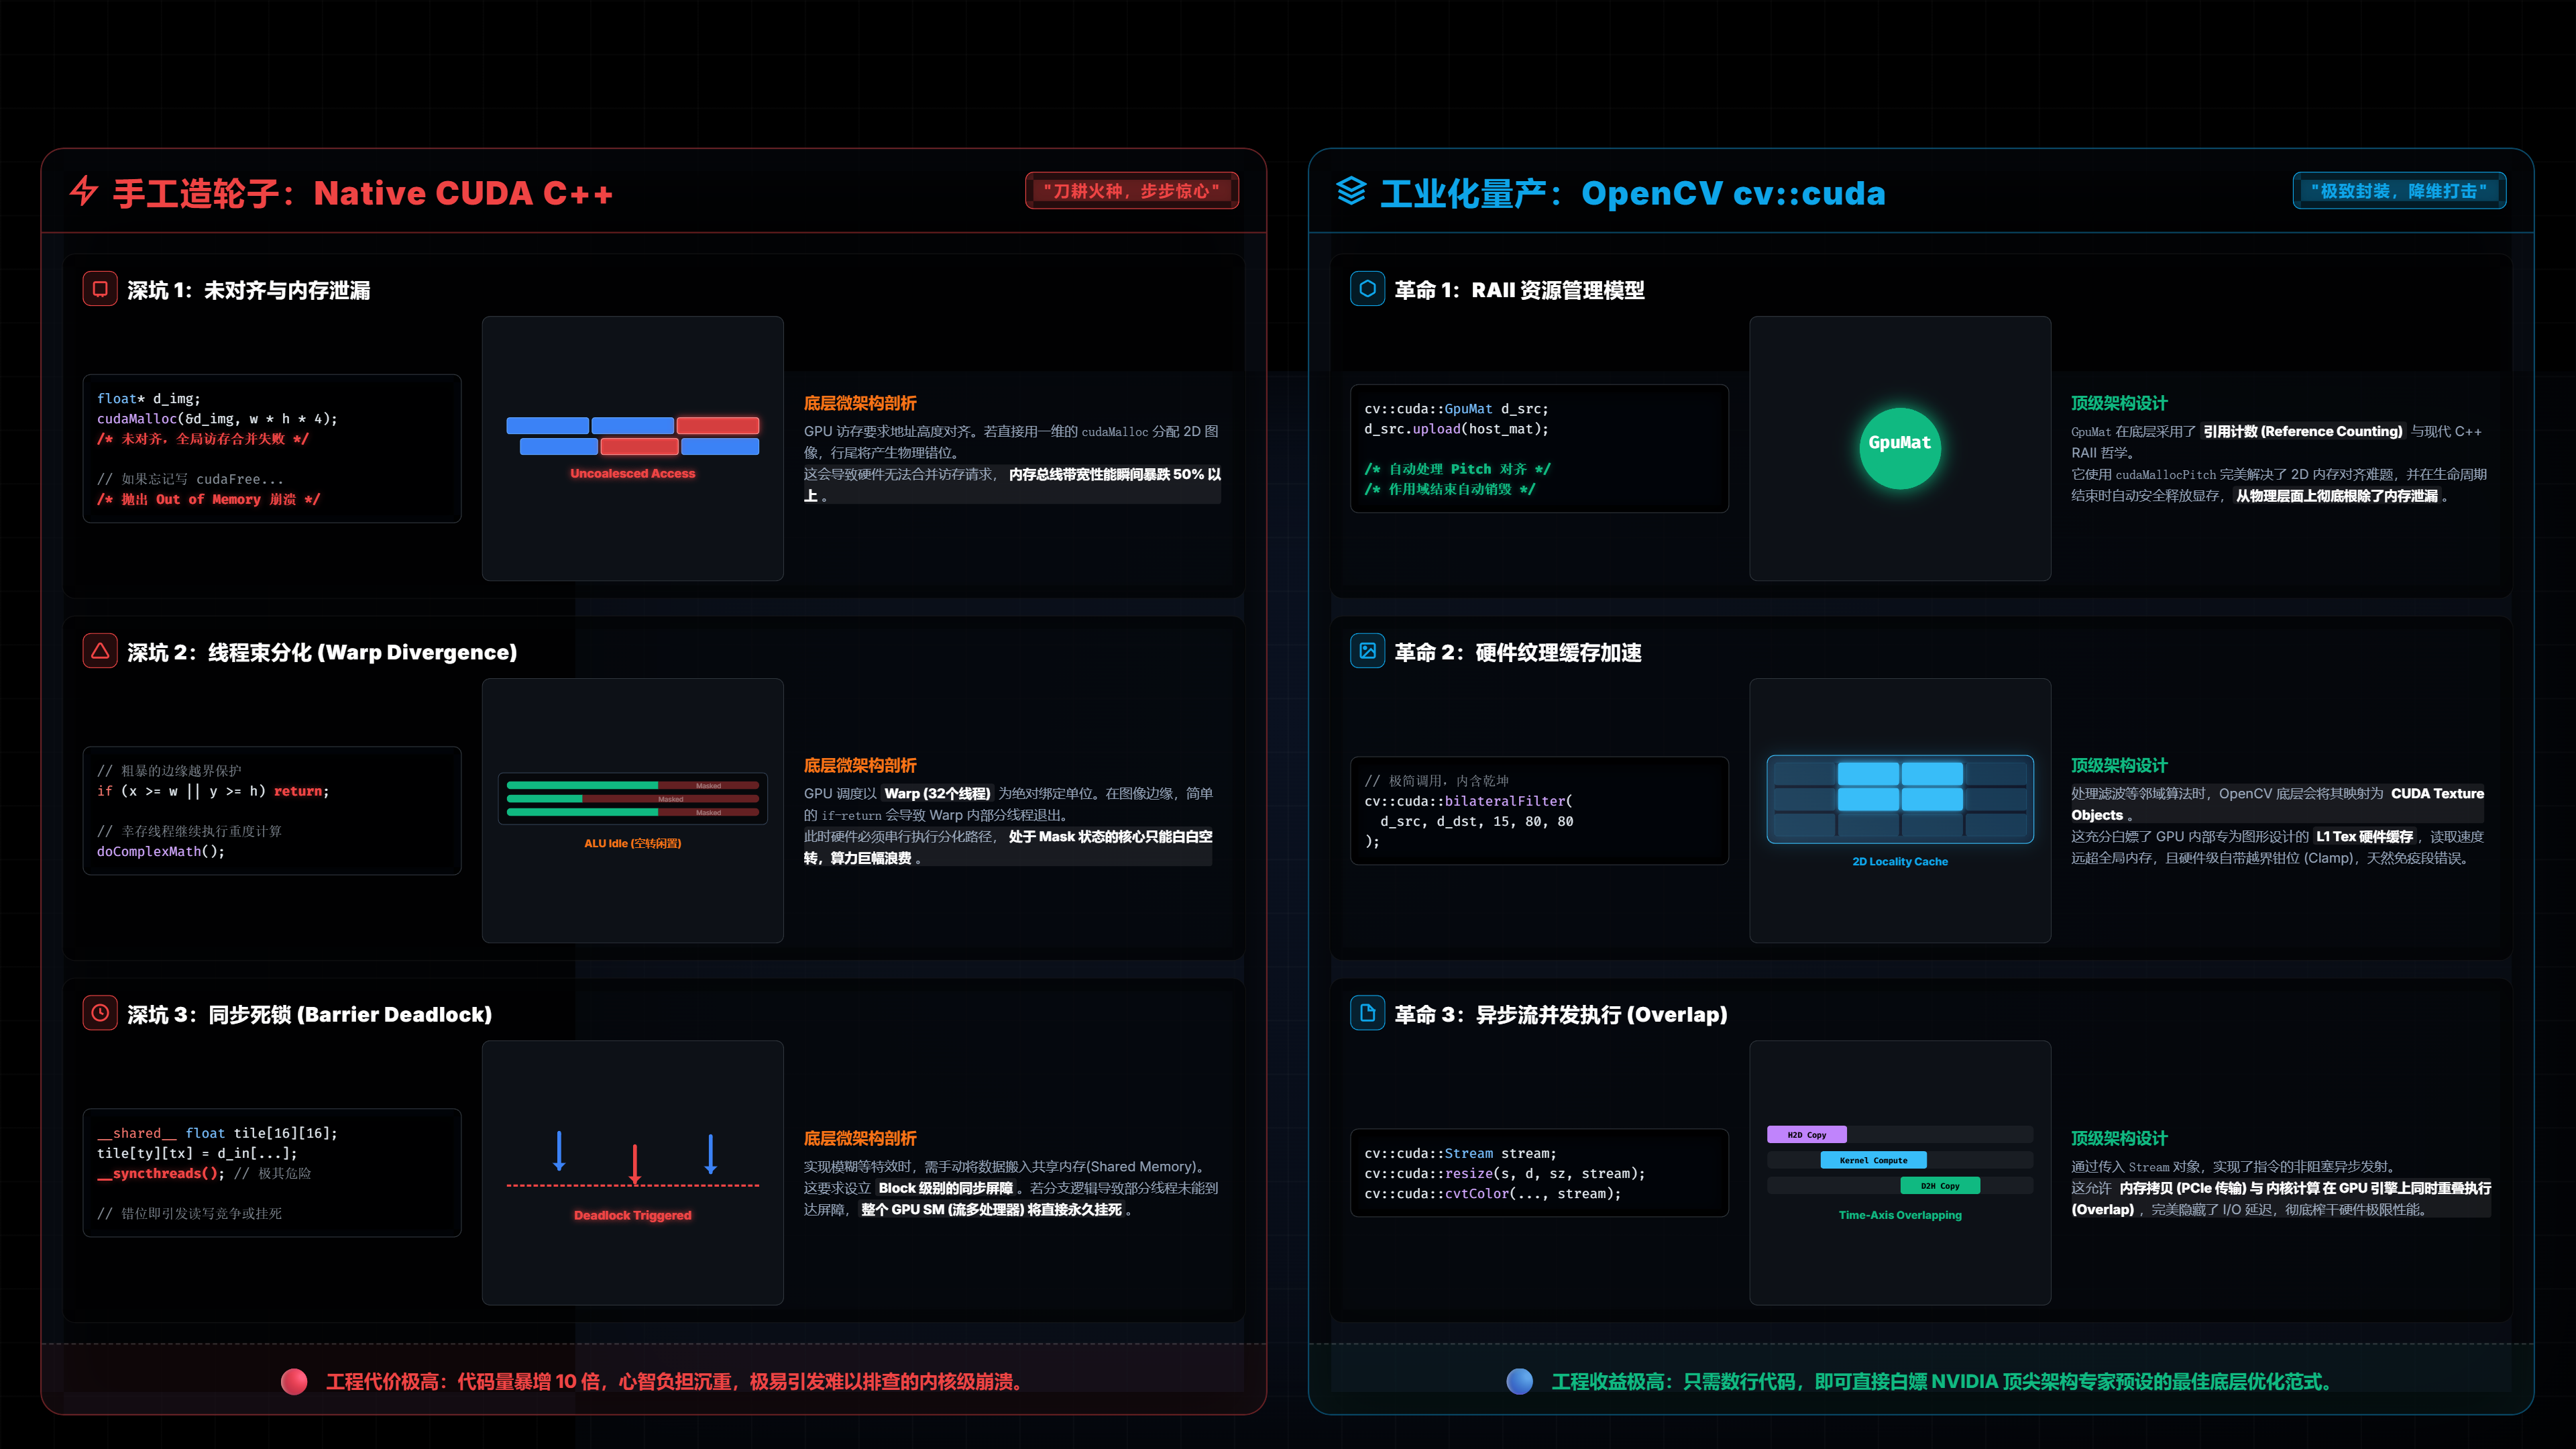
本项目采取了更加成熟的方案:利用OpenCV提供的cv::cuda模块。在接口设计中,定义了重载process(cv::cuda::GpuMat&img)虚函数。底层复杂的CUDA线程调度均由OpenCV完成封装,开发者只需要对显存数据结构(GpuMat)调用相应的滤波器或算子,即可轻松激活万核并行计算能力。
7.2 显存屏障与传输瓶颈
尽管GPU计算能力惊人,但在CPU与GPU协同工作(异构计算)时,存在一个极容易被忽略的性能陷阱:PCle总线数据屏障。
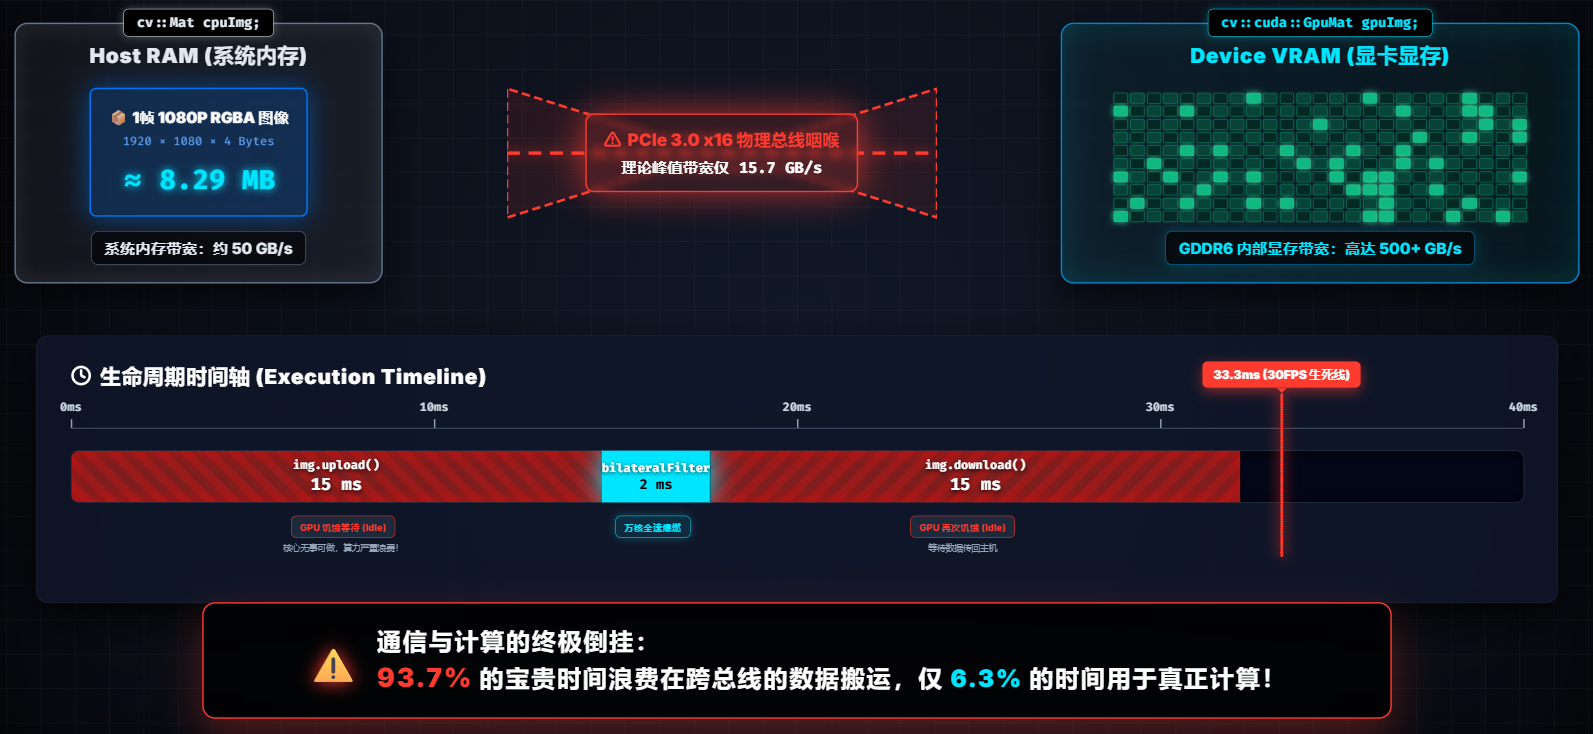
- 理论分析:当我们在代码中调用img.upload(cpuImg)将视频帧推送到GPU,或调用img.download(cpuImg)将渲染结果拉回CPU时,数据必须串行通过PCle总线。相较于GPU内部高达数百GB/s的显存带宽,PCle总线的带宽(通常不足20GB/s)极其有限。
- 性能陷阱:如果为了一次极其轻量的像素运算,将整帧1080P数据传入GPU。计算完成后传回,其 “通信耗时” 将远远大于“计算节省的时间” 。这回导致系统整体帧率不升反降。
7.3 最小化传输策略
为了跨越这一屏障,优秀的架构设计必须遵循“**计算向数据靠拢,最小化数据搬运”**的原则。
在本项目中,我们通过两层机制进行了深度优化:
全链路GPU驻留:
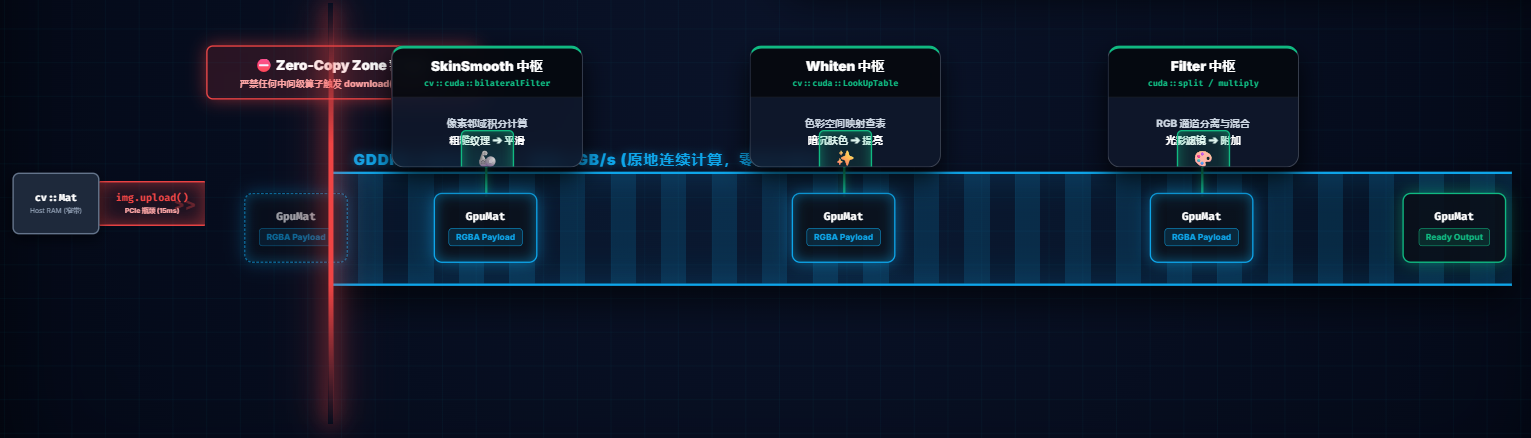 一旦图像进入显存管线,尽可能让所有特效(磨皮、美白、滤镜)按顺序直接在GpuMat上连续处理,拒绝中间环节的频繁下传。
ROI(Region of Interest)混合裁剪:
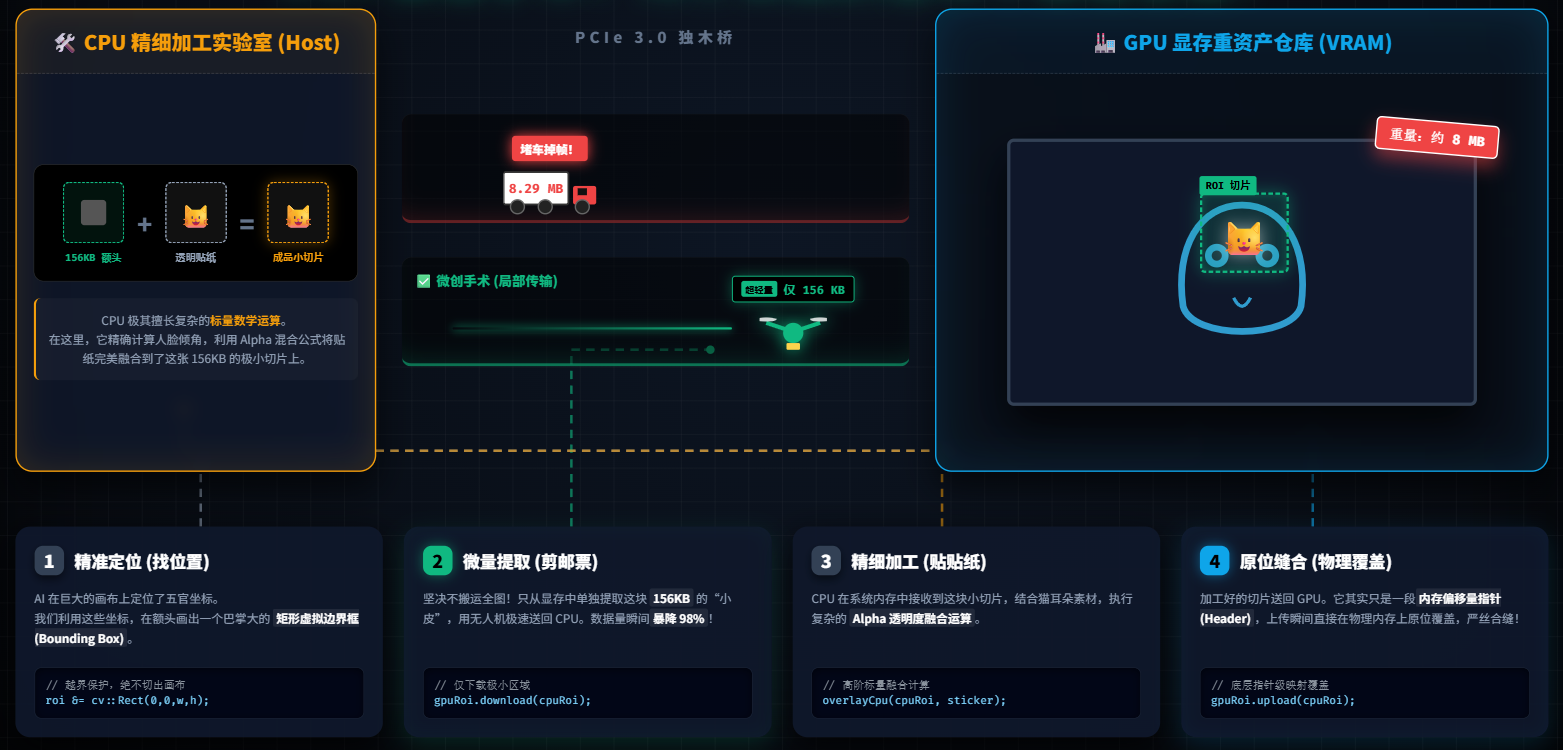 当遇到高度依赖CPU复杂数学逻辑的特效(根据人脸关键点进行贴纸的旋转计算和矩阵混合)时,我们不下载全图。例如在特效贴纸(StickerEffect)和瘦脸特效(FaceReshapeEffect)中,代码现在CPU端计算出极小的目标矩阵区域(cv::Rect roi),随后利用gpuRoi.download(cpuRoi)将这块极小的局部数据传回给CPU进行复杂处理,完成后再局部覆盖回显存。这极大限度地规避了PCle的带宽瓶颈。
7.4 代码实现
当遇到GPU不好写的逻辑时,如何进行CPU/GPU混合处理。
- 空间变换与网格映射(代码走读FaceReshapeEffect瘦脸大眼):
- 大眼和瘦脸的本质:坐标重映射(Remap)。
- 架构巧思:为什么网格(MapX/MapY)的复杂数学生成逻辑放在CPU做,而最终的cv::cuda::remap像素映射交由GPU做?(发挥各自特长)
void FaceReshapeEffect::process(cv::cuda::GpuMat& img) {
   if (!m_face.hasFace) return;

   // 【步骤 1:发挥 CPU 特长】在 CPU 上计算网格 (数学运算 CPU 单核足矣,且逻辑复杂不适合手写 CUDA Kernel)
   updateMaps(img.cols, img.rows);
   // 注:updateMaps 内部调用了经过 SIMD 优化的 warpLocal 函数,更新 m_mapXCpu 和 m_mapYCpu

   // 【步骤 2:跨越屏障】上传计算好的轻量级坐标网格到 GPU 显存
   m_mapXGpu.upload(m_mapXCpu);
   m_mapYGpu.upload(m_mapYCpu);

   // 【步骤 3:发挥 GPU 特长】GPU Remap (极快),利用万核算力瞬间完成全图 1080P 像素的插值重绘
   cv::cuda::remap(img, img, m_mapXGpu, m_mapYGpu, cv::INTER_LINEAR, cv::BORDER_REFLECT_101);
}
- ROI(Region of Interest)的极致裁剪:
第一步:在GPU上计算好紧凑的ROI区域,严格限制越界
    // 计算包围嘴唇的最小矩形区域
    int x1 = std::max(0, (int)(center.x - width - 10));
    int y1 = std::max(0, (int)(center.y - height - 10));
    int x2 = std::min(img.cols, (int)(center.x + width + 10));
    int y2 = std::min(img.rows, (int)(center.y + height + 10));

    cv::Rect roi(x1, y1, x2 - x1, y2 - y1);
    roi &= cv::Rect(0, 0, img.cols, img.rows); // 安全防御:防止越出 1080P 画布
    if(roi.width <= 0 || roi.height <= 0) return;
第二步:仅将这块极小的区域download到CPU
    // 下载 ROI 到 CPU 处理
    cv::cuda::GpuMat gpuRoi(img, roi); // 划定 GPU 上的感兴趣区域(不发生拷贝,仅偏移指针)
    cv::Mat cpuRoi;
    gpuRoi.download(cpuRoi); // 核心妥协:仅下载这一小块“嘴唇”,极大节省了 PCIe 传输带宽
第三步:在CPU端利用OpenCV的基础函数完成复杂数学计算与Alpha混合
    // 绘制 Mask (利用 CPU 端成熟的 cv::ellipse 和 cv::GaussianBlur 逻辑)
    cv::Mat mask = cv::Mat::zeros(cpuRoi.size(), CV_8UC1);
    cv::Point2f localCenter(center.x - roi.x, center.y - roi.y);
    cv::ellipse(mask, localCenter, cv::Size(width, height), 0, 0, 360, cv::Scalar(255), -1);
    cv::GaussianBlur(mask, mask, cv::Size(15, 15), 0);

    // Alpha 混合: Out = Src * (1 - alpha) + Overlay * alpha
    float alpha = m_lipstickLevel / 200.0f;
    for(int y=0; y<cpuRoi.rows; y++) {
        uchar* mPtr = mask.ptr<uchar>(y);
        cv::Vec4b* iPtr = cpuRoi.ptr<cv::Vec4b>(y); // BGRA
        for(int x=0; x<cpuRoi.cols; x++) {
            if (mPtr[x] > 0) {
                float k = (mPtr[x]/255.0f) * alpha;
                iPtr[x][1] = cv::saturate_cast<uchar>(iPtr[x][1] * (1-k*0.5)); // 降低绿通道
                iPtr[x][2] = cv::saturate_cast<uchar>(std::min(255.0f, iPtr[x][2] + 50.0f * k + iPtr[x][2]*k)); // 提亮红通道
            }
        }
    }
第四步:upload贴回GPU原图,完成微创手术
    // 完美缝合:将处理好的小图直接覆盖回 GPU 原图的 roi 坐标位置
    gpuRoi.upload(cpuRoi);