1. 先搞清楚:我们要做一件什么事
想象你在做一个直播工具:画面里要同时出现你的摄像头、你的电脑屏幕、以及一张背景图。这三样东西最终要"叠"成一张完整的画面,然后一方面显示给用户看,另一方面编码后推流或录制成文件。
这整个过程,就是一条渲染管线(Rendering Pipeline)。“管线"这个词的意思是:数据像水一样,从一个环节流向下一个环节,环环相扣。
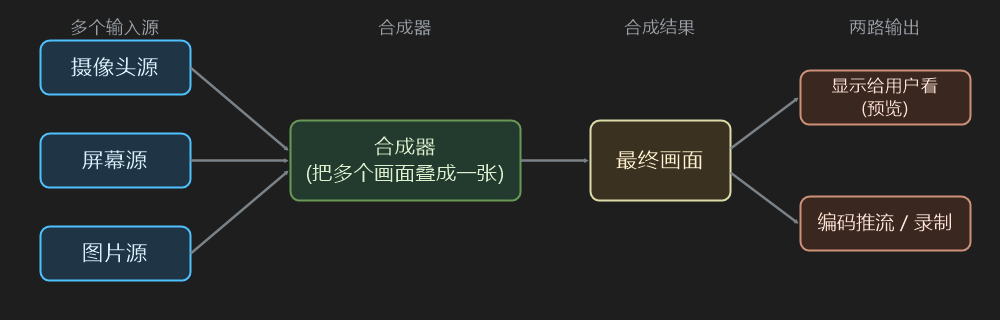
首先要讲清楚三件事,正好对应管线里的三个关键环节:
- 纹理池缓冲区:源和合成器之间如何"传递画面”,以及为什么需要一个缓冲。
- 图像混合:合成器怎么把多个画面叠成一张。
- 合成输出层:合成好的那一张画,如何变成用户能看到的预览、以及编码器能吃的格式。
在正式进入这三个环节之前,必须先补一些最基础的概念,否则后面会看不懂。
2. 预备知识:帧、纹理、GPU 与智能指针
这一节是地基,每个概念我都会在第一次出现时用粗体标注并解释,后面不再重复。
2.1 帧(Frame)与像素(Pixel)
帧(Frame):视频本质上是一连串快速切换的静止图片。每秒钟切换 30 次,就是"30 帧每秒",记作 30fps(Frames Per Second)。每一张静止图片,就叫一帧。
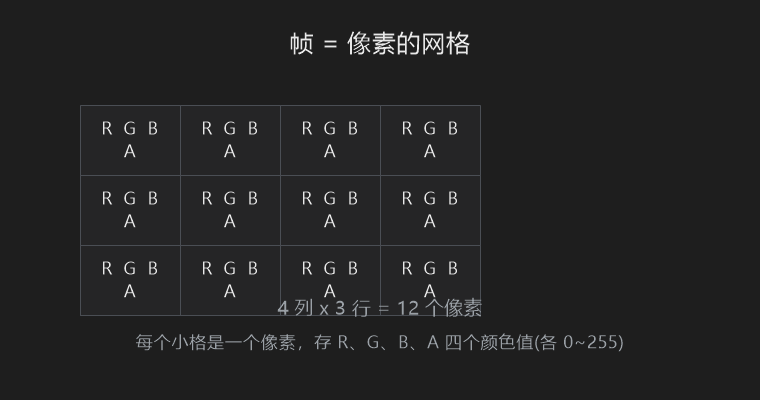
像素(Pixel):一帧画面是一个由很多小方块组成的网格,每个小方块就是一个像素。一张 1920×1080 的画面,就是横向 1920 个、纵向 1080 个像素,一共约 207 万个像素。
每个像素要记录自己的颜色。最常用的一种记法是 RGBA:R(Red 红)、G(Green 绿)、B(Blue 蓝)、A(Alpha 透明度)。四个值各占 8 位(一个字节,取值 0~255)。
2.2 CPU 与 GPU:两个不同的"工人"
CPU(Central Processing Unit,中央处理器):电脑的"大脑",擅长处理复杂、有逻辑分支的任务,但一次能同时做的事不多(核数有限)。
GPU(Graphics Processing Unit,图形处理器):显卡上的"大力士",核心数量极多(成百上千),擅长"同时做大量简单重复的计算"。给 207 万个像素做颜色变换,GPU 能一瞬间并行完成,而 CPU 一个个算会很慢。
一条重要原则:画面相关的大量计算,尽量交给 GPU 并行做。本文后面你会反复看到"在 GPU 内完成转换",原因就在这。
2.3 纹理(Texture):GPU 内存里的一帧画面
纹理(Texture):GPU 的显存(显卡自带的内存)里,用来存"一帧画面数据"的一块内存。在 Direct3D 11 里,二维纹理的类型是 ID3D11Texture2D。你可以把纹理理解为"活在显卡里的一张图"。
为什么要把画面放进 GPU?因为 GPU 要处理它(采样、混合、缩放),数据放在 GPU 自己的显存里,处理才最快。如果数据在 CPU 内存里,每次都要通过 PCIe 总线搬运,很慢。
2.4 D3D11:程序用来指挥 GPU 的"遥控器"
Direct3D 11(简称 D3D11):微软提供的一套图形 API(Application Programming Interface,应用程序编程接口)。API 可以理解为"别人写好的、你可以调用的功能集合"。通过 D3D11,程序可以创建纹理、创建渲染目标、调用着色器、执行绘制等,从而指挥 GPU 干活。
D3D11 里有三个特别重要的对象:
- Device(设备),类型
ID3D11Device:负责"创建"各种资源(纹理、着色器、状态对象)。 - Context(上下文),类型
ID3D11DeviceContext:负责"执行"绘制、复制、绑定等命令。可以理解为"下达命令的手"。 - 交换链(Swap Chain):负责把画好的画面"呈现"到屏幕上。
2.5 视图(View):同一块数据的"读写权限"
这是一个新手最容易困惑的点,请仔细看。
视图(View) 是对 GPU 资源的"访问接口"。同一块纹理,可以有两种不同的"看"法:
- SRV(ShaderResourceView,着色器资源视图):表示"这块纹理可以读"。着色器(见 2.7)采样纹理时,用的是 SRV。
- RTV(RenderTargetView,渲染目标视图):表示"这块纹理可以写"。GPU 把画面"画进去"时,用的是 RTV。
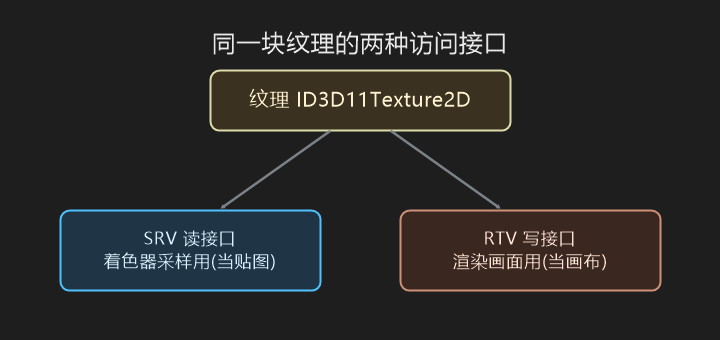
为什么要拆开?因为 GPU 有一条铁律:同一块纹理,不能同时一边写一边读(会产生数据冲突)。把读写分开成不同的"视图",D3D11 就能明确知道你现在想干什么。
2.6 ComPtr:会自动"回收"的智能指针
在 C++ 里,手动管理内存很容易出错(忘释放 → 内存泄漏;提前释放 → 崩溃)。D3D11 的对象都是 COM 对象(Component Object Model,微软的一种组件规范),它们靠"引用计数"来管理生命周期:
- 每多一个人使用它,计数 +1;
- 每少一个人使用它,计数 -1;
- 计数归零时,对象自动销毁。
ComPtr(COM 智能指针) 是封装了这个计数逻辑的工具(Microsoft::WRL::ComPtr<T>)。你把它当成普通指针用,但它会在"不再被需要"时自动帮你做 -1 的操作,不用手动释放。本文代码里到处是 ComPtr<ID3D11Texture2D>,意思就是"一个会自动管理的纹理智能指针"。
一句话总结:ComPtr 让你像用普通指针一样用 D3D11 对象,却不用操心"什么时候该释放"。
2.7 着色器(Shader):跑在 GPU 上的"小程序"
着色器(Shader):一段运行在 GPU 上的小程序,用来告诉 GPU"每个顶点/每个像素该怎么算"。它用 HLSL(High-Level Shading Language,一种类似 C 的着色器语言)编写。
本文涉及两种:
- 顶点着色器(Vertex Shader):处理"顶点"(图形的顶点位置),可以做旋转、缩放、坐标变换。
- 像素着色器(Pixel Shader,也叫片元着色器):处理"像素",决定每个像素最终显示什么颜色(比如采样纹理的颜色、做颜色空间转换)。
D3D11 里,程序先用 D3DCompile 把 HLSL 文本编译成 GPU 能执行的字节码,再用 Device 创建出着色器对象(ID3D11VertexShader / ID3D11PixelShader),绘制时绑定到 Context 上即可。
2.8 线程、锁与生产者—消费者
线程(Thread):程序里一条独立的"执行流"。一个程序可以有多个线程同时跑。比如一个线程专门采集画面,另一个线程专门合成画面。
互斥锁(Mutex):多个线程如果同时读写同一份数据,会"打架"(数据错乱甚至崩溃)。互斥锁是一把"门锁":谁先拿到锁谁先进去操作,操作完出来再解锁,别人才能进去。C++ 里常用 std::mutex + std::lock_guard:
// lock_guard 是"自动上锁/解锁"的辅助工具:
// 它构造时自动 lock(上锁),离开作用域时自动 unlock(解锁)。
{
    std::lock_guard<std::mutex> lock(m_mutex); // 上锁,别的线程在外面等
    // ... 在这里安全地读写共享数据 ...
} // 离开这个花括号,lock_guard 析构,自动解锁
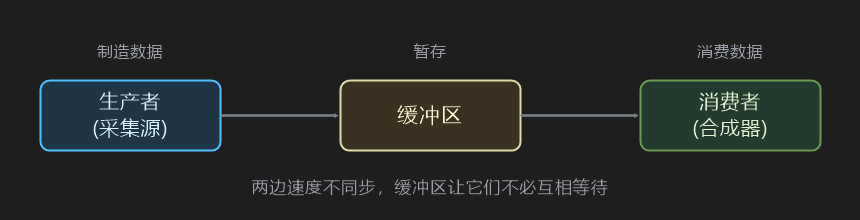
生产者—消费者模型:一个经典的多线程协作场景。生产者负责"制造"数据(比如采集画面),消费者负责"消费"数据(比如合成画面)。两者速度往往不一样——生产者可能一秒产 60 帧,消费者可能一秒只能处理 30 帧——所以中间需要一块缓冲区来"暂存"数据,让双方不必互相等待。
3. 纹理池缓冲区:生产者与消费者之间的"中转站"
3.1 为什么需要一个"池子"?
回顾生产者—消费者模型。在本文的场景里:
- 生产者:采集源(摄像头、屏幕、视频文件),它不断产出新帧。
- 消费者:合成器(下一节的主角
SceneCompositor),它按自己的节奏(比如 25fps)取帧去合成。
问题来了:如果生产者"推"一帧过来,消费者刚好没空接,这一帧就丢了;如果两边直接共享同一块内存又没加锁,就会数据错乱。所以需要一个专门的缓冲结构,负责:
- 安全地接收生产者送来的帧;
- 安全地让消费者取走"最新的一帧";
- 管理这些帧的生命周期(什么时候该释放显存)。
这个结构,就是 纹理池(TexturePool)。它本身是一块跨线程共享的内存区,用 std::mutex 严格保护。
3.2 整体结构:一个"按 id 查找"的池子
TexturePool 是一个单例(Singleton)——全局只有一个实例,任何人通过 TexturePool::instance() 拿到它(见 2.9 提到的单例,instance() 是获取这个唯一实例的函数)。
它内部用一张 std::map 来管理数据,键是每个源的唯一 id,值是一个"池节点":
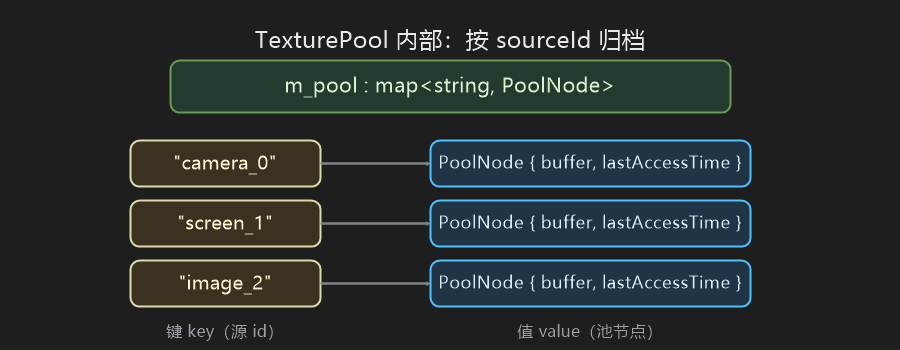
对应真实代码(TexturePool.h):
class TexturePool {
public:
    // 获取全局唯一实例(单例)
    static TexturePool& instance();

    // 生产者调用:把一帧纹理"推进"池子
    void updateTexture(const std::string& sourceId, ID3D11Texture2D* texture,
                       BufferStrategyType strategy = BufferStrategyType::SwapChain);

    // 消费者调用:从池子里"取走"最新一帧
    Microsoft::WRL::ComPtr<ID3D11Texture2D> acquireTexture(const std::string& sourceId);

    // 生命周期管理:删除某个源、清理超时未使用的纹理
    void removeSource(const std::string& sourceId);
    void cleanupUnused(long long currentTimeMs);

private:
    // 池节点:每个源对应一个缓冲 + 一个"最后访问时间"
    struct PoolNode {
        std::shared_ptr<ITextureBufferStrategy> buffer; // 具体的缓冲策略(见 3.3)
        long long lastAccessTime = 0;                   // 最后访问时间戳,用于超时回收
        BufferStrategyType strategyType;                // 用哪种策略
    };

    std::map<std::string, PoolNode> m_pool; // 键值对:id -> 节点
    std::mutex m_mutex;                     // 互斥锁,保护 m_pool 不被多线程同时改
};
注释说明:
std::string sourceId:源的唯一标识字符串(如"camera_0"),用来区分不同的源。ID3D11Texture2D* texture:一个纹理指针(见 2.3),代表一帧画面。long long:64 位整数,这里用来存时间戳(从某个起点到现在的毫秒数)。BufferStrategyType:一个枚举,表示用哪种缓冲策略。
3.3 两种缓冲策略:单缓冲 vs 环形缓冲
不同源的特点不同,池子提供了两种策略,通过策略模式抽象出来。策略模式的意思是:把"可以替换的行为"抽成一个接口,让上层不用关心具体用的是哪种实现。
接口 ITextureBufferStrategy(TexturePool.h):
class ITextureBufferStrategy {
public:
    virtual ~ITextureBufferStrategy() = default;
    virtual void push(ID3D11Texture2D* texture) = 0;                  // 存一帧
    virtual Microsoft::WRL::ComPtr<ID3D11Texture2D> peek() = 0;       // 取最新一帧
    virtual void clear() = 0;                                          // 清空
};
注释说明:virtual ... = 0; 是 C++ 的"纯虚函数"语法,表示"这个类只定义接口,不实现,具体怎么做由子类决定"。peek() 这个词是"偷看一眼"的意思,指取出来看但通常不销毁原数据。
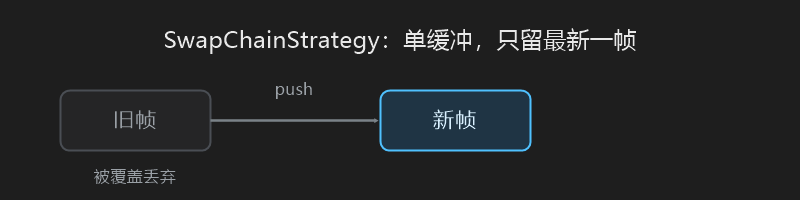
策略一:SwapChainStrategy(单缓冲,只留最新一帧)
class SwapChainStrategy : public ITextureBufferStrategy {
public:
    void push(ID3D11Texture2D* texture) override {
        if (!texture) return;                       // 空指针直接返回,防止崩溃
        std::lock_guard<std::mutex> lock(m_mutex);  // 上锁
        m_frontBuffer = texture;                    // 直接覆盖,只保留最新一帧
    }

    ComPtr<ID3D11Texture2D> peek() override {
        std::lock_guard<std::mutex> lock(m_mutex);
        return m_frontBuffer;                       // 返回最新一帧
    }

    void clear() override {
        std::lock_guard<std::mutex> lock(m_mutex);
        m_frontBuffer.Reset();                      // 释放底层纹理
    }

private:
    std::mutex m_mutex;
    ComPtr<ID3D11Texture2D> m_frontBuffer;          // 只存一个"前缓冲"
};
注释说明:
override:C++ 关键字,表示"这个函数重写了父类的虚函数",编译器会帮你检查有没有写错。m_frontBuffer = texture:因为m_frontBuffer是ComPtr,赋值会自动增加引用计数(防止纹理被提前释放),旧的那帧则自动释放。- 这种策略只留最新一帧,适合"画面不会过期、只要最新"的场景(比如静态图片)。
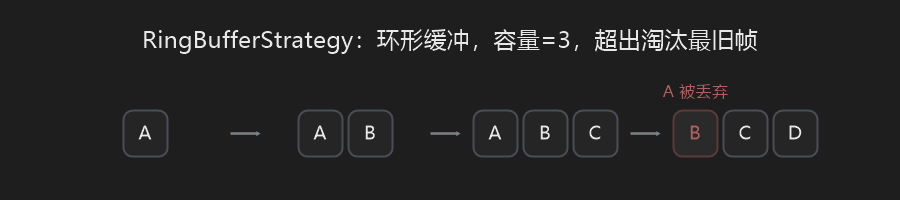
策略二:RingBufferStrategy(环形缓冲,留最近 N 帧)
class RingBufferStrategy : public ITextureBufferStrategy {
public:
    RingBufferStrategy() {
        m_capacity = AppConfig::instance()->ringBufferSize(); // 从配置读取容量
        if (m_capacity < 1) m_capacity = 3;                   // 兜底:至少 3 帧
    }

    void push(ID3D11Texture2D* texture) override {
        if (!texture) return;
        std::lock_guard<std::mutex> lock(m_mutex);
        m_buffer.push_back(texture);             // 加到队尾
        if (m_buffer.size() > m_capacity) {      // 超过容量
            m_buffer.erase(m_buffer.begin());    // 删掉最旧的一帧
        }
    }

    ComPtr<ID3D11Texture2D> peek() override {
        std::lock_guard<std::mutex> lock(m_mutex);
        if (m_buffer.empty()) return nullptr;    // 空则返回空指针
        return m_buffer.back();                  // 返回最新(队尾)的一帧
    }

    void clear() override {
        std::lock_guard<std::mutex> lock(m_mutex);
        m_buffer.clear();                        // 清空所有帧
    }

private:
    std::mutex m_mutex;
    std::vector<ComPtr<ID3D11Texture2D>> m_buffer; // 存放多帧的动态数组
    size_t m_capacity;                              // 最大容量
};
注释说明:
m_buffer.push_back(texture):把新帧加到vector末尾。m_buffer.erase(m_buffer.begin()):begin()指向第一个元素(最旧的),erase删除它。m_buffer.back():取最后一个元素(最新的)。- 这种策略保留最近 N 帧,适合"帧率可能不稳、需要一点缓冲余量"的动态源(比如摄像头、视频)。
3.4 池子的核心操作:存入、取出、回收
存入 updateTexture
void TexturePool::updateTexture(const std::string& sourceId,
                                ID3D11Texture2D* texture,
                                BufferStrategyType strategy) {
    if (sourceId.empty() || !texture) return;      // 参数校验,无效直接返回

    std::lock_guard<std::mutex> lock(m_mutex);     // 全程上锁,保护 m_pool
    long long now = QDateTime::currentMSecsSinceEpoch(); // 当前时间戳(毫秒)

    auto it = m_pool.find(sourceId);               // 在 map 里查找这个 id
    if (it == m_pool.end()) {                       // end() 表示"没找到"
        // 第一次见到这个源:新建一个节点
        PoolNode node;
        node.lastAccessTime = now;
        node.strategyType = strategy;
        if (strategy == BufferStrategyType::SwapChain) {
            node.buffer = std::make_shared<SwapChainStrategy>();   // 单缓冲
        } else {
            node.buffer = std::make_shared<RingBufferStrategy>();  // 环形缓冲
        }
        m_pool[sourceId] = node;                    // 把节点存进 map
        it = m_pool.find(sourceId);
    }

    if (it != m_pool.end() && it->second.buffer) {
        it->second.lastAccessTime = now;            // 更新最后访问时间
        it->second.buffer->push(texture);           // 真正把帧推进去
    }
}
注释说明:
m_pool.find(sourceId):在 map 里查找键sourceId,返回一个"迭代器"it(可以理解为"指向某个元素的游标");找不到时返回m_pool.end()(一个表示"末尾/不存在"的特殊位置)。it->second:迭代器指向的是"键值对",.first是键(id),.second是值(PoolNode)。std::make_shared<T>():创建一个shared_ptr智能指针管理的对象。
取出 acquireTexture
ComPtr<ID3D11Texture2D> TexturePool::acquireTexture(const std::string& sourceId) {
    std::lock_guard<std::mutex> lock(m_mutex);
    auto it = m_pool.find(sourceId);
    if (it != m_pool.end() && it->second.buffer) {
        it->second.lastAccessTime = QDateTime::currentMSecsSinceEpoch(); // 更新访问时间
        return it->second.buffer->peek();   // 取最新一帧(安全拷贝)
    }
    return nullptr;                          // 没找到,返回空指针
}
注释说明:注意它返回的是 ComPtr(不是裸指针),这很关键——返回时引用计数 +1,保证调用者拿着它使用的期间,纹理不会被别人释放。
超时回收 cleanupUnused
void TexturePool::cleanupUnused(int64_t currentTimeMs) {
    std::lock_guard<std::mutex> lock(m_mutex);
    // 遍历 map,边遍历边删除(注意 it 的推进方式)
    for (auto it = m_pool.begin(); it != m_pool.end(); ) {
        if (currentTimeMs - it->second.lastAccessTime > 5000) { // 超过 5 秒没被访问
            it->second.buffer.reset();      // 释放底层 D3D 资源(防止显存泄漏)
            it = m_pool.erase(it);          // 从 map 中移除,并让 it 指向下一个
        } else {
            ++it;                            // 没超时,正常往后走
        }
    }
}
注释说明:
currentTimeMs - lastAccessTime > 5000:当前时间减去最后访问时间,超过 5000 毫秒(5 秒)就认为是"没人用的旧纹理"。buffer.reset():清空智能指针,触发底层纹理释放。- 为什么要这个?因为如果某个源被删掉了,池子里还留着它的显存不释放,时间长了显存会被吃光(显存泄漏)。
小结(一句话比喻):纹理池就像快递驿站——采集源是快递员,把"包裹"(纹理)按编号(sourceId)放进货架(map),合成器是取件人,按编号取走最新那个包裹;久无人取的包裹,驿站会在 5 秒后自动清掉腾地方。
4. 图像混合:把多个图层拼成一张画
4.1 主角:合成器 SceneCompositor
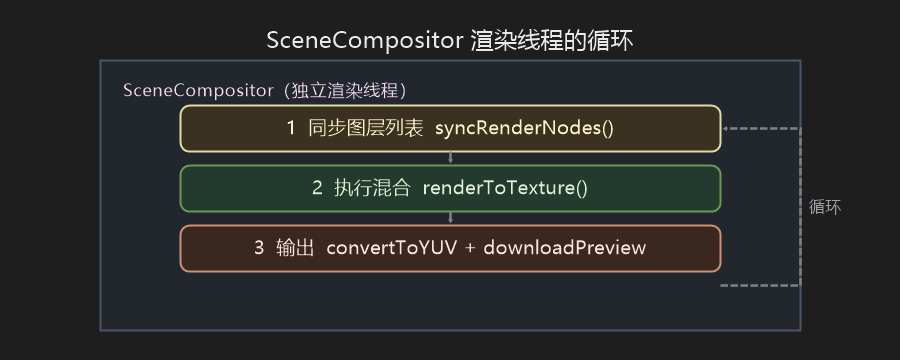
SceneCompositor(场景合成器) 是消费者,也是整条管线的"大脑"。它在一个独立的高优先级渲染线程里跑一个死循环(renderLoop),按设定帧率(比如 25fps 或 30fps)不停地把当前所有源"合成"成一张画面。
先看它持有的关键成员(SceneCompositor.h):
class SceneCompositor : public QObject {   // QObject 是 Qt 框架的基类,提供"信号/槽"机制(见 5.4)
    // ...只看关键部分
    struct RenderNode {          // "渲染节点":一个源在画布上的摆放信息
        std::string sourceId;    // 对应哪个源
        float x, y, w, h;        // 位置 (x,y) 和尺寸 (w,h)
        float rotation;          // 旋转角度
        int zOrder;              // 层级(谁盖在谁上面)
        float opacity;           // 透明度
    };
    std::vector<RenderNode> m_renderList; // 渲染列表:一份"图层树"的快照

    std::mutex m_renderMutex;             // 专门保护 m_renderList 的锁

    // 离屏画布:GPU 里一张专门用来"画"的纹理,以及它的读/写接口
    Microsoft::WRL::ComPtr<ID3D11RenderTargetView> m_mainRTV;       // 写接口(画布)
    Microsoft::WRL::ComPtr<ID3D11ShaderResourceView> m_mainSRV;     // 读接口
    Microsoft::WRL::ComPtr<ID3D11Texture2D> m_mainTex;              // 画布本体
    // ...
};
注释说明:
float:单精度浮点数(小数),用来存坐标、缩放等可能带小数的值。struct:C++ 里定义一个"把多个相关变量打包在一起"的结构体。RenderNode就打包了一个源的全部摆放信息。- 离屏画布(Offscreen Canvas):不在屏幕上直接显示,而是在 GPU 显存里开辟的一张"草稿纸"纹理。所有源都画到这张草稿纸上,画完再整体输出。
4.2 第一步:锁定图层列表(syncRenderNodes)
UI 线程可以随时增删源、改位置,而渲染线程要读这些信息。如果两边同时读写同一份数据就会崩溃。解决办法:在锁的保护下,把图层信息快照一份,渲染线程只操作这份快照。
void SceneCompositor::syncRenderNodes() {
    std::lock_guard<std::mutex> lock(m_renderMutex); // 上锁,保护快照过程
    m_renderList.clear();                             // 清空旧的快照
    auto items = m_scene->getItems();                 // 拿到场景里所有"图层项"

    for (const auto& item : items) {                  // 遍历每个图层项
        auto source = item->getSource();              // 拿到这个图层背后的源
        if (source) {
            // ... 如果是动态源且有新帧,就把新帧推进纹理池
            if (source->hasNewFrame()) {              // hasNewFrame():判断是否有新帧
                TexturePool::instance().updateTexture(source->getSourceId(), tex.Get(), strategy);
                source->markFrameProcessed();          // 标记"这帧我已处理过"
            }

            // 构造渲染节点,记录这个源的摆放信息
            RenderNode node;
            node.sourceId = source->getSourceId();
            Transform t = item->getTransform();        // Transform:位置/缩放/旋转的集合
            node.x = t.x; node.y = t.y; node.w = t.width; node.h = t.height;
            node.rotation = t.rotation;
            node.zOrder = t.zOrder;
            node.opacity = 1.0f;
            m_renderList.push_back(node);              // 加入快照列表
        }
    }

    // 按层级 zOrder 从小到大排序(小的先画,大的后画,后画的盖在上面)
    std::sort(m_renderList.begin(), m_renderList.end(),
              [](const RenderNode& a, const RenderNode& b){ return a.zOrder < b.zOrder; });
}
注释说明:
for (const auto& item : items):C++ 的"范围 for 循环",逐个取出容器里的元素。auto让编译器自动推导类型。[](...){...}:Lambda 表达式(匿名函数),这里作为std::sort的"比较规则":告诉 sort"按zOrder从小到大排"。- zOrder(层级顺序):数值越大越靠上(后画)。排序后按顺序画,就能实现"背景在下、前景在上"的正确叠放。
这就是参考文档里说的"锁住 m_renderMutex,把图层树快照一份,确保 UI 怎么变都不会引起崩溃"。
4.3 第二步:执行混合(renderToTexture)
这一步是核心。它会清空离屏画布,然后逐个源把纹理"贴"到画布上。
void SceneCompositor::renderToTexture() {
    auto& dx11 = DX11Context::instance();            // 拿到全局唯一的 D3D11 上下文(见 4.5)
    float clearColor[4] = { 0.0f, 0.0f, 0.0f, 1.0f }; // 清屏颜色:黑色(R=0,G=0,B=0,A=1)

    dx11.beginScene(m_mainRTV.Get(), clearColor);    // ① 清空画布为黑色,并设为当前渲染目标

    std::vector<RenderNode> localList;
    {
        std::lock_guard<std::mutex> lock(m_renderMutex);
        localList = m_renderList;                    // ② 在锁内再快照一份,避免绘制中列表被改
    }

    // ③ 计算"逻辑坐标 -> 物理坐标"的缩放系数
    //    逻辑画布是场景的原始尺寸(如 1920×1080),
    //    但为了性能,编辑模式下物理画布可能缩到 1280×720。
    float scaleX = (float)m_canvasW / m_logicalW;
    float scaleY = (float)m_canvasH / m_logicalH;

    // ④ 遍历每个节点,逐个贴图
    for (const auto& node : localList) {
        // 从纹理池取这个源的最新一帧
        Microsoft::WRL::ComPtr<ID3D11Texture2D> tex =
            TexturePool::instance().acquireTexture(node.sourceId);

        if (tex) {
            // 拿到纹理的"描述"(宽高、格式等),宽高为 0 就跳过
            D3D11_TEXTURE2D_DESC desc;
            tex->GetDesc(&desc);
            if (desc.Width == 0 || desc.Height == 0) continue;

            // 创建临时 SRV(读接口),让着色器能采样这张纹理
            // ...(略去创建代码)...
            Microsoft::WRL::ComPtr<ID3D11ShaderResourceView> tempSRV;
            // ...

            // ⑤ 逻辑坐标换算成物理坐标(乘缩放系数)
            float renderX = node.x * scaleX;
            float renderY = node.y * scaleY;
            float renderW = node.w * scaleX;
            float renderH = node.h * scaleY;

            // ⑥ 调用 dx11.drawTexture 把这张纹理"贴"到画布上
            dx11.drawTexture(tempSRV.Get(),        // 要贴的纹理(读接口)
                             renderX, renderY,     // 贴到画布的哪个位置
                             renderW, renderH,     // 贴多大
                             node.rotation,        // 旋转角度
                             (float)m_canvasW, (float)m_canvasH); // 画布物理尺寸
        }
    }

    // ⑦ 解绑渲染目标(收尾,避免残留状态影响下一帧)
    ID3D11RenderTargetView* nullRTV[] = { nullptr };
    dx11.context()->OMSetRenderTargets(1, nullRTV, nullptr);
}
注释说明:
continue:跳过本轮循环剩余部分,直接进入下一次循环。OMSetRenderTargets:D3D11 的一个方法,设置"当前把画面渲染到哪个目标上"。传nullptr表示"解绑,不再渲染到任何目标"。- 这里体现了逻辑坐标与物理坐标的分离:场景里记录的坐标是"逻辑尺寸"(跟真实场景一致),实际渲染时按缩放系数映射到"物理画布"上。好处是:分辨率降级时不用改任何布局数据。
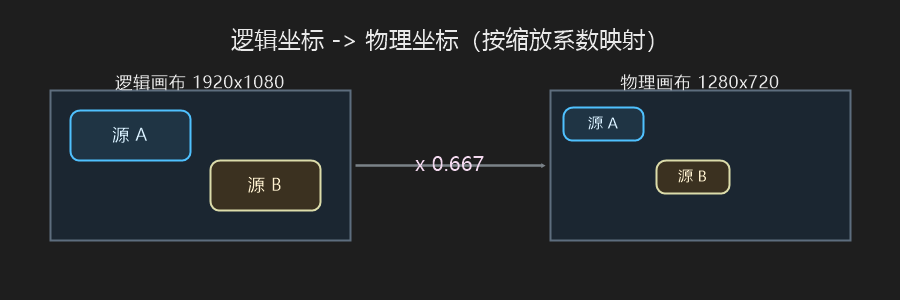
逻辑坐标乘以缩放系数(0.667 = 1280/1920),映射到物理画布。
4.4 逐层贴图如何"叠加":Alpha 混合
多个源叠在一起,上面的图如果完全不透明,就会把下面的完全盖住;如果半透明,就能透出下面的内容。这就是 Alpha 混合(Alpha Blending)——用像素的 Alpha(透明度)值,计算上下两层像素如何合成。
D3D11 里通过 混合状态(BlendState) 来配置这个规则。看 DX11Context 里的初始化代码(Core/DX11Context.cpp):
D3D11_BLEND_DESC bd = {};                              // 混合状态描述结构体
bd.RenderTarget[0].BlendEnable = TRUE;                 // 开启混合
bd.RenderTarget[0].SrcBlend  = D3D11_BLEND_SRC_ALPHA;       // 源因子 = 源像素的 Alpha
bd.RenderTarget[0].DestBlend = D3D11_BLEND_INV_SRC_ALPHA;  // 目标因子 = 1 - 源 Alpha
bd.RenderTarget[0].BlendOp   = D3D11_BLEND_OP_ADD;          // 混合运算 = 相加
// ...
m_device->CreateBlendState(&bd, &m_blendState);        // 创建这个混合状态对象
注释说明:这段配置的含义是——最终颜色 = 源颜色 × 源Alpha + 目标颜色 × (1 − 源Alpha)。当源 Alpha = 1(不透明),结果就是源颜色本身(完全盖住);当 Alpha = 0.5,就是上下各一半(半透)。
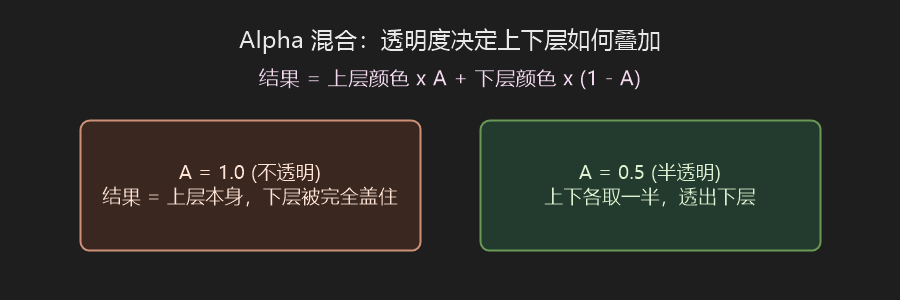
Alpha 混合。A 越接近 1,上层越"实";越接近 0,越"透"。
4.5 谁来真正执行绘制:DX11Context 与着色器
drawTexture 是真正"把一张纹理画到画布上"的函数。它内部调用 renderQuad(画一个矩形),并且会用到顶点着色器和像素着色器。
先看调用入口(DX11Context.cpp):
void DX11Context::drawTexture(ID3D11ShaderResourceView* srv,
                              float x, float y, float w, float h,
                              float rotation, float canvasW, float canvasH) {
    std::lock_guard<std::mutex> lock(m_mutex);       // 上锁,防止与别的 GPU 操作冲突
    if (!srv) return;

    m_context->PSSetShaderResources(0, 1, &srv);      // 把纹理的"读接口"交给像素着色器
    m_context->PSSetSamplers(0, 1, m_samplerLinear.GetAddressOf()); // 设置采样器(双线性)
    m_context->PSSetShader(m_ps.Get(), nullptr, 0);   // 绑定像素着色器(PS_Main)

    renderQuad(x, y, w, h, rotation, canvasW, canvasH); // 画一个矩形(顶点着色器干活)

    // 用完后解绑,防止影响后续
    ID3D11ShaderResourceView* nullSRV[] = { nullptr };
    m_context->PSSetShaderResources(0, 1, nullSRV);
}
注释说明:
PSSetShaderResources/PSSetSamplers/PSSetShader:名字里的PS是 Pixel Shader(像素着色器)。这些函数就是"把资源、采样器、着色器程序绑定到 GPU 管线上"。- 采样器(Sampler):决定"怎么从纹理里取颜色"(比如放大时用最近邻还是双线性插值)。这里用
m_samplerLinear(双线性,放大时更平滑)。
再来看着色器本体。这是 DX11Context.cpp 里一段 HLSL 代码(节选),顶点着色器负责"旋转 + 坐标变换":
// VS_Main:顶点着色器。输入一个顶点,输出它旋转后的位置。
PS_INPUT VS_Main(VS_INPUT input) {
    PS_INPUT output;

    // 1. 计算矩形中心点
    float centerX = x + w * 0.5;
    float centerY = y + h * 0.5;

    // 2. 计算当前顶点相对中心的偏移
    float localX = (input.pos.x - 0.5) * w;
    float localY = (input.pos.y - 0.5) * h;

    // 3. 角度转弧度(degrees * PI / 180)
    float rad = rotation * 0.0174532925f;
    float c = cos(rad);
    float s = sin(rad);

    // 4. 2D 旋转公式:绕中心旋转
    float rotatedX = localX * c - localY * s;
    float rotatedY = localX * s + localY * c;

    // 5. 移回绝对坐标
    float finalPixelX = centerX + rotatedX;
    float finalPixelY = centerY + rotatedY;

    // 6. 转成 NDC 坐标(-1 ~ 1,D3D 的标准坐标范围)
    float ndcX = (finalPixelX / canvasW) * 2.0f - 1.0f;
    float ndcY = 1.0f - (finalPixelY / canvasH) * 2.0f;

    output.pos = float4(ndcX, ndcY, 0.0f, 1.0f);
    output.tex = input.tex;     // 纹理坐标原样传给像素着色器
    return output;
}
注释说明:
input.pos/input.tex:输入结构体VS_INPUT里定义的两个字段,分别是顶点位置和纹理坐标。cos/sin:余弦/正弦,HLSL 内置的三角函数。float4:HLSL 里"4 个 float"的向量类型(类似 (x, y, z, w))。- NDC(Normalized Device Coordinates,归一化设备坐标):D3D 规定屏幕坐标范围是 -1 到 1(x 和 y)。所以最后要把像素坐标换算到这个范围。
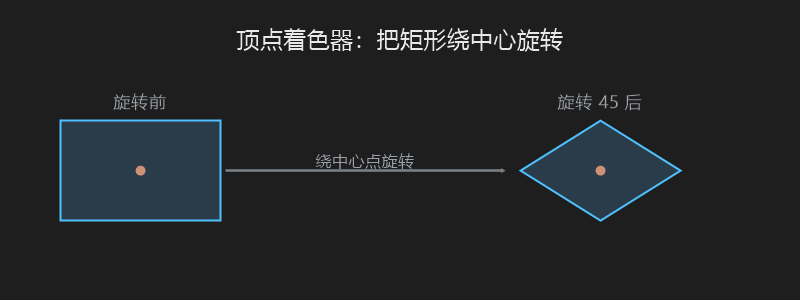
而像素着色器(PS_Main)就简单多了——它就是"从纹理采样一个颜色输出":
Texture2D tex : register(t0);          // 声明:外部绑定的纹理
SamplerState samLinear : register(s0); // 声明:外部绑定的采样器

// PS_Main:像素着色器。输入插值后的纹理坐标,输出这个像素的颜色。
float4 PS_Main(PS_INPUT input) : SV_Target {
    return tex.Sample(samLinear, input.tex); // 采样纹理,得到该点的颜色
}
注释说明:
Texture2D tex : register(t0):声明一个纹理变量tex,对应"寄存器槽位 t0"(前面PSSetShaderResources(0, 1, &srv)绑定的就是槽位 0)。tex.Sample(sampler, uv):采样函数,用采样器在纹理的uv坐标处取颜色。: SV_Target:HLSL 语义,表示"这个函数的返回值就是这个像素最终的颜色"。
小结(一句话比喻):图像混合就像在玻璃上贴贴纸——先铺一张黑底玻璃(清屏),然后按层级从下到上,把每张贴纸(纹理)按指定位置、大小、角度贴上去(drawTexture + 旋转着色器),半透明的贴纸能透出下面那层(Alpha 混合)。
5. 合成输出层:一张画,两条路
当 renderToTexture() 结束,离屏画布 m_mainTex 上已经有了一张完整的 RGB 画面。接下来要"兵分两路"输出:
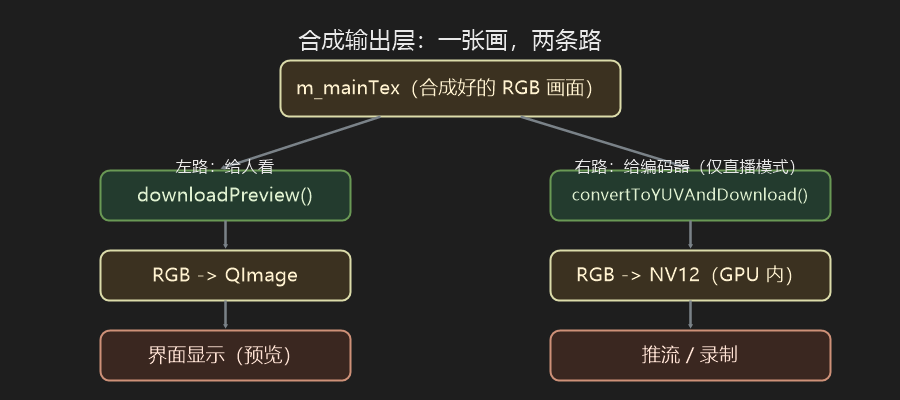
合成输出层的两路分支。左路给人看,右路给编码器。
两路的入口都在渲染线程的主循环 renderLoop 里(SceneCompositor.cpp):
void SceneCompositor::renderLoop() {
    // ...(前面是初始化、垃圾回收、同步图层,略)...

    renderToTexture();                       // 先合成出 RGB 画面

    if (m_currentMode == CompositorMode::LiveRunning) { // 只有"直播模式"才走编码
        convertToYUVAndDownload();           // ② 编码输出(转 NV12 并下载)
    }

    downloadPreview();                       // ① 预览输出(转 QImage 并下载)
    TexturePool::instance().cleanupUnused(QDateTime::currentMSecsSinceEpoch()); // 顺手清理纹理池
}
注释说明:
m_currentMode == CompositorMode::LiveRunning:CompositorMode是一个枚举(一组命名的整数常量),有Editor(编辑)和LiveRunning(直播)两个值。用==判断当前是否处于直播模式。- 为什么编辑模式跳过编码?因为编码(转 YUV、下载)很耗 CPU/GPU,编辑时没人要看编码结果,跳过能省资源。
5.1 第一路:UI 预览(downloadPreview)
预览就是把 GPU 里的画面搬到 CPU,转成 Qt 能显示的图片。关键点有两个:GPU→CPU 下载 和 限频节流。
void SceneCompositor::downloadPreview() {
    // ① 暴力节流:距离上次发送不足 33ms,直接丢弃本帧
    if (!s_previewLimiter.isValid()) {
        s_previewLimiter.start();            // 首次调用:启动计时器
    }
    if (s_previewLimiter.elapsed() < 33) {   // elapsed() 返回距上次过了多少毫秒
        return;                              // 不到 33ms,直接丢弃,减轻 UI 压力
    }
    s_previewLimiter.restart();              // 重置计时器,准备下一帧

    if (!m_previewStagingTex || !m_mainTex) return;  // 资源为空则返回

    // ② 把画布复制到 Staging(暂存)纹理
    DX11Context::instance().copyResource(m_previewStagingTex.Get(), m_mainTex.Get());

    // ③ mapRead:把 Staging 纹理映射到 CPU 可读的内存,回调里读数据
    DX11Context::instance().mapRead(m_previewStagingTex.Get(),
        [this](const D3D11_MAPPED_SUBRESOURCE& map){
            if (!map.pData) return;          // 映射失败则返回
            // 用这块 CPU 内存构造一张 QImage(Qt 的图片类型)
            QImage img((const uchar*)map.pData, m_canvasW, m_canvasH,
                       map.RowPitch, QImage::Format_ARGB32);
            QImage deepCopy = img.copy();    // 深拷贝一份(因为 map 很快会被释放)
            emit frameReady(deepCopy);       // 通过信号发给界面去显示(见 5.4)
        });
}
注释说明:
- Staging(暂存)纹理:一种特殊用途的纹理,允许 CPU 直接读写。GPU 里普通的纹理(
D3D11_USAGE_DEFAULT)CPU 读不了,所以要先把数据"复制"到 Staging 纹理,再映射到 CPU 内存。 - Map / mapRead:D3D11 的
Map操作,把 GPU 纹理的某块内存"映射"成 CPU 能直接访问的指针。mapRead是项目里封装好的线程安全版本。 map.RowPitch:行距,即纹理每一行在内存里占用的字节数(可能比宽×每像素字节大,因为有对齐填充)。构造 QImage 时传它,是为了正确处理这种对齐。
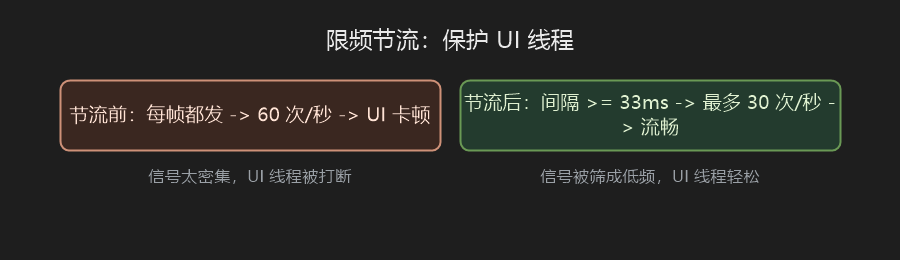
为什么节流? 渲染线程可能跑 60fps,但 UI 刷新 30fps 就够流畅了。如果每一帧都发信号给 UI 线程,UI 线程会被频繁打断卡死。所以用 s_previewLimiter(一个计时器)强制"至少间隔 33ms 才发一次"(33ms ≈ 30fps),这就是限频节流(Throttle)。
5.2 第二路:编码输出(convertToYUVAndDownload)
编码器(比如 FFmpeg、x264、NVENC)不吃 RGB,它们喜欢 YUV 格式,尤其是 NV12。所以这一路要先把 RGB 转成 NV12,再下载给编码模块。
void SceneCompositor::convertToYUVAndDownload() {
    if (!m_mainSRV || !m_nv12Texture || !m_rtvY || !m_rtvUV) return;

    // ① 在 GPU 内,把 RGB 画布转成 NV12 纹理
    DX11Context::instance().convertRGBtoNV12(
        m_mainSRV.Get(),    // 输入:RGB 画布的读接口
        m_rtvY.Get(),       // 输出:Y 通道的写接口
        m_rtvUV.Get(),      // 输出:UV 通道的写接口
        desc.Width, desc.Height,
        conf.colorSpace, conf.colorRange, conf.downscaleFilter); // 色彩配置

    // ② 把 NV12 下载到 CPU,再交给回调
    downloadNV12ToCallback();
}
注释说明:这里最关键的思路是——格式转换全程在 GPU 内完成(用着色器),而不是把 RGB 下载到 CPU 再用 CPU 慢慢转。GPU 并行做,快得多。
5.3 什么是 YUV / NV12
先理解概念,再看转换代码。
YUV:一种颜色表示法,和 RGB 不同,它把颜色拆成"亮度 + 色度":
- Y(亮度 Luma):像素有多亮。
- U、V(色度 Chroma):像素偏什么颜色。
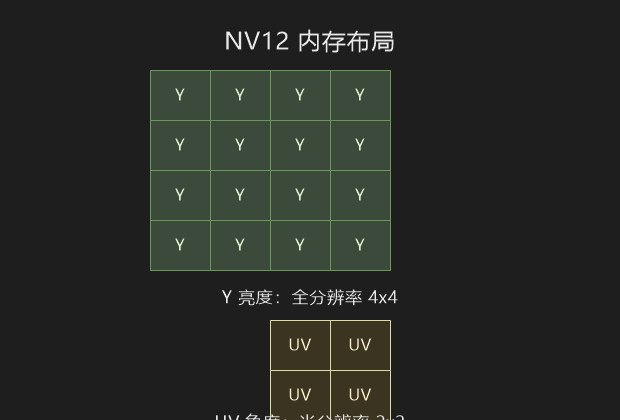
为什么编码器喜欢 YUV?因为人眼对亮度敏感、对颜色不敏感,所以可以压缩色度(让 U、V 的分辨率只有 Y 的一半甚至四分之一),几乎不影响观感,却能大幅减小数据量。这正是视频压缩的基础。
NV12:YUV 的一种常见"打包"方式:先存完所有像素的 Y,再交错存 U、V(每 2×2 个像素共享一对 UV)。
5.4 转码着色器:convertRGBtoNV12
DX11Context::convertRGBtoNV12 会做两件事:先用"RGB→Y 的着色器"把 Y 通道画到 m_rtvY,再用"RGB→UV 的着色器"把 UV 通道画到 m_rtvUV(见 Core/DX11Context.cpp,这里节选关键逻辑):
void DX11Context::convertRGBtoNV12(/* ...参数略... */) {
    std::lock_guard<std::mutex> lock(m_mutex);

    // ① 先解绑所有 RTV,防止"读写的纹理是同一块"导致冲突(读写冲突会黑屏)
    ID3D11RenderTargetView* nullRTV[] = { nullptr };
    m_context->OMSetRenderTargets(1, nullRTV, nullptr);

    // ② 更新颜色转换矩阵(决定用 BT.601 还是 BT.709,全范围还是限范围)
    updateColorMatrix(space, range, desc.Width, desc.Height);
    m_context->PSSetConstantBuffers(1, 1, m_colorBuffer.GetAddressOf());

    // ③ 关闭 Alpha 混合(格式转换不需要半透明混合)
    m_context->OMSetBlendState(m_blendStateDisabled.Get(), nullptr, 0xFFFFFFFF);

    // ④ 绑定输入 RGB 纹理
    m_context->PSSetShaderResources(0, 1, &inputTex);

    // ⑤ 画 Y 通道:用 PS_RGB_to_Y_Bilinear 着色器,渲染到 Y 的 RTV
    m_context->OMSetRenderTargets(1, &targetY, nullptr);
    m_context->PSSetShader(psY, nullptr, 0);
    renderQuad(0, 0, (float)targetW, (float)targetH, 0.0f, ...);

    // ⑥ 画 UV 通道:用 PS_RGB_to_UV_Bilinear 着色器,渲染到 UV 的 RTV(尺寸减半)
    m_context->OMSetRenderTargets(1, &targetUV, nullptr);
    m_context->PSSetShader(psUV, nullptr, 0);
    renderQuad(0, 0, (float)targetW/2, (float)targetH/2, 0.0f, ...);

    // ⑦ 恢复状态、解绑,避免影响后续
    // ...
}
而"RGB→Y"着色器的核心就是一行点积运算(Core/DX11Context.cpp 的 HLSL 段):
// PS_RGB_to_Y_Bilinear:把采样到的 RGB 颜色转成亮度 Y
float4 PS_RGB_to_Y_Bilinear(PS_INPUT input) : SV_Target {
    float3 rgb = tex.Sample(samLinear, input.tex).rgb; // 采样得到 R,G,B
    float y = dot(rgb, yCoeff.rgb) + yCoeff.a;         // Y = 系数·RGB + 偏移
    return float4(y, 0, 0, 1);
}
注释说明:
dot(a, b):HLSL 的"点积"函数,即对应分量相乘再求和:a.x*b.x + a.y*b.y + a.z*b.z。yCoeff:一个向量,里面存的是"RGB 各分量对亮度的贡献系数"(比如 BT.709 下大约是 0.2126、0.7152、0.0722)以及一个偏移量。这些系数在updateColorMatrix里根据色彩标准算好,写进常量缓冲(Constant Buffer)。float3:3 个 float 的向量,.rgb是取前三个分量(R、G、B)的写法。
5.5 信号与回调:把结果"送"出去
下载到 CPU 后,数据怎么交给别人?项目用了两种机制:
(1)Qt 信号/槽(Signal/Slot):SceneCompositor 继承自 QObject,可以"发信号"。发出后,任何"连接"了该信号的对象会自动收到通知。
// 声明在 SceneCompositor.h 里
signals:
    void frameReady(const QImage& image);        // "有一帧预览画面好了"
    void yuvFrameReady(const std::vector<uint8_t>& data, int width, int height, int64_t pts);
                                                 // "有一帧 YUV 数据好了"
(2)回调函数(Callback):std::function存一个函数,供外部注入。
// 类型定义:一个函数,参数是 (数据指针, 宽, 高, 时间戳)
using VideoFrameCallback = std::function<void(const uint8_t* data, int width, int height, int64_t pts)>;
void setVideoOutputCallback(VideoFrameCallback callback); // 外部注册回调
下载 NV12 后,两种方式都会触发(downloadNV12ToCallback 节选):
// 下载后:
emit yuvFrameReady(buffer, w, h, currentPts / 1000);      // 发信号给 Qt 侧
if (m_outputCallback) m_outputCallback(buffer.data(), w, h, currentPts); // 调用外部回调
注释说明:
uint8_t:8 位无符号整数(字节)。YUV 数据就是一堆字节。int64_t pts:pts(Presentation Time Stamp,显示时间戳),标记这一帧该在什么时间点显示,用于音视频同步。- 两条路线的区别:信号走 Qt 的跨线程机制,适合发给界面;回调更直接,适合推流/录制模块(它们不是 Qt 对象,用回调更通用)。
小结(一句话比喻):合成输出层就像一张画完成后,要做两份拷贝——一份缩印成照片贴在窗口上给人看(预览),一份转成印刷机喜欢的油墨配方交给印刷厂(NV12 编码)。前者怕太频繁卡住看的人,所以加了个"每分钟最多递 30 次"的规矩(节流)。
6. 完整数据流:把所有环节串起来
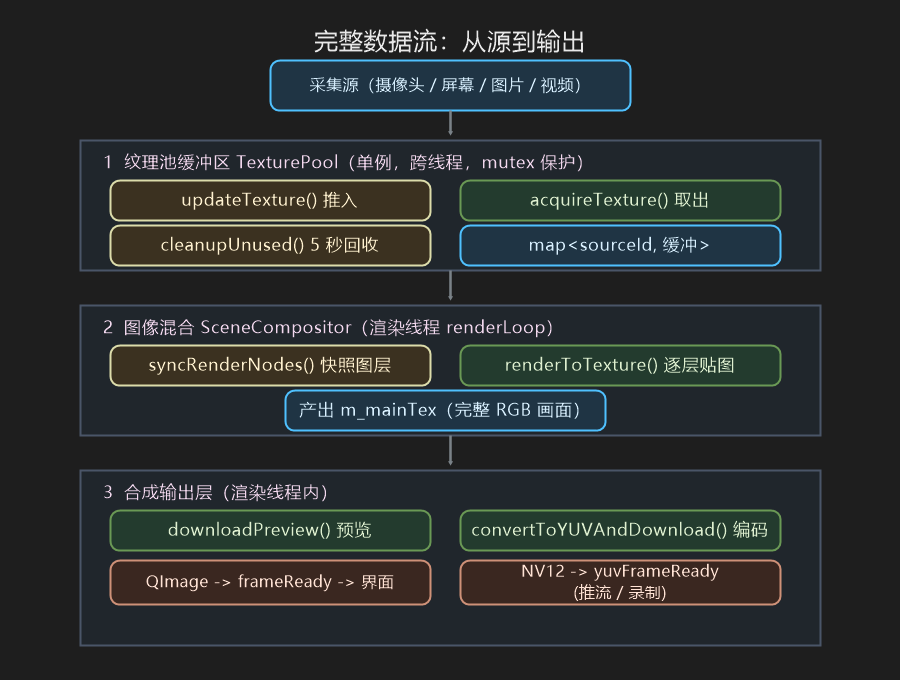
现在把三节串成一张全景图。数据从"源"出发,最终变成"预览画面"和"编码数据"。
用一段话复述这条链路:
采集源产出一帧纹理 → 通过 TexturePool::updateTexture 存入纹理池(按 sourceId 归档,受互斥锁保护)→ 渲染线程的 renderLoop 每帧先 syncRenderNodes 同步图层快照,再 renderToTexture 从池里 acquireTexture 取出各源最新帧,用 DX11Context::drawTexture(配合旋转/采样/混合着色器)一张张贴到离屏画布 m_mainTex 上 → 合成完成后,downloadPreview 把画布下载成 QImage 发给界面预览;若是直播模式,convertToYUVAndDownload 先把画布在 GPU 内转成 NV12,再下载交给推流/录制模块。