1 流媒体输出引擎
在实时直播与录制系统中,系统需要同时采集多个异构素材,如4K屏幕捕获、1080P摄像头、高频更新的文字等,并将其合成为一路稳定的60FPS视频流。
传统的CPU合成方案存在以下致命痛点:
- 内存带宽瓶颈:在CPU中进行像素拷贝与叠加会产生巨大的总线开销。
- 转换损耗:将渲染用的RGB数据转换为编码用的YUV格式时,CPU运算耗时极长。
- 线程阻塞:复杂的合成逻辑若与采集或UI逻辑混杂,会导致严重的丢帧。
为此,本系统设计了以SceneComositor为核心的异步GPU合成架构。
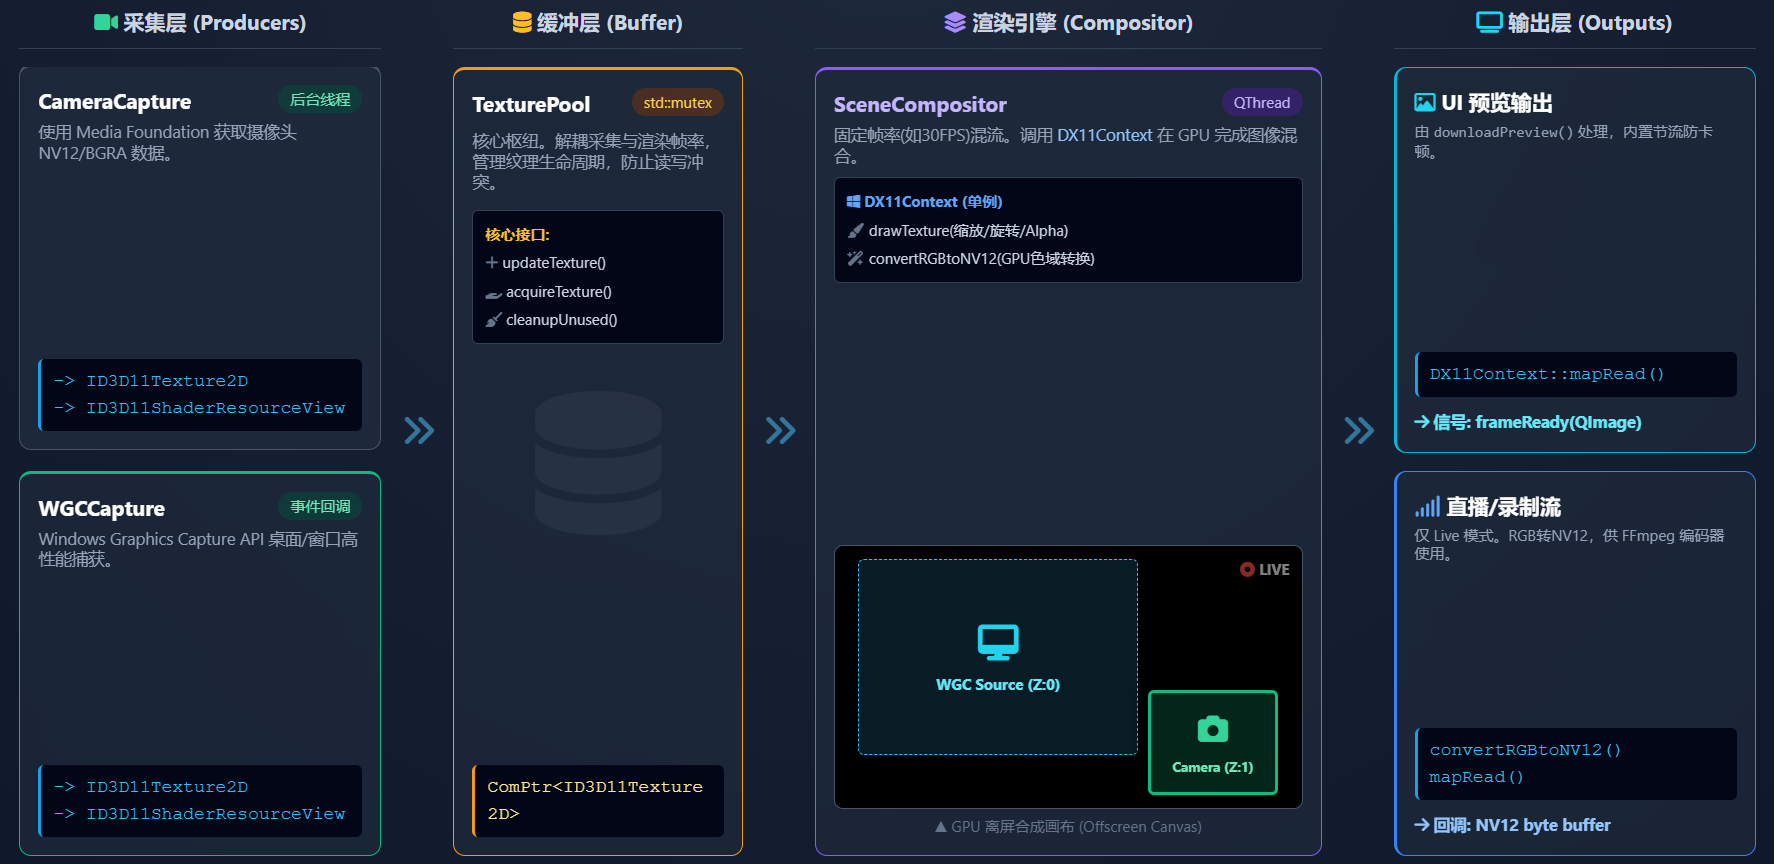
这是一个经典的“生产者-消费者”渲染管线架构。在复杂的音视频软件(如:OBS、直播客户端)中,为了保证界面不卡顿且渲染高效率,通常会将“采集”、“缓冲”、“渲染”、”输出“严格剥离到不同线程中。
SceneCompositor(场景合成器)正式这个架构中的核心消费者与混流引擎。
2 视频捕获技术选型
屏幕采集技术-DWM处理逻辑
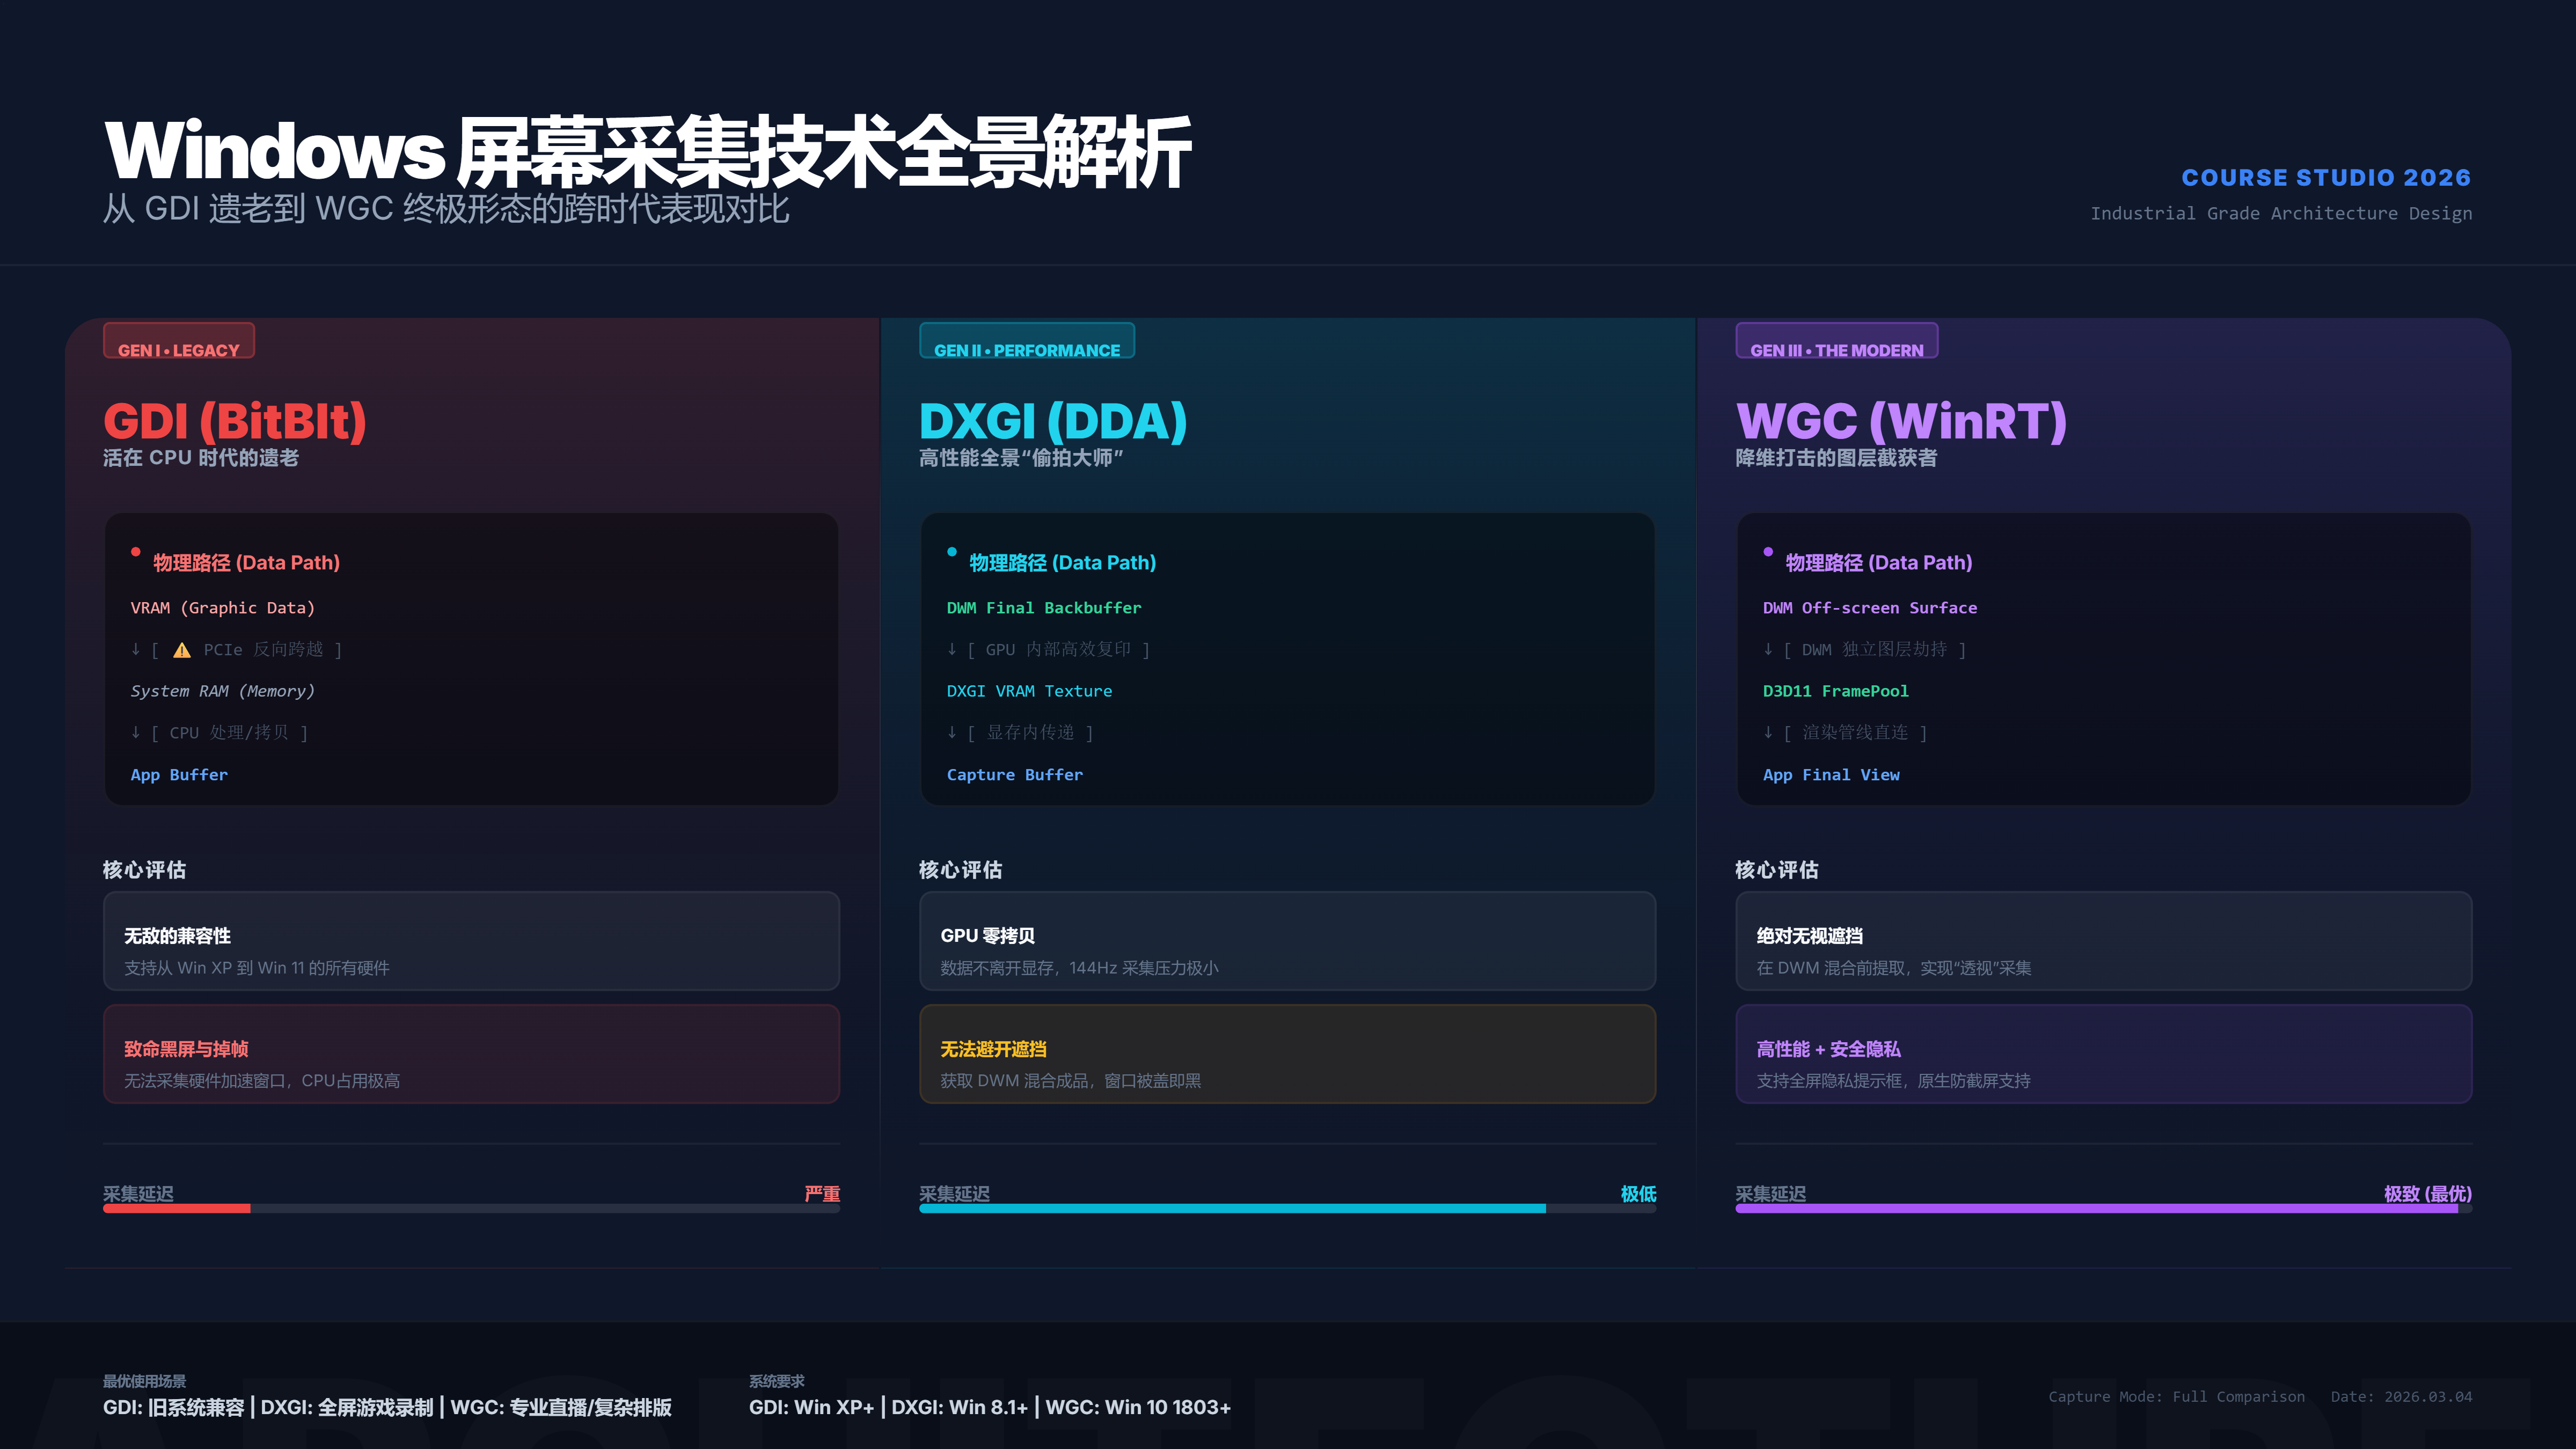
GDI(BitBlt):兼容性最好。但纯CPU拷贝,性能极差,会导致画面卡顿、CPU占用飙升,且无法采集硬件加速窗口(如Chrome浏览器,大部分游戏会黑屏)
DXGI(Desktop Duplication API):性能极好。但只能全屏采集(抓整个显示器)。如果只要抓某个特定窗口,需要自己算裁剪坐标,并且抓出来的画面有可能是被挡住的
WGC是微软在Windows10引入的现代采集API。
- 不怕遮挡:直接从DWM(桌面窗口管理器)的独立缓冲提取画面,窗口被挡住依旧能录制。
- 支持硬件加速窗口:完美抓取Chrome、游戏甚至透明特效。
- 超高性能:完全基于GPU操作,纹理数据(Testure)直接留在显存里,不经过GPU,极大地释放了系统资源。
- 黄边框提示:系统级隐私保护,采集时窗口边缘会有黄框提示(Windows 11新版可关闭)
2.1 WGC核心
1.GraphicsCaptureItem(采集目标):告诉系统需要抓取什么,可以是显示器,可以是指定的窗口。
2.Direct3D11CaptureFramePool(帧缓冲池):WGC不是每次分配新内存,而是创建一个池子。DWM会源源不断地把采集到的新画面(DXGI纹理)扔进这个池子。高性能的原因:使用CreateFreeThreaded,画面到达回调会在后台工作线程触发,不阻塞UI主线程。
3.GraphicsCaptureSession(采集会话):采集的开关,调用StartCapture()开始源源不断进水,Close()关闸。
3 Windows摄像头捕获视频架构
3.1 DirectShow
在早期(Windows 98到Windows XP),Windows的多媒体核心是DirectShow。
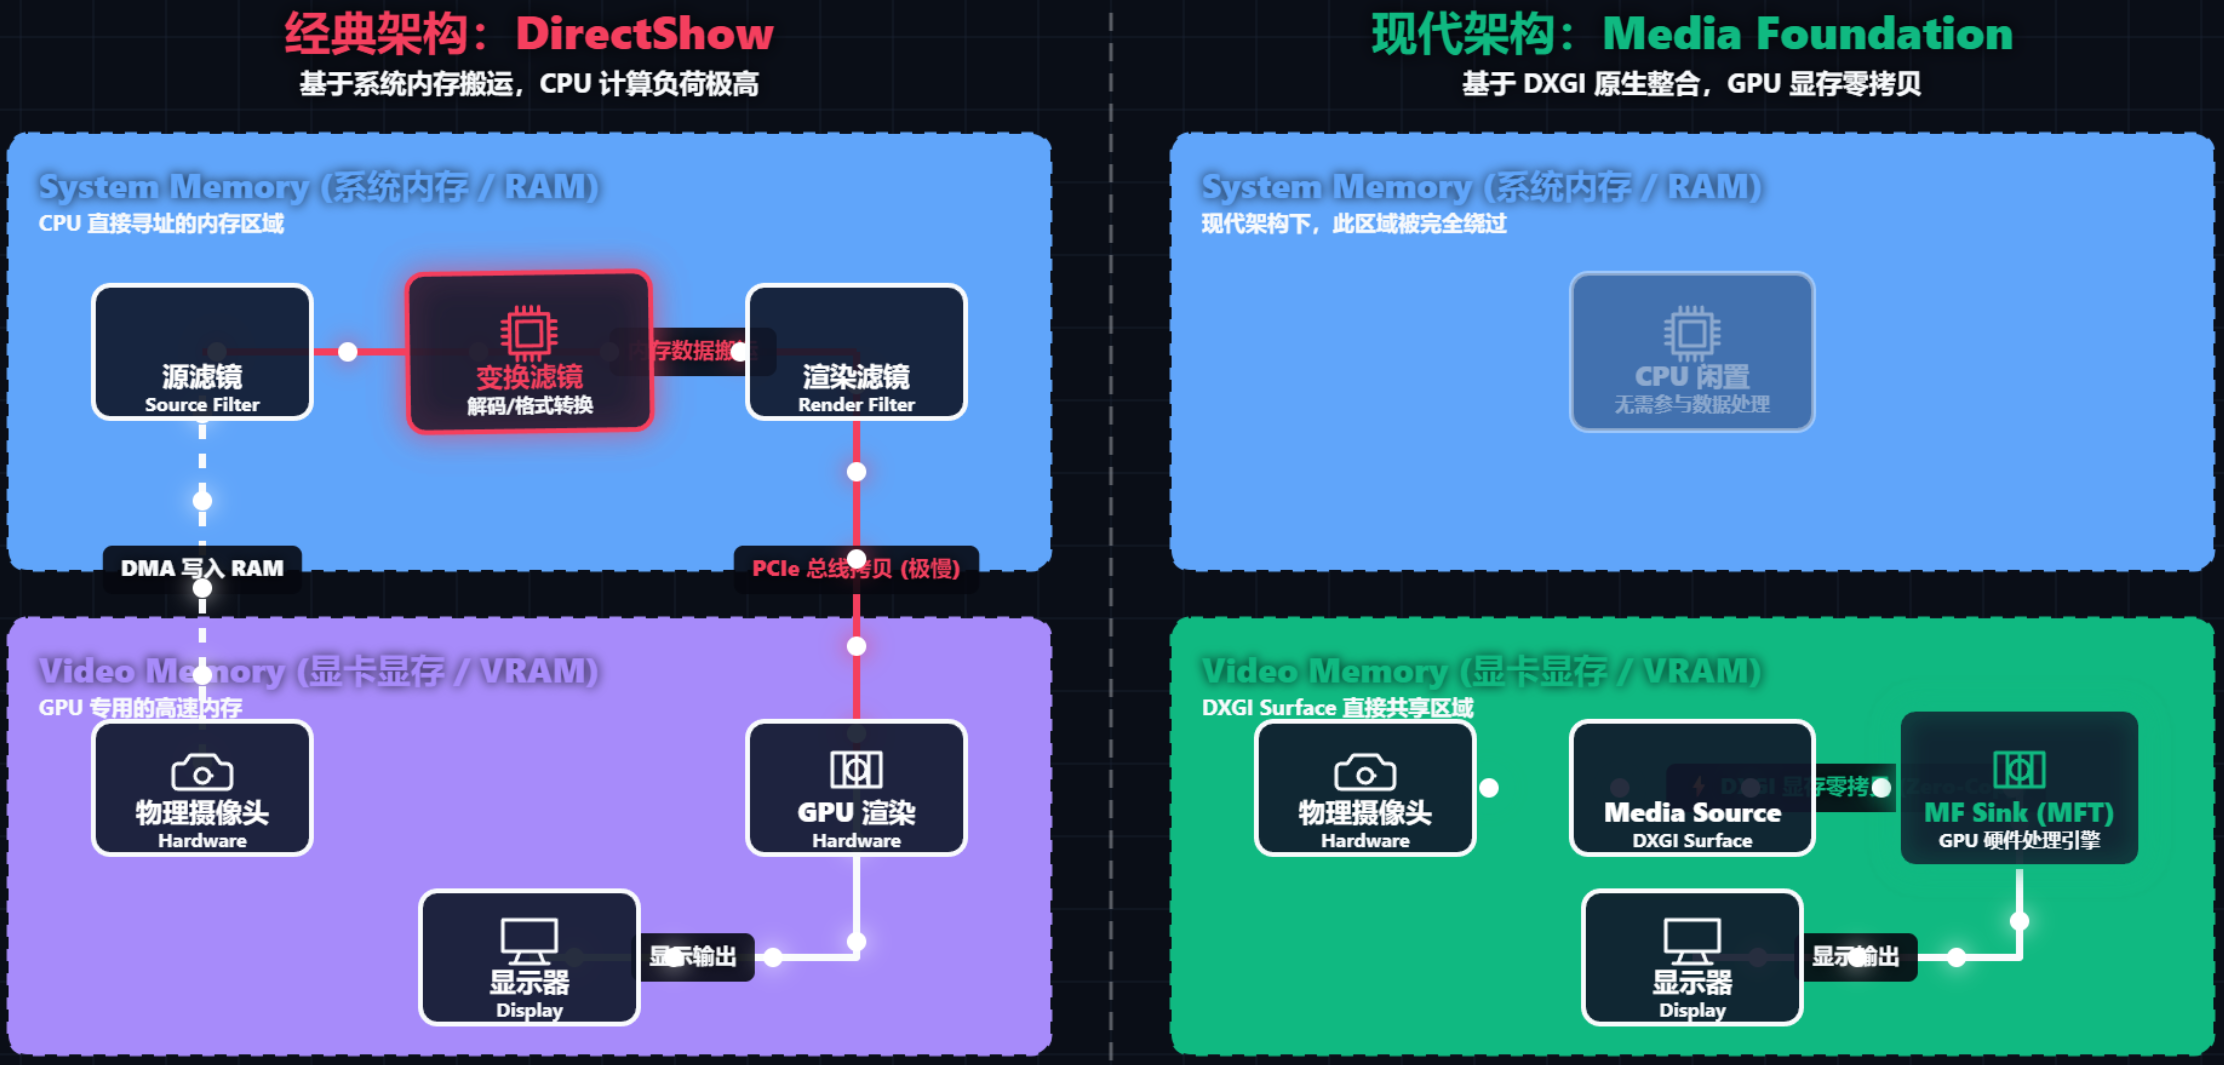
架构思想:他采用的是滤镜图架构。微软将整个流程定义为一个流水线,包含原滤镜(Source Filter,即摄像头)、变换滤镜(Transform Filter,如解码/格式转换)和渲染滤镜(Render Filter,如屏幕显示)。
痛点:随着高清视频和3D游戏的普及,DirectShow暴露出了致命缺陷-它与现代显卡架构(DirectX 11/12)结合起来极其勉强。视频数据经常需要在系统内存(CPU)和显存(GPU)之间来回拷贝,导致极高的CPU占用率。
DirectShow的致命缺陷:摄像头数据必须先引入系统内存(RAM),交由CPU,拆包、解码,导致CPU100%满载,处理完的图像通过PCle总线拷贝回显卡,带宽极度拥挤,引发高延迟和卡顿。
3.2 Media Foundation
为了适应高清化和现代GPU,微软从Windows Vita开始,彻底废弃了DirectShow的底层设计,重写了全新的多媒体核心引擎:Media Foundation(MF)
架构思想:引入了媒体拓扑和媒体会话概念。
架构革命:
1.原生DXGI整合:Media Foundation在最底层与DirectX图形基础设备(DXGI)打通。这意味着摄像头采集到的画面,可以“零拷贝”,地直接驻留在显卡显存(VRAM)中,交由GPU进行渲染或硬件编码,CPU甚至都不需要碰这些像素。
2.极致的异步化:所有的调用全部变成异步操作,彻底解决了老架构容易阻塞主线程导致UI卡死问题。
MF零拷贝革命的意义:彻底打通底层DirectX接口,图像直接存入显存(VRAM)形成DXGI纹理,格式转换/缩放全靠GPU流处理器一瞬间完成,CPU彻底释放,0%负载处理4K/8K视频。
3.3 WinRT MediaCapture
WinRT MediaCapture是建立在Media Foundation极限性能基础上的现代工程化封装。
Media Foundation是Windows的核心引擎层,他直接与操作系统内核和显卡(DirectX)对话,追求的是极致的控制力和零拷贝性能。
WinRT MediaCapture是高级抽象层。他底层完全是MF引擎,但对外暴露是C++接口。
3.3.1 Media Foundation白盒图论 & WinRT MediaCapture黑盒端点
3.3.1.1 白盒图论
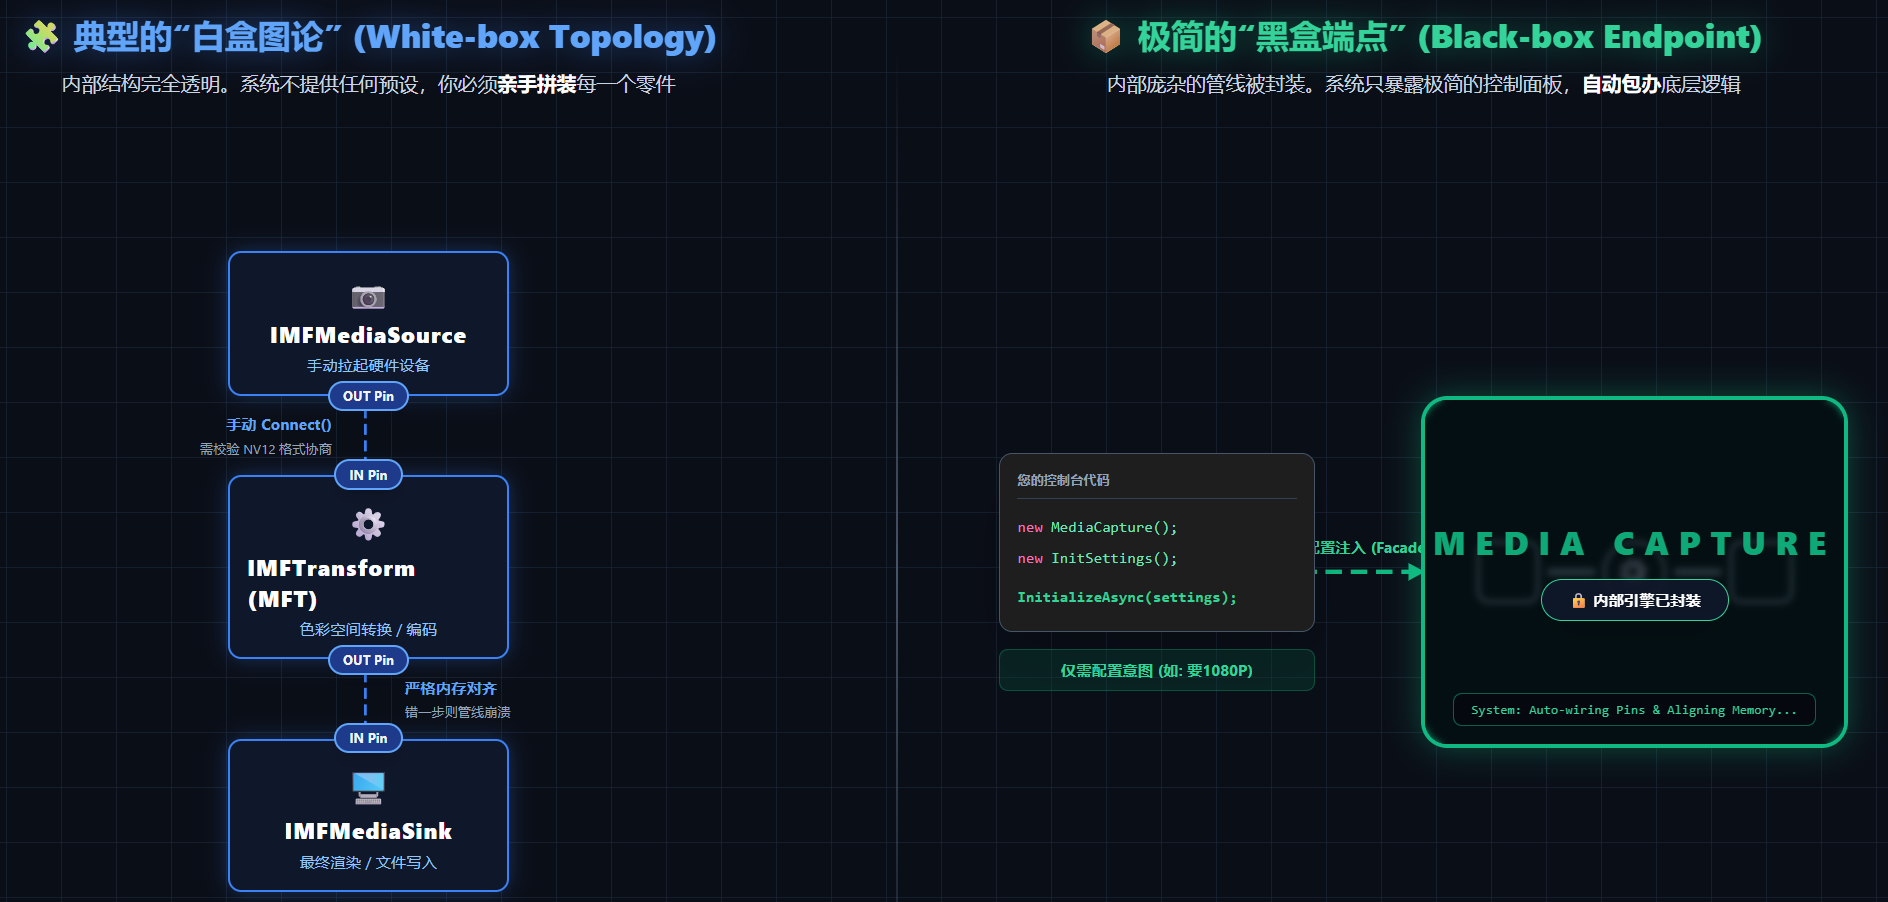
本质定义:内部结构与数据流向对开发者完全透明,且高度依赖人工干预。
运行机制:开发者扮演“底层管线构建者”。必须手动实例化媒体源(IMFMediaSource)、色彩转换节点(IMFTransform)和接收器(IMFMediaSink),并且亲手完成所有引脚连接与格式协商。
优劣性:拥有像素级与内存级的绝对控制权。代价是代码极度冗长,且任何内存对齐或格式协商的细微错误都会导致整条管线崩溃。
3.3.1.2 黑盒端点
本质定义:基于外观模式,将底层复杂管线完全封装,向外仅暴露有限的控制面板。
运行机制:开发者转变为“业务调度者”。仅需创建MediaCapture对象,向其注入MediaCaptureInitializationSettings(声明分辨率、内存类型等需求),并带哦用InitializeAsync()即可。
优劣性:由系统后台全自动完成所有设备的寻址、转换器的插入及管线的连线。开发极简,但丧失了部分底层魔改的自由度。
4 WinRT MediaCapture应用(详细步骤)
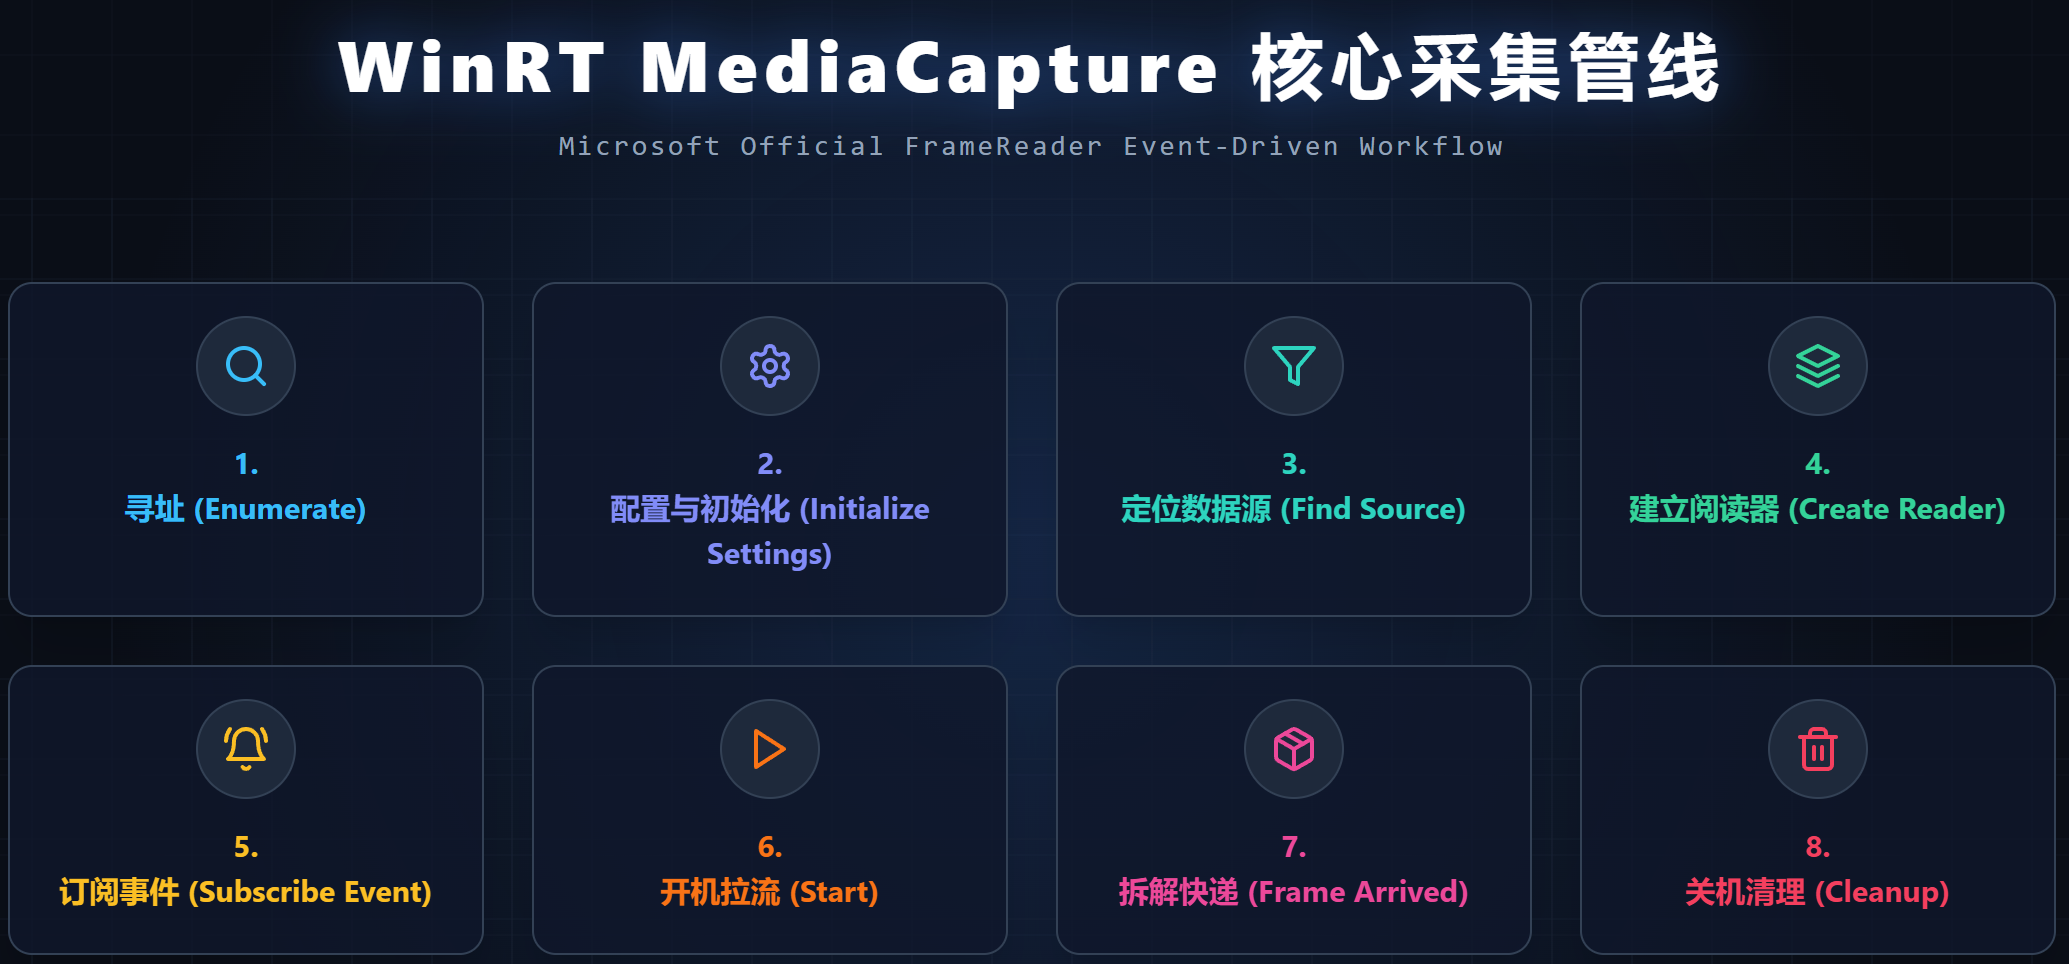
微软官方WinRT FrameReader标准流程
- 寻址(Enumerate):在庞杂的系统设备列表中,拿到目标摄像头的唯一身份证(Device ID)。
- 配置与初始化(Initialize Settings):向系统提交一份“需求列表”,决定接下来是用CPU还是GPU处理数据,是独占硬件还是与其他软件共享。
- 定位数据源(Find Source):从摄像头提供的多个功能镜头中,精准剥离“彩色画面(Color)的数据流”。
- 建立阅读器(Create Reader):为选定的摄像头建立一个专属的数据接收队列,并决定当程序处理不过来时该怎末办。
- 订阅事件(Subscribe Event):挂载一个
FrameArrived回调函数,告诉系统有新画面时通知程序。 - 开机拉流(Start):正式命令摄像头开始录制。
- 拆解快递(Frame Arriver Callback):获取最新帧,进行格式转换,并提取位C++能读写的裸内存。
- 关闭清理(Cleanup):停止数据流,释放摄像头设备,销毁阅读器。
4.1 代码实现
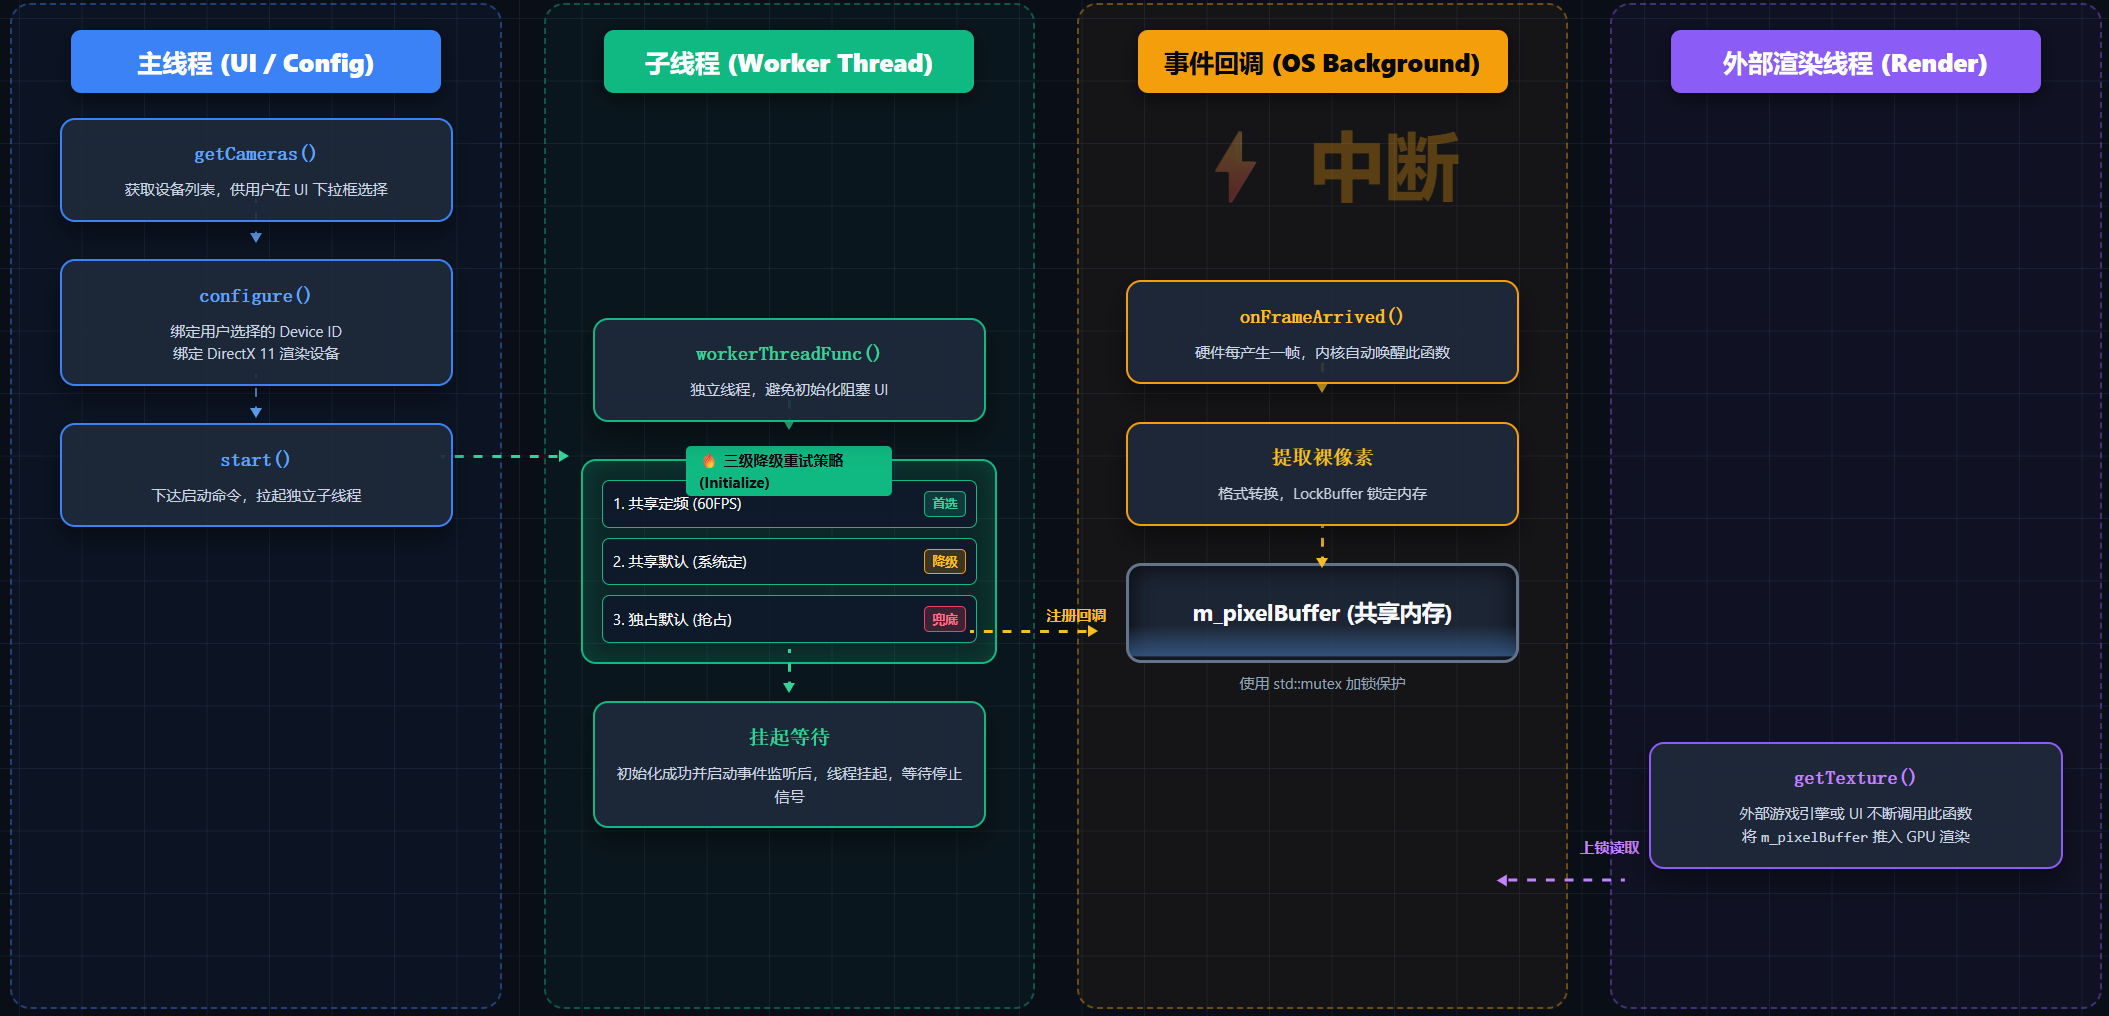
4.1.1 寻址与线程环境配置
对应代码(getCameras与workerThreadFunc开头):
winrt::init_apartment(winrt::apartment_type::multi_threaded);
auto devices = DeviceInformation::FindAllAsync(DeviceClass::VideoCapture).get();
其中:
init_apartment:这是进入WinRT的现代世界的“门票”。因为我们的代码跑在子线程里。必须要告诉Windows这个线程使用多线程公寓(MTA)模型处理底层COM对象。没有这个,所有的WinRT API直接崩溃。
FindAllAsync:向系统要一份“全电脑摄像头的通讯录”。
4.1.2 配置与初始化黑盒
先告诉 Windows 我想怎么使用摄像头,然后请求系统初始化这个摄像头。对应代码(workerThreadFunc循环内部):
//MediaCaptureInitializationSettings创建的是一个初始化配置对象是 WinRT 类型,提供属性读写方法,并非这个普通 C++ 结构体。
MediaCaptureInitializationSettings settings;
//决定:到底打开电脑上的哪一个摄像头
settings.VideoDeviceId(deviceId.toStdWString());
//这里声明当前 MediaCapture 只需要视频采集,不需要音频采集。
settings.StreamingCaptureMode(StreamingCaptureMode::Video);
settings.MemoryPreference(MediaCaptureMemoryPreference::Cpu);
settings.SharingMode(MediaCaptureSharingMode::SharedReadOnly);

m_mediaCapture = MediaCapture();
m_mediaCapture.InitializeAsync(settings).get();
其中:
MemoryPreference::CPU:告诉系统,我最终要把画面拿到系统内存(m_pixelBuffer)里自己处理,请系统帮我把底层数据搬运到CPU可读区域。
SharingMode:这个是“三级降级策略”的核心。有的摄像头被别的软件占用了,只能用SharedReadOnly(共享只读)模式;有的高级工业相机必须用ExclusiveControl(独占)才能发挥性能。
InitializeAsync:真正启动WinRT黑盒,此时底层MF开始自动组装管线。
4.1.3 定位彩色源、建立阅读器并挂在铃铛
对应代码(WorkThreadFunc中部):
// 找彩色镜头
auto frameSources = m_mediaCapture.FrameSources();
MediaFrameSource bestSource = nullptr;
for (auto const& kv : frameSources) {
    if (kv.Value().Info().SourceKind() == MediaFrameSourceKind::Color) { ... }
}

// 建立阅读器
m_frameReader = m_mediaCapture.CreateFrameReaderAsync(bestSource).get();

// 挂载门铃(订阅事件)
m_frameReader.FrameArrived({ this, &CameraCapture::onFrameArrived });
现在很多笔记本电脑有红外人脸解锁镜头。通过检查SourceKind::Color,可以精准避开那些黑白的红外镜头。
FrameArrived就是挂门铃。是事件驱动机制,代码不需要死循环取查询摄像头有没有新画面,极大地释放了CPU。
4.1.4 开机拉流
对应代码(workThreadFunc后部):
auto status = m_frameReader.StartAsync().get();
黑盒管线全线贯通。执行完这句话后,摄像头的物理绿灯亮起,开始向系统狂奔发送数据。
4.1.5 拆解快递
MediaFrameReader 获取视频帧 → SoftwareBitmap 转换像素格式 → 获取 CPU 内存指针 → memcpy 复制到自己的缓冲区。对应代码(onFrameArrived):
// 1. 尝试获取最新可用帧
auto frame = sender.TryAcquireLatestFrame();
// 获取 WinRT 提供的软件位图 bitmap
auto bitmap = frame.VideoMediaFrame().SoftwareBitmap();

// 2. 格式翻译
//Pixel Format(像素格式)转换
//Alpha Mode(透明度表示方式)转换
if (bitmap.BitmapPixelFormat() != BitmapPixelFormat::Bgra8
    || bitmap.BitmapAlphaMode() != BitmapAlphaMode::Premultiplied) {
    bitmap = SoftwareBitmap::Convert(bitmap, BitmapPixelFormat::Bgra8, BitmapAlphaMode::Premultiplied);
}

// 3. 从 WinRT 管理的 bitmap 中取得可供 C++ 代码直接读取的像素内存地址。
auto buffer = bitmap.LockBuffer(BitmapBufferAccessMode::Read);
//创建对底层内存的引用
auto ref = buffer.CreateReference();
//查询原生字节访问接口
auto byteAccess = ref.as<IMemoryBufferByteAccess>();
//准备接收指针和容量是
uint8_t* data = nullptr;
byteAccess->GetBuffer(&data, &capacity);
//这会获取第 0 个图像平面的描述信息
auto plane = buffer.GetPlaneDescription(0);

// 4. 拷贝到自己的内存池(m伪代码,y代表行数)
emcpy(m_pixelB(uffer.data() + y * w * 4, data + plane.StartIndex + y * plane.Stride, w * 4);
其中:
sender通常是MediaFrameReader的帧到达事件回调参数。TryAcquireLatestFrame():因为系统送快递(画面)极快,如果程序处理满了,直接丢弃旧的,永远只拿“最新”的一帧,保证直播延迟降低。SoftwareBitmap是 WinRT 提供的软件位图类型。获取可供 CPU 访问的像素数据,同时保存图像尺寸、像素格式和 Alpha 模式等信息的视频图像。SoftwareBitmap()::Convert:这是WinRT黑盒最强大的魔法。不管底层摄像头吐出来的是YUV还是NV12这种压缩格式,系统底层都会自动翻译成显卡喜欢的(BGRA8)标准格式IMemoryBufferByteAccess:这是现在C++ API打破次元壁,强行深入底层获取裸指针的COM调用接口。只有拿到这个裸指针才能把画面为给DirectX或者OpenCV。- plane包含的字段: plane.StartIndex:图像平面像素数据的起始字节偏移 plane.Width:图像平面的宽度 plane.Height:图像平面的高度 plane.Stride:图像邻两行起始地址之间的字节距离
5 音频捕获全流程
5.1 声音的产生
物理层:振动与连续的波 例如:声音的本质是空气的振动(比如说话、敲键盘)。麦克风的作用,就是一块能感受空气压力的振膜,随着声波来回震动,把机械能转换成连续的电压变化(模拟信号)。
转换层:ADC(模数转换)与PCM数据 例如:计算机只懂 0 和 1 ,存不了连续的电压波浪。所以声卡芯片里有一个叫ADC(数模转换器),他的工作就是“切西瓜“ 1.采样率:每一秒切多少刀。比如 44199HZ 或 48000HZ ,意味着一秒要测量4.8万次电压值。 2.位深:每一刀切下来的那块,用多精确的尺子去量,16-bit可以表示65536中音量级别,24-bit甚至32-bit float则极其细腻。
总结:最终,那段连续的声波被切碎、量化,变成了一长串连绵不断的数字。这种最原始的、没经过任何MP3/AAC压缩的纯数字阵列。就叫做 PCM数据 。
5.2 Windows音频框架
5.2.1 内核态混音
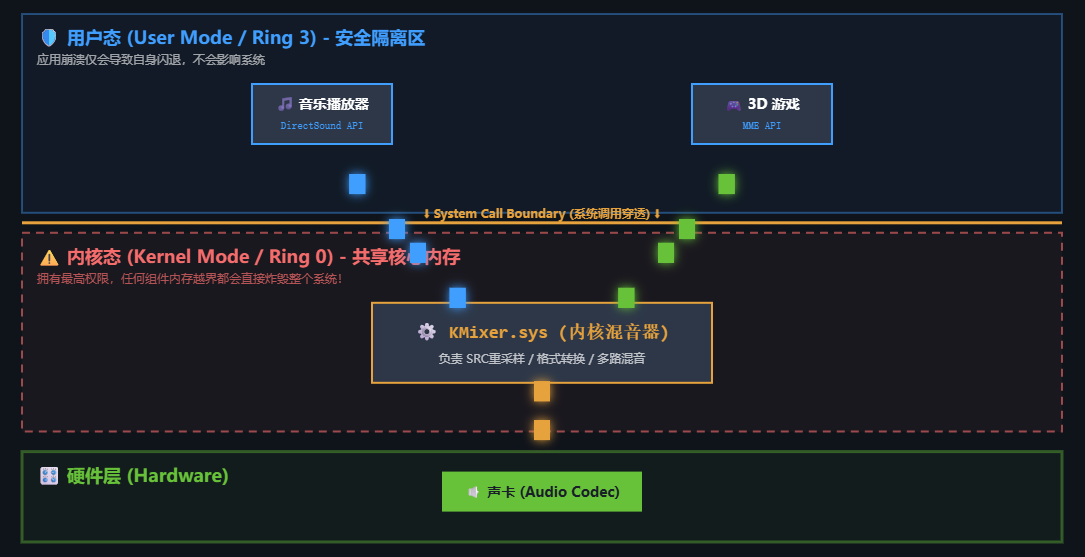
在早期的Windows系统中,音频处理高度依赖内核级驱动。
底层运行机制:
所有上层应用(无论是使用MME还是DirectSound API)发出的音频数据流,最终都会通过系统调用,穿透用户态,进入最高权限的内核态。内核层中,由一个名为KMixer.sys(Kernel Mode Audio Mixer)的系统级驱动程序统一负责所有音频流的重采样和混音工作,随后再传递给声卡硬件驱动。
致命的架构缺陷(系统级单点故障):
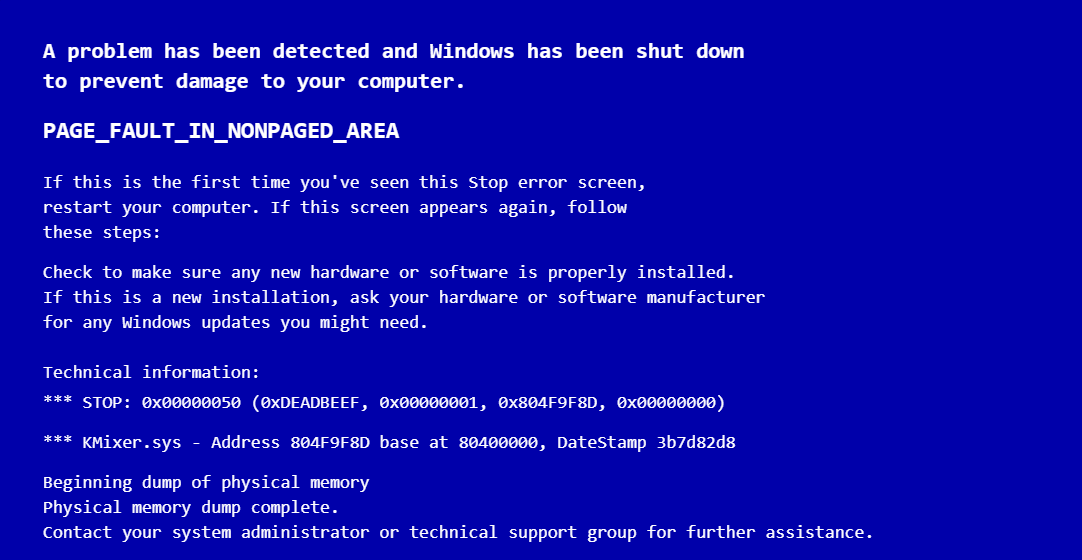
由于KMixer.sys和第三方声卡的音效处理模块都在内核态运行,他们拥有操作系统的最高内存和硬件访问权限。这意味极差的容错率:一旦在繁重的多通道混音过程中发生内存越界,或者第三方声卡驱动出现微小的Bug,将直接引发整个操作系统的崩溃。
5.2.2 用户态音频核心
为了彻底解决内核态处理带来的稳定性灾难,微软重写了整个音频栈,引入了Core Audio APIs。
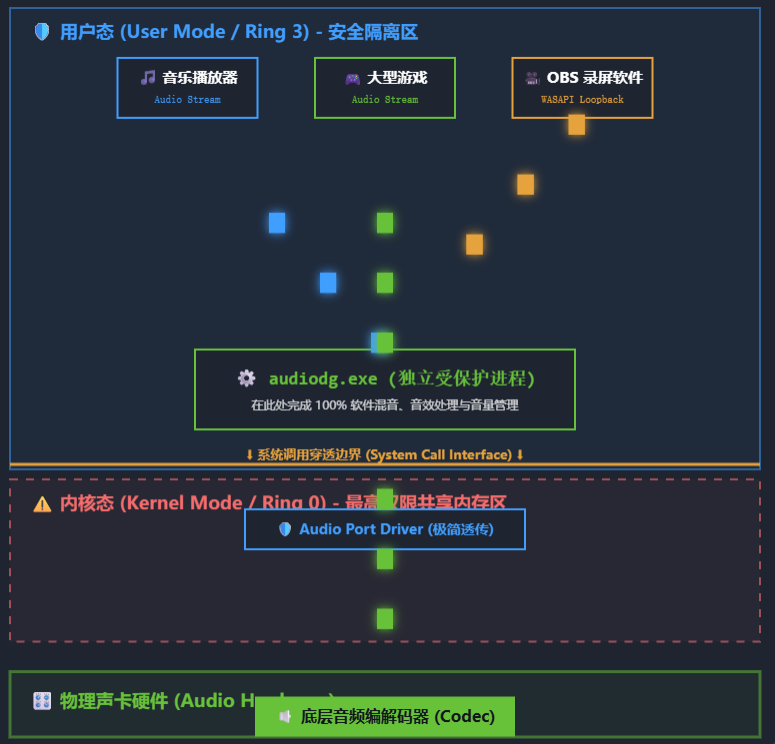
底层运行机制: 微软将庞大且危险的”混音“与”音效处理(APO)“工作,强制从内核态剥离,上移到用户态。这一工作交由一个独立的、受保护的系统级后台服务进程来统筹——即Windows Audio Engine(进程名:audiodg.exe,全程Audio Device Graph)。
现代音频管线的标准化流程:
- 会话隔离:每个发声的应用程序都被视为一个独立的音频会话。
- 软件混音:所有程序的音频流都先汇聚到audiodg.exe中,由CPU再用户态完成重采样和混合。
- 单一流输出:混合完成后的”纯净“数据流,才被打包成唯一的一条通道,安全地传递给底层的内核态声卡驱动(仅作单纯的数据透穿,不再做复杂计算)。
架构重构的决定性意义:
- 极致的稳定性(故障隔离):现在,如果某个音频处理模块崩溃,只会导致audiodg.exe这个用户态进程闪退(表现为电脑突然没声音了),Windows服务会 自动重启 ,操作系统不会因此蓝屏。
- 细粒度的控制力:因为所有音频都在用户态的audiodg.exe中进行路由和混合,操作系统终于可以实现”为每个独立的应用程序单独调节音量“这种现代功能。
- 系统级内录的诞生:正是因为有了一个统一的用户态混音节点,WASAPI才能在数据最终送往内核声卡驱动之前,合法地”截取“这份已经混合好的桌面全局音频。
5.3 音频采集技术
5.3.1 MME(Waveform Audio)
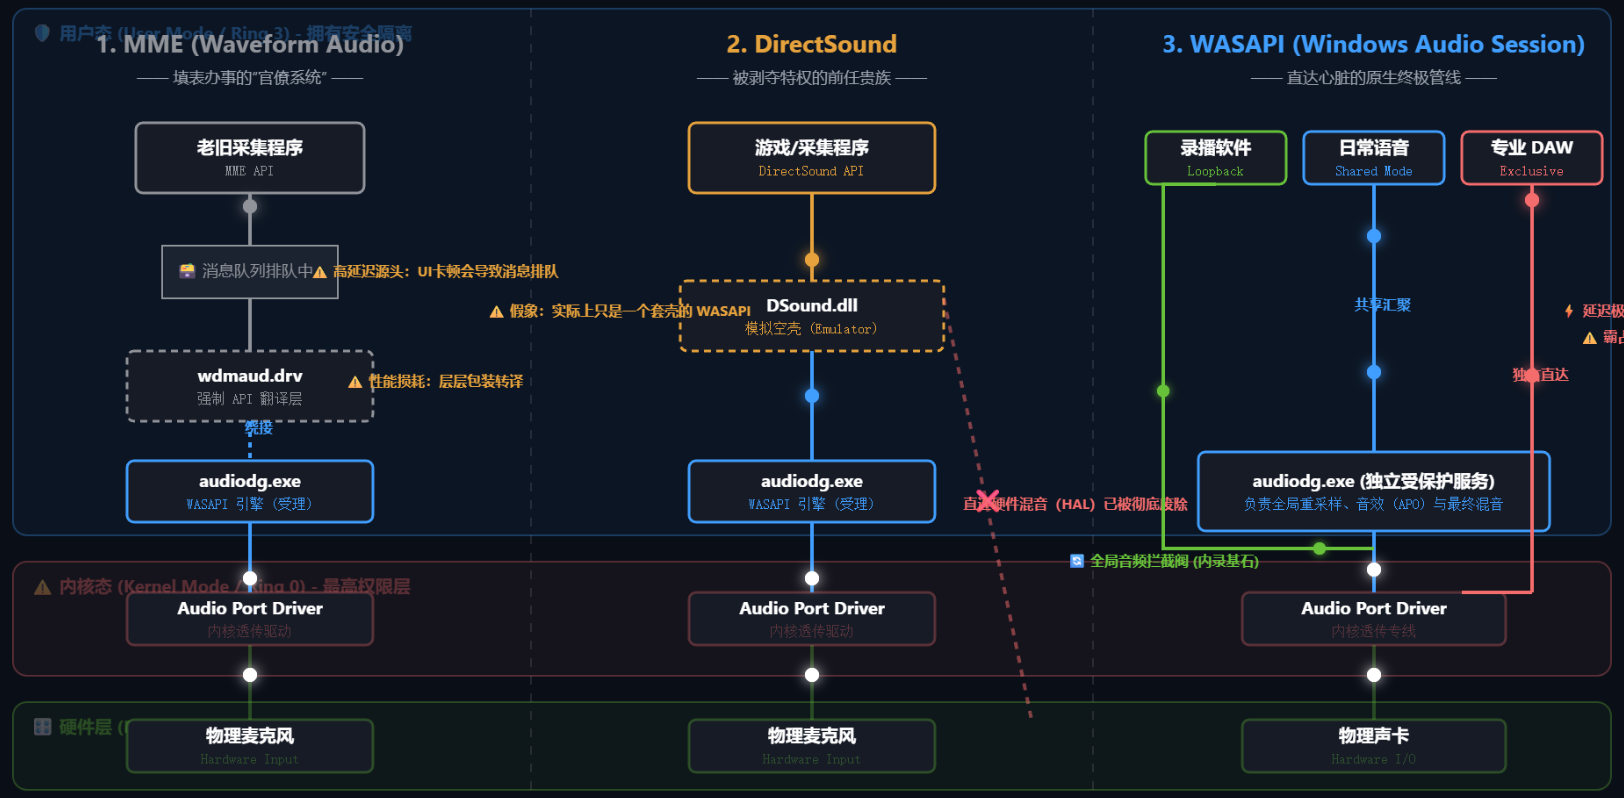
在现代Windows中,MME API实际上已经没有原生底层支持。微软为了兼容老程序,在系统里放了一个”翻译官(wdmaud.drv)“。现在所调用的MME函数,会被翻译官拦截,转译成内核流(Kernel Streaming),最后再绕回WASAPI去执行。中间隔了厚厚的好几层包装。导致采集音频延迟非常高。
5.3.2 DirectSound
在XP时代,DirectSound的杀手锏是HAL绕过。它允许游戏程序绕过系统的KMixer,直接与支持硬件混音的高级声卡对话。由于是硬件直接处理,延迟极低,还能释放CPU算力。但随着系统架构重写,微软为了安全,彻底禁止了第三方程序直接调用声卡硬件进行音频处理。现在的DirectSound接口只是一个空壳。当调用DirectSound录音时,系统底层创建了一个WASAPI的实例。他就像套着DirectSound皮肤的WASAPI,不仅没有了硬件加速的优势,还要白白承担一层API转换的性能损耗。
5.3.3 WASAPI
这是针对直播、录屏软件的终极武器。WASAPI是直接与Windows Audio Engine(audiodg.exe)对话的原生接口,中间没有任何翻译层。
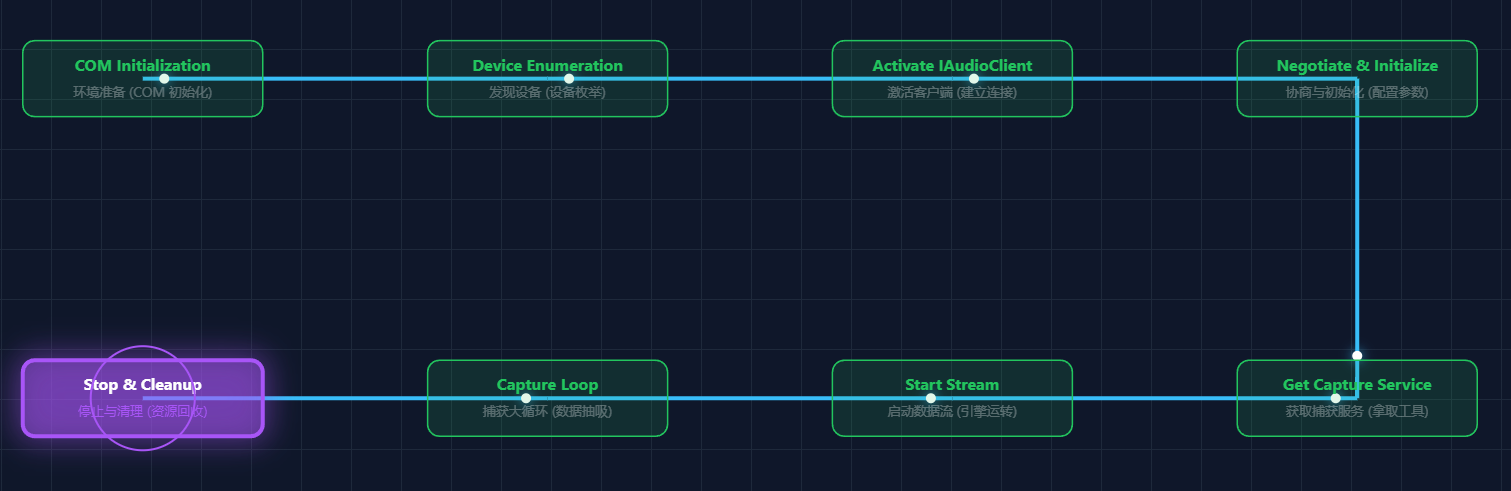
微软官方文档中,对于使用WASAPI开发“音频捕获客户端(Capture Client)”,明确规定了流水线:
- 环境准备(COM Initialization):初始化底层组件环境。
- 发现设备(Device Enumeration):查找系统中的麦克风或扬声器。
- 激活音频客户端(Active IAudioClient):与指定的硬件设备建立连接。
- 协商格式与初始化:获取设备的音频格式(采样率、位深),并告诉操作系统怎么用它(独占还是共享?要不要录系统声音?)
- 获取捕获服务:拿到真正用来“抽水”的数据读取工具。
- 启动数据流(Start):命令声卡开始录音。
- 捕获大循环(The Capture Loop):在一个死循环中,不断检查有没有新数据。如果有,拿出来转换格式;拿完必须把缓冲区还给系统。
- 停止与清理(Stop & Cleanup):停止流,释放所有资源。
详细WASAPI采集流程可以看这里《WASAPI 音频捕获入门:从工作模式到完整采集流程》
6 纹理池
纹理是存储空间着色信息的连续函数或离散数据数组,通常被映射到集合物体的表面,以增加其视觉细节和真实感。
6.1 纹理和图片的区别
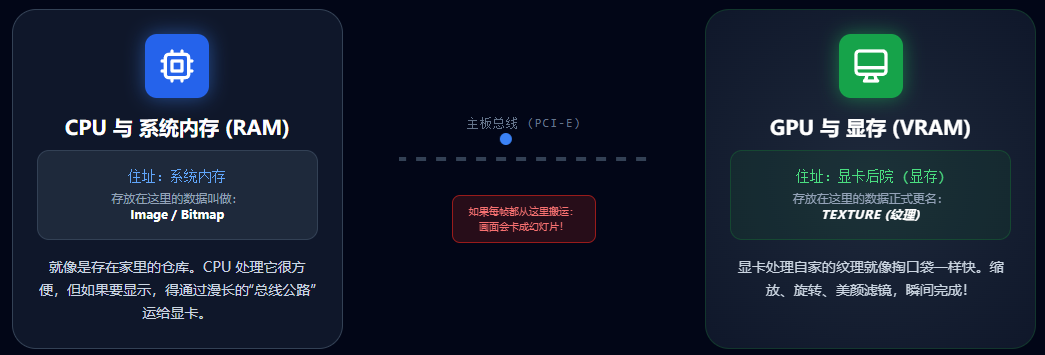
1.普通图片(如:JPG、内存里):
住址:存在CPU控制的系统内存(RAM)里面。
特点:CPU处理起来很方便,但如果让显卡(GPU)去画它,显卡就得跨过主板总线去拿数据,机器缓慢,画面绝对会卡成幻灯片。
2.纹理(如代码里的ID3D11Texture2D):
住址:存在GPU控制的显存(VRAM)里面。
特点:这是显卡的后院。显卡的流处理器读取纹理就像从口袋掏一块糖一样简单,能瞬间完成放大、缩小、加美颜滤镜等极速运算。
总结:纹理,就是一张专门存在显卡显存内存里,供显卡高速使用的特殊图片。
6.2 纹理池的作用
在高性能视频处理(如直播、录屏)中,直接连接采集和渲染会遇到三大痛点:
1.帧率不匹配:
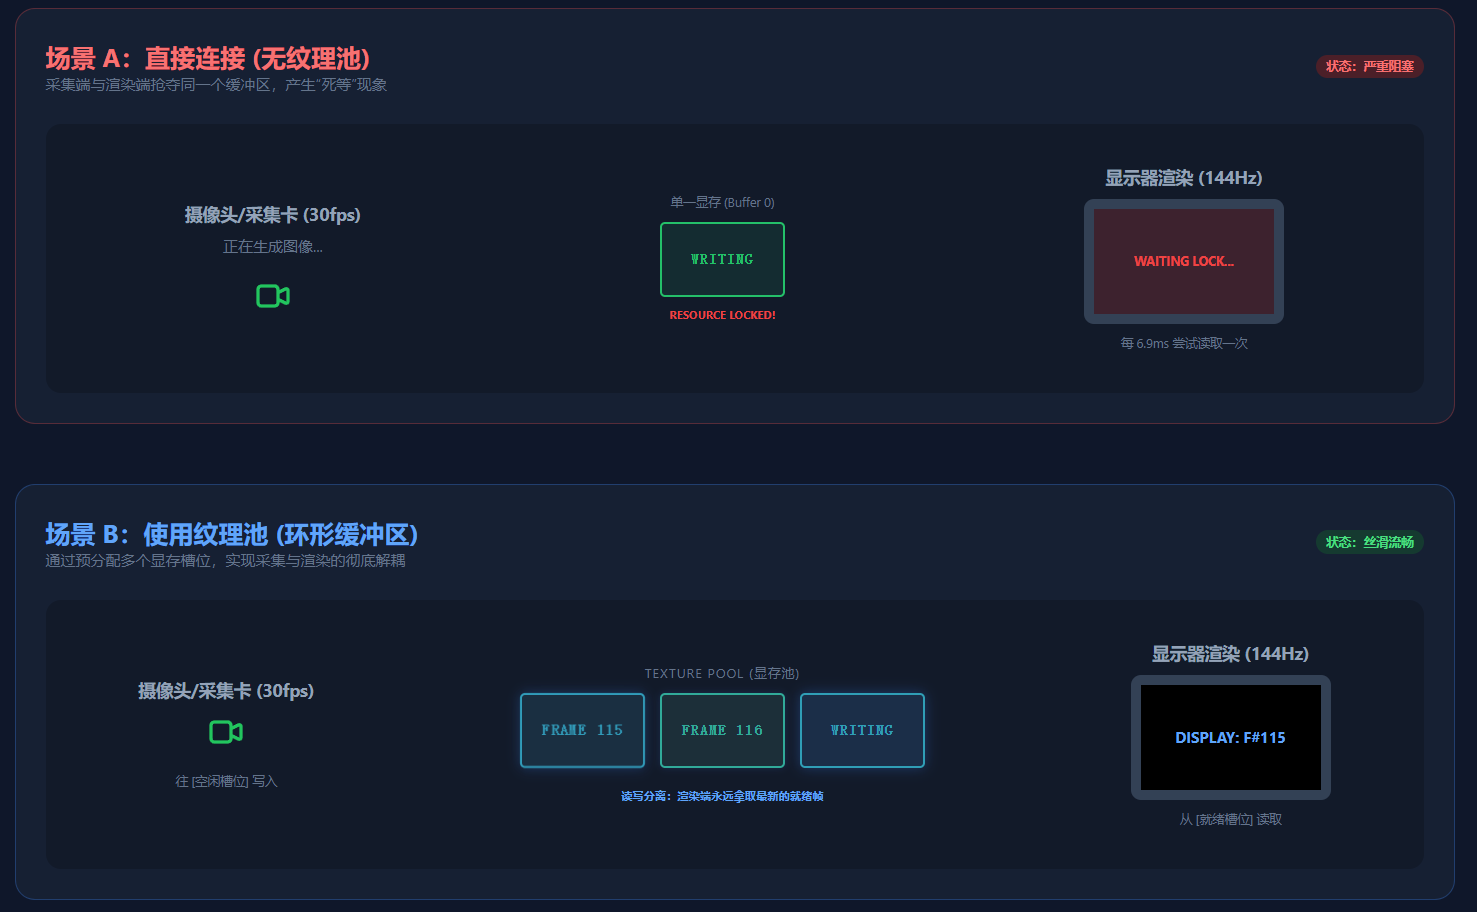
摄像头采集的可能是30fps,但显示器刷新率是144Hz。
如果没有纹理池,渲染线程必须等待采集线程,或者采集线程会被渲染阻塞,导致掉帧。
2.资源分配开销:
在Direct3D11中,频繁创建(CreateTexture2D)和销毁纹理是非常昂贵的CPU/GPU操作。
3.生命周期管理陷阱: 如果渲染器正在读取纹理,采集线程突然将其释放,会导致程序崩溃。
6.3 纹理池架构设计
代码通过策略模式巧妙地解决了不同场景下的缓冲需求。
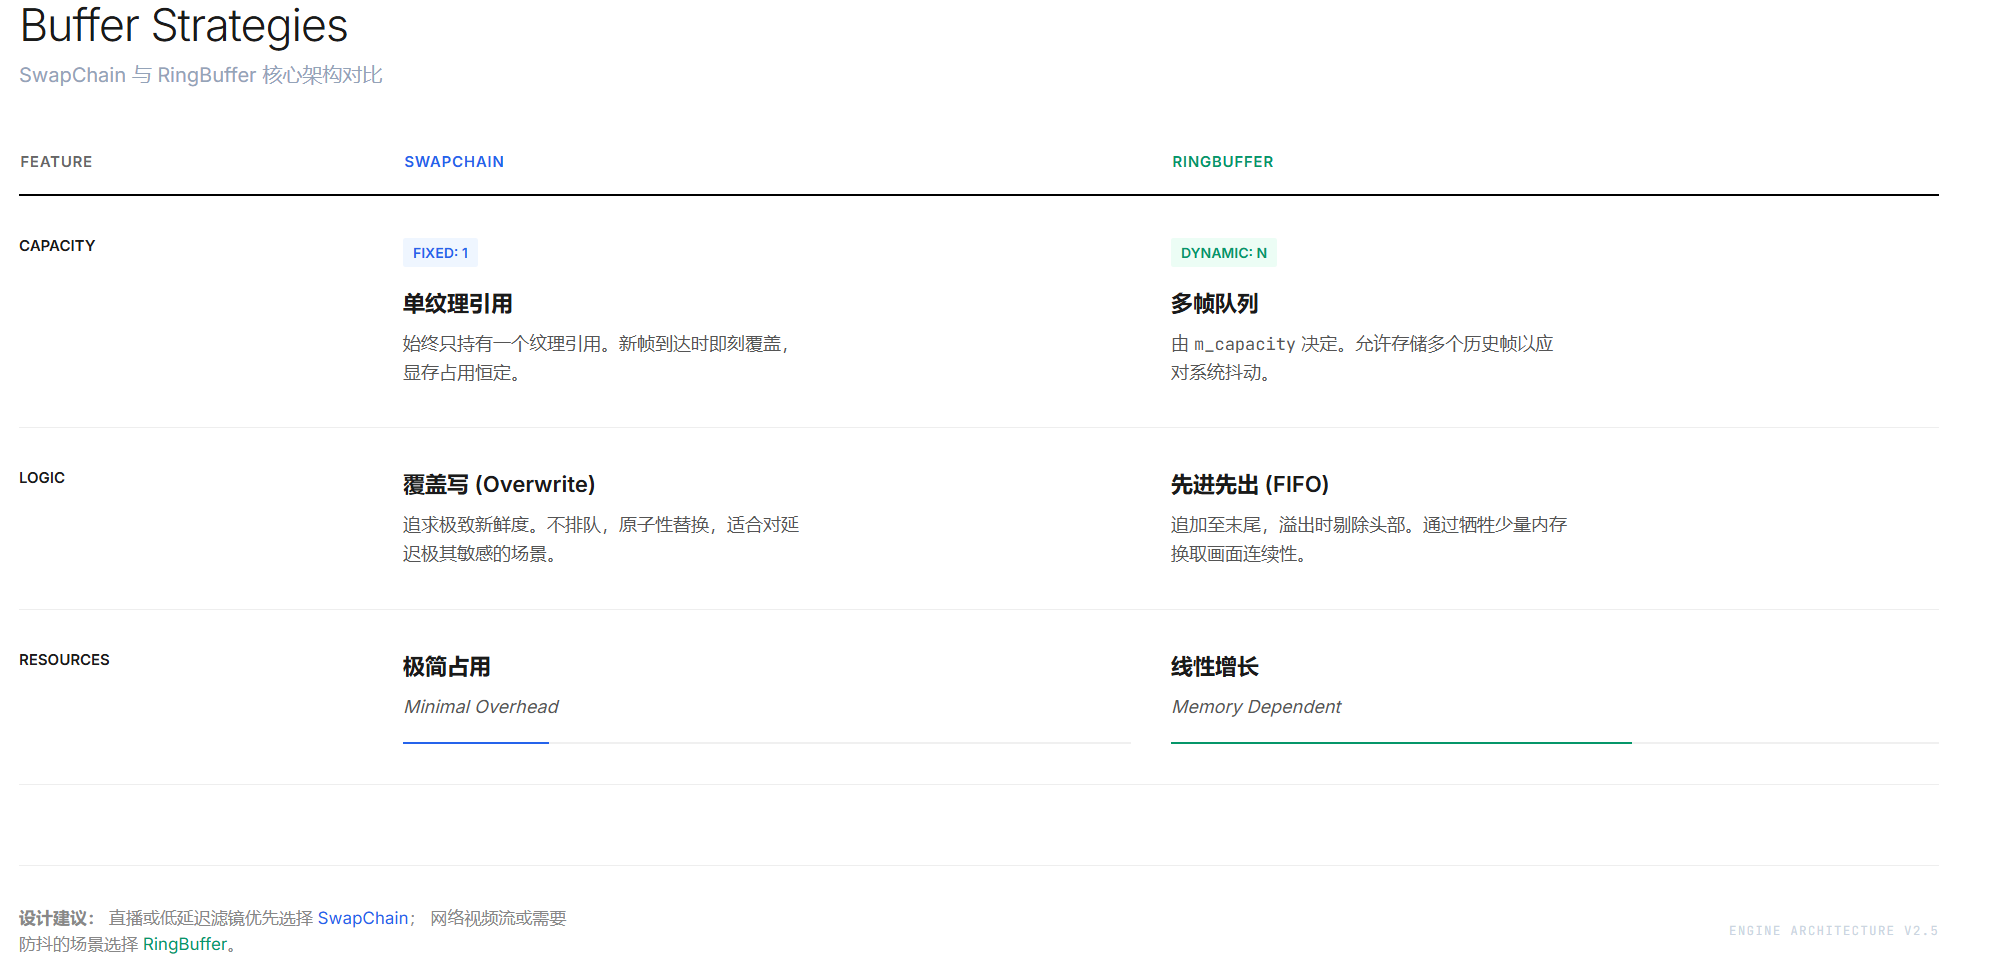
6.3.1 交换链策略(SwapChainStrategy)
原理:只保留最新的“一帧”。
适用场景:对实时性要求极高的情况(如游戏预览),宁可丢弃旧帧,也要保证显示最新帧。
源码解析:m_frontBuffer永远寸尺最后一次push进来的纹理。
6.3.2 环形缓冲区策略
原理:维护一个固定容量的队列(类似于双端队列)。
适用场景:视频录制或编码。当采集端瞬间产生多帧时,缓冲区可以起到”削峰填谷“的作用,防止数据丢失。
重点:当超过m_capacity时,移除最旧的帧,保证内存不溢出。
核心逻辑对比:
7 渲染管线
渲染管线是一系列处理阶段的集合,将3D几何数据、纹理数据和着色器指令转换为2D光栅化像素并输出到显示器。它结合了固定功能硬件和可编程着色器阶段,以实现灵活且高效的实时渲染。
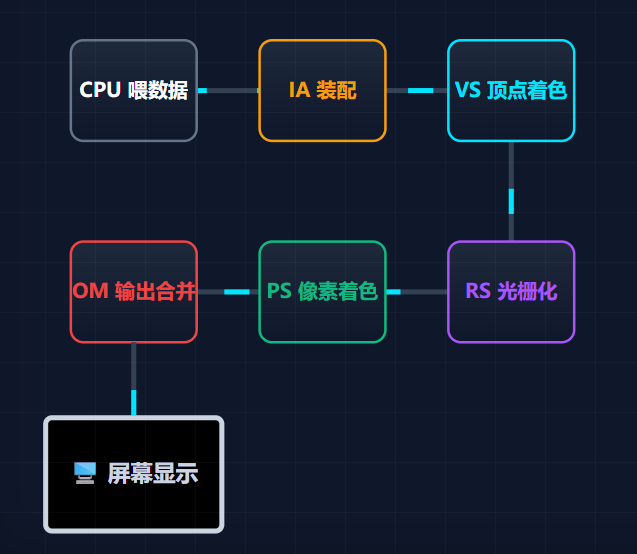
输入装配阶段: 通俗解释:备料阶段。显卡不知道什么是矩形,他只认三角形和顶点。我们需要把顶点坐标数据喂给显卡。
顶点着色器(Vertex Shader -VS): 通俗解释:塑性阶段。显卡拿到顶点后,要计算这些点最终在屏幕上什么位置。
光栅化阶段(Rasterizer - RS): 通俗解释:切割阶段。顶点连成多边形后,光栅化器会计算出这个多边形覆盖了屏幕上哪些像素点。
像素着色器(Pixel Shader -PS) 通俗解释:上色阶段。管线针对每一个被覆盖的像素点,执行一次上色程序。这需要并行计算。
输出合并阶段(Output Merger -OM) 通俗解释:完工于装裱。把像素着色器算出来的颜色写道最终的画板上(或者和弧板上原有的颜色混合)。
7.1 什么是Shader?
Shader是一段直接运行在GPU硬件上的微型、高度并发的计算程序。他是现代“可编程渲染管线(Programmable Rendering Pipeline)”的核心组件。
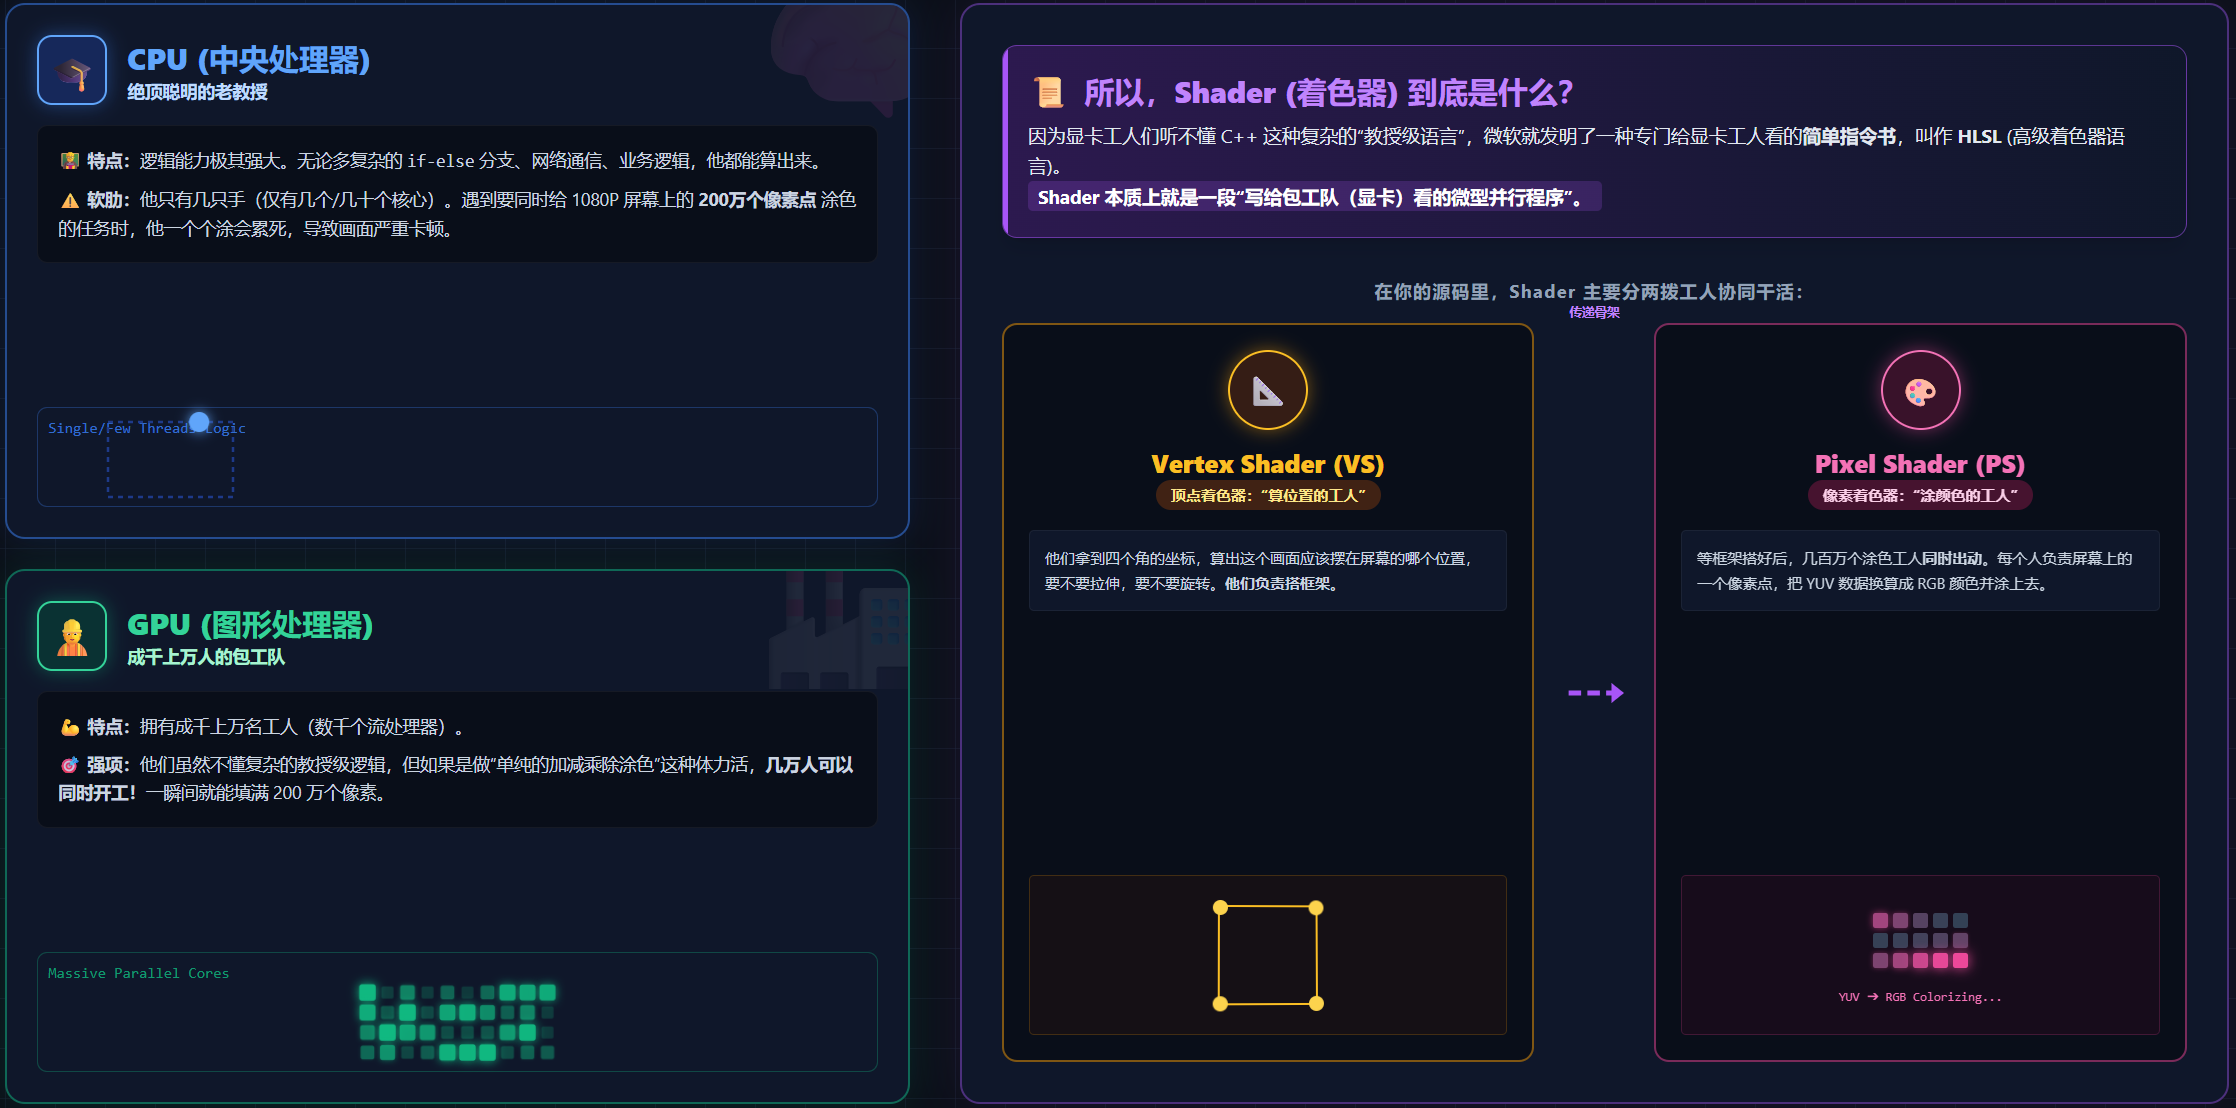
Vertex Shader
阶段定位:渲染管线的第一个可编程阶段。他的输入是单一的顶点数据(Vertex Data)。
核心职责(空间变换):针对传入的每一个顶点独立执行几何变换。他通常利用矩阵乘法。将顶点的局部空间坐标转换到归一化设备空间坐标系下的裁剪空间。
Pixel Shader
阶段定位:在经历了光栅化阶段(Rasterizer Stage,将集合图形切割成像素片段)之后执行。
核心职责(像素计算):接收经过线性插值处理后的片元(Fragement)属性,执行纹理采样、光照计算或色彩空间转换,最终输出该像素的RGBA颜色数据发送给输出合并阶段。
8 图像旋转、缩放和色彩转换
8.1 图像旋转
旋转一副图像,本质上是旋转承载这些图像的相框,即4个顶点交给了顶点着色器VS_Main重写计算旋转后的顶点坐标。
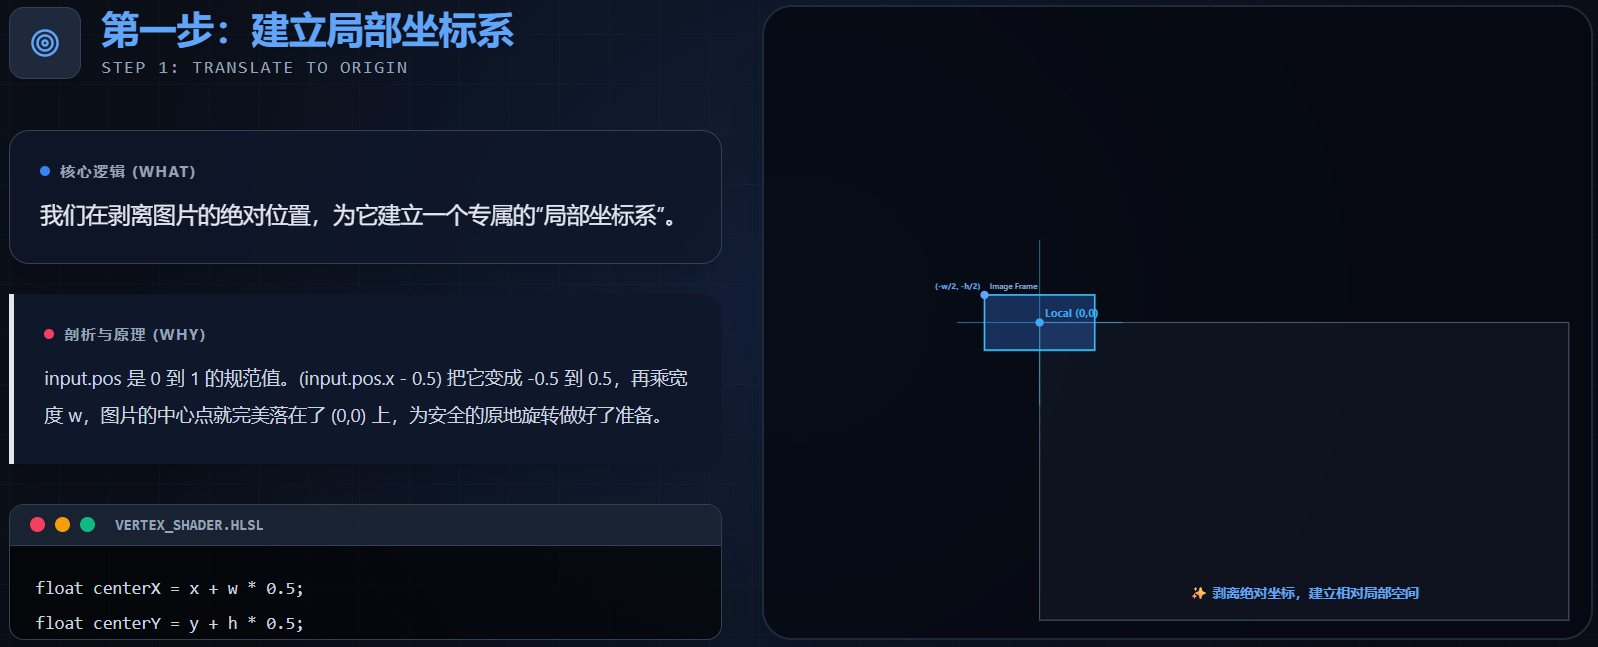
    float centerX = x + w * 0.5;
    float centerY = y + h * 0.5;
    float localX = (input.pos.x - 0.5) * w;
    float localY = (input.pos.y - 0.5) * h;
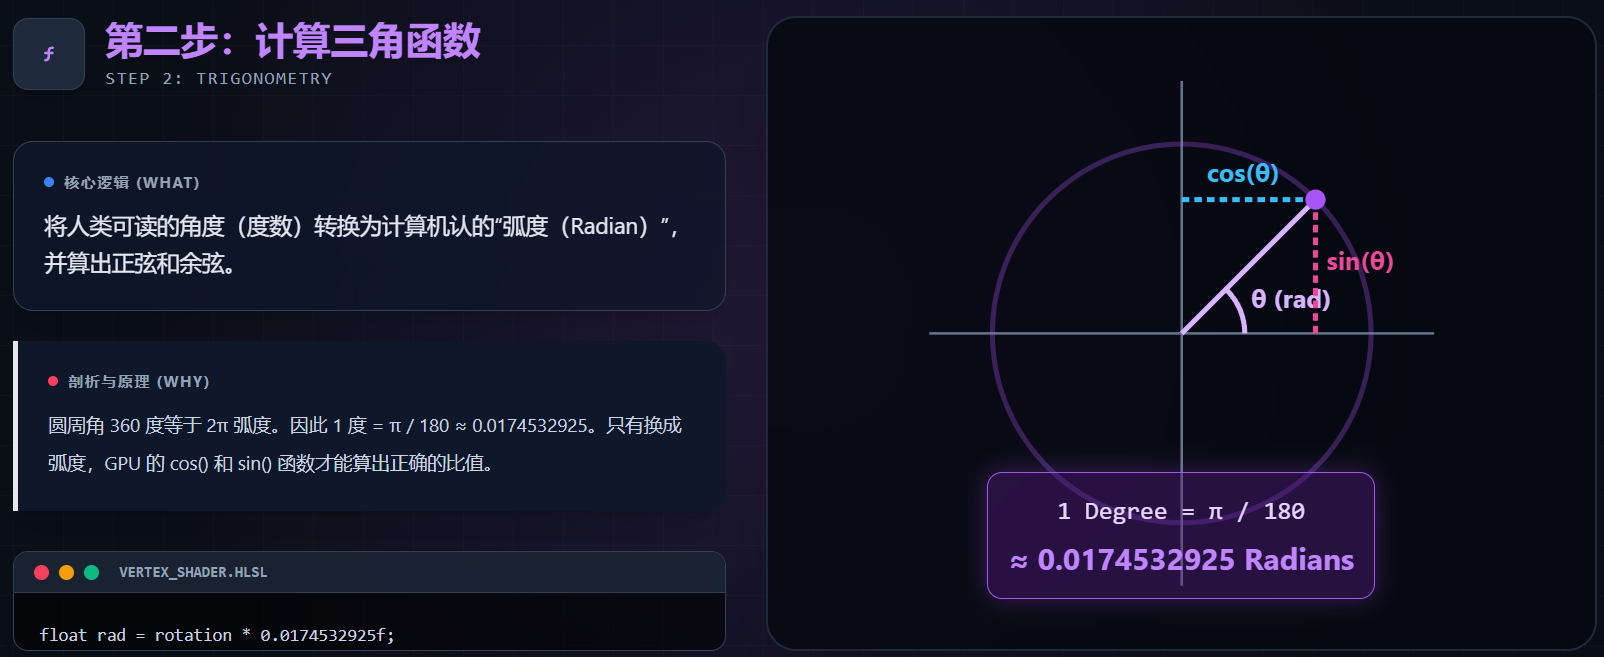
    float rad = rotation * 0.0174532925f; // 角度转弧度 (PI/180)
    float c = cos(rad);
    float s = sin(rad);
重点:HLSL里的sin()和cos()函数是直接在GPU的硬件算数逻辑单元(ALU)中执行的,速度极快。
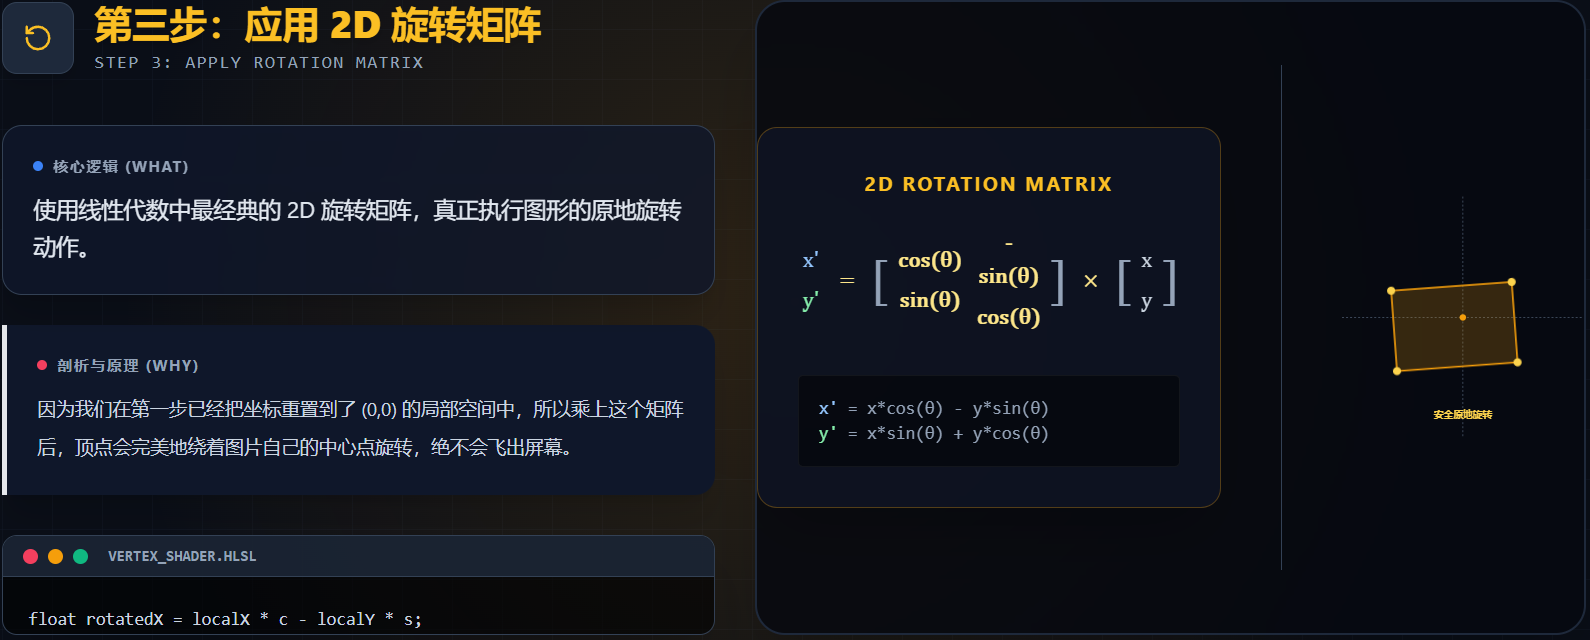
    float rotatedX = localX * c - localY * s;
    float rotatedY = localX * s + localY * c;
这是标准的2D旋转公式。在GPU中,这种乘加运算通常可以在一个时钟周期内完成。
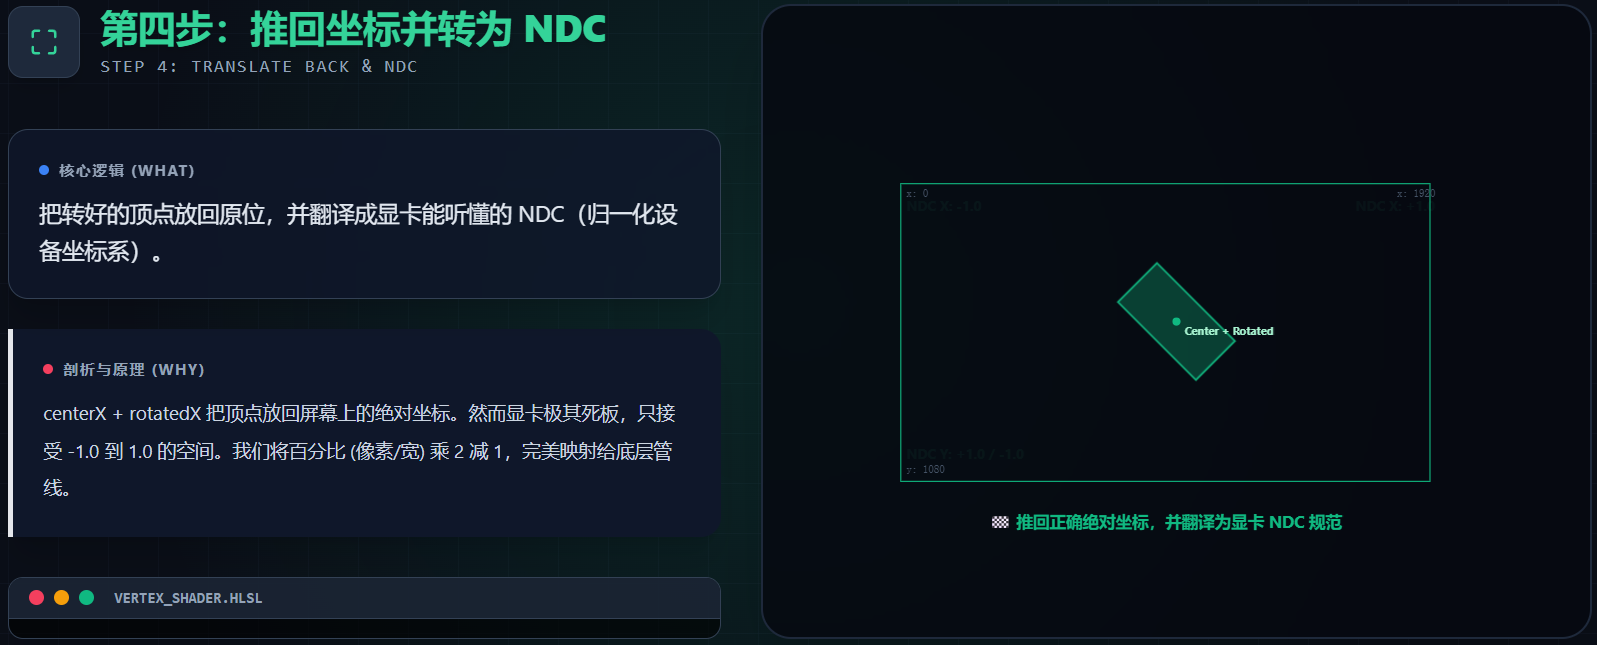
    float finalPixelX = centerX + rotatedX;
    float ndcX = (finalPixelX / canvasW) * 2.0f - 1.0f;
屏幕的像素坐标(如1920x1080)显卡是不认的,显卡只认从-1.0到1.0的坐标空间。这段代码将实际像素转化成了显卡标准的NDC坐标输出给后续的管线。
8.2 图像缩放
当一张1080p的图片被缩小到手机屏幕大小,或者放大到4K电视上,GPU是如何决定每个像素如何涂什么颜色的?这就是纹理采样。
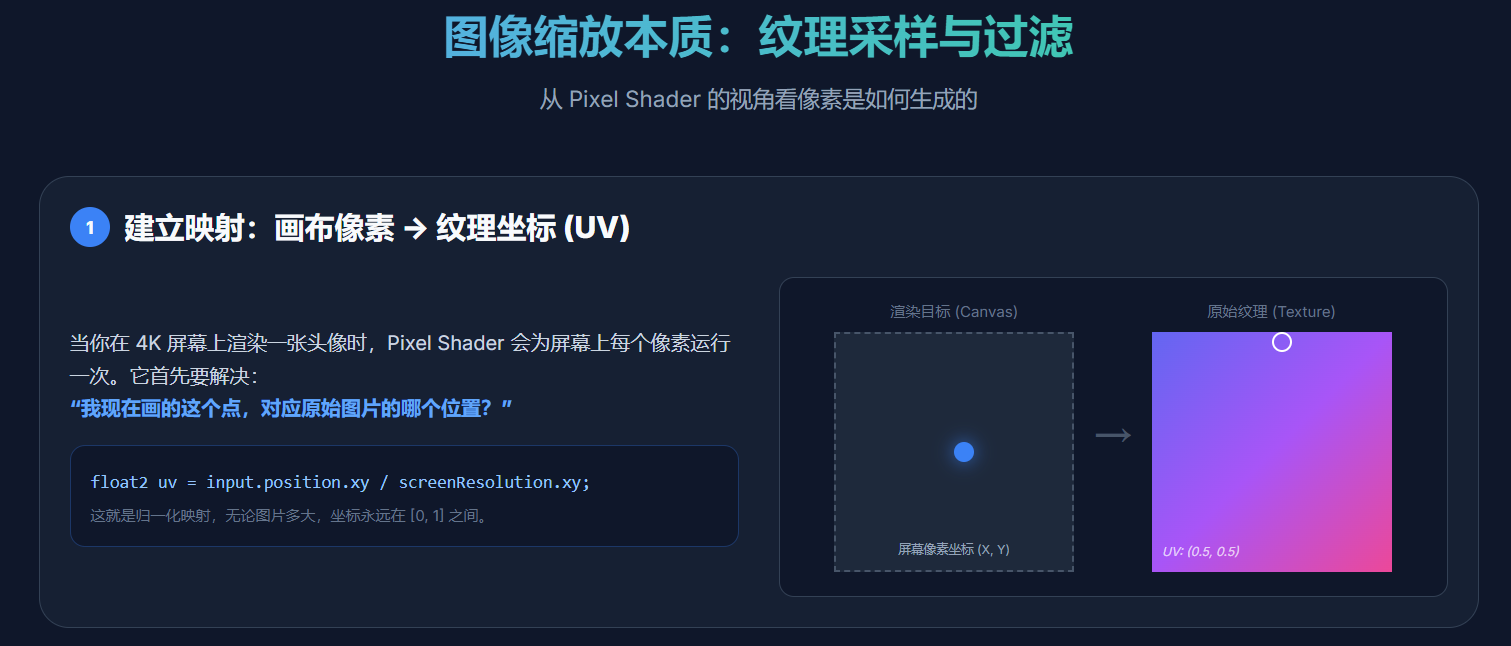
核心指令:tex.Sample在HLSL中
tex.Sample(samLinear, input.tex)
其中:
tex:是绑定到显存的原始图片。
input.tex:是当前这个像素点对应的UV坐标(范围从0到1)。
samLinear:是采样器状态。这是缩放魔法的核心。
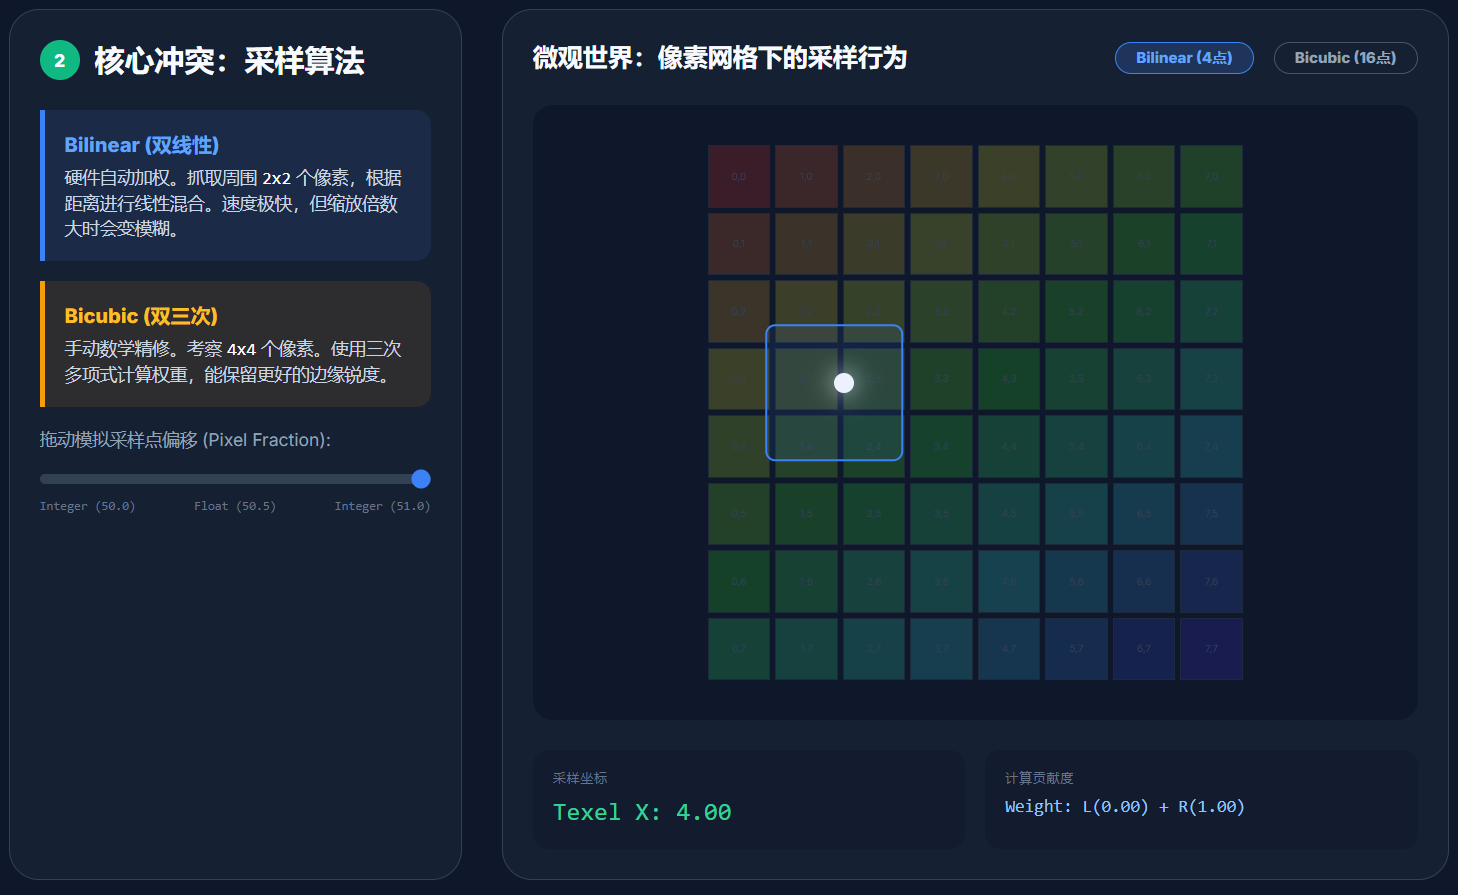
当图片放大时,UV坐标可能会落到两个真实的像素点中间。GPU会自动去抓取周围的4个真实像素,根据距离远近按比例混合出一种新的颜色。这一切都是显卡的**纹理映射单元(TMU)**在硬件层面瞬间完成,这也是Bilinear缩放极快的原因。
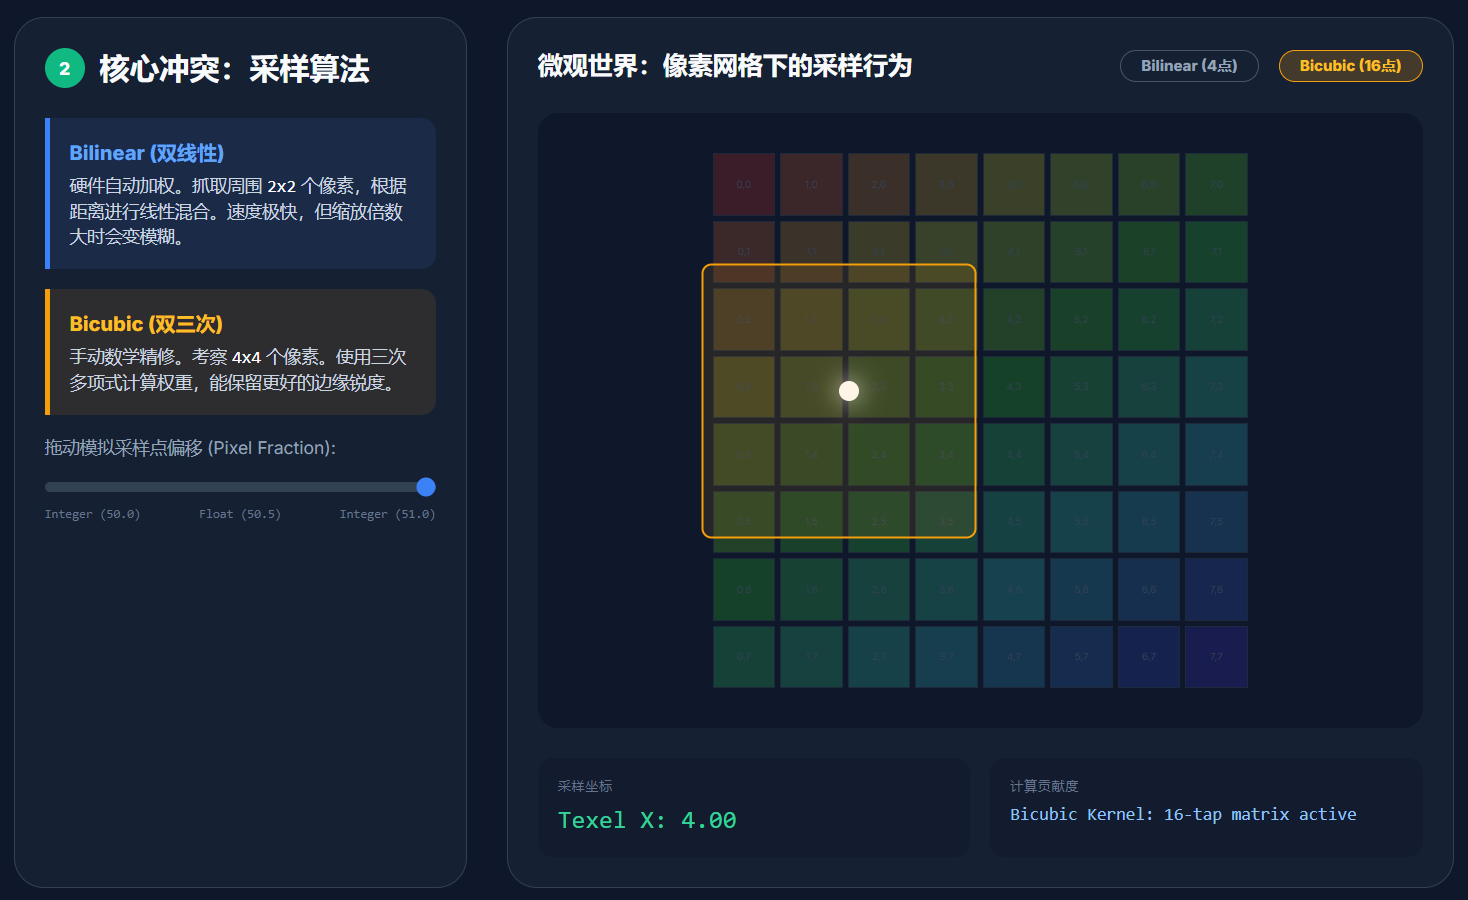
为了让画面更锋锐(没有马赛克且边缘平滑),Bicubic算法不再只看周围4个点,而是要计算周围16个点的权重。
float2 w0 = f * (-0.5 + f * (1.0 - 0.5 * f)); // 复杂的权重多项式
这中算法虽然清晰,但大量的数学计算会消耗GPU算力,通常用于高质量的最终推流画面。
8.3 色彩空间转换
这是直播和视频开发领域最值钱的知识点。摄像头和视频解码器为了省带宽,吐出的时NV12(YUV)格式;但显示器和DirectX渲染只能看懂RGB。
数学上,RGB转YUV时一组线性方程组(矩阵乘法)。例如:
Y = 0.2126 * R + 0.7152*G+0.0722*B+Offset
在HLSL中,我们不需要写加法和乘法,直接使用图形学中最强大的内建函数-点成dot():
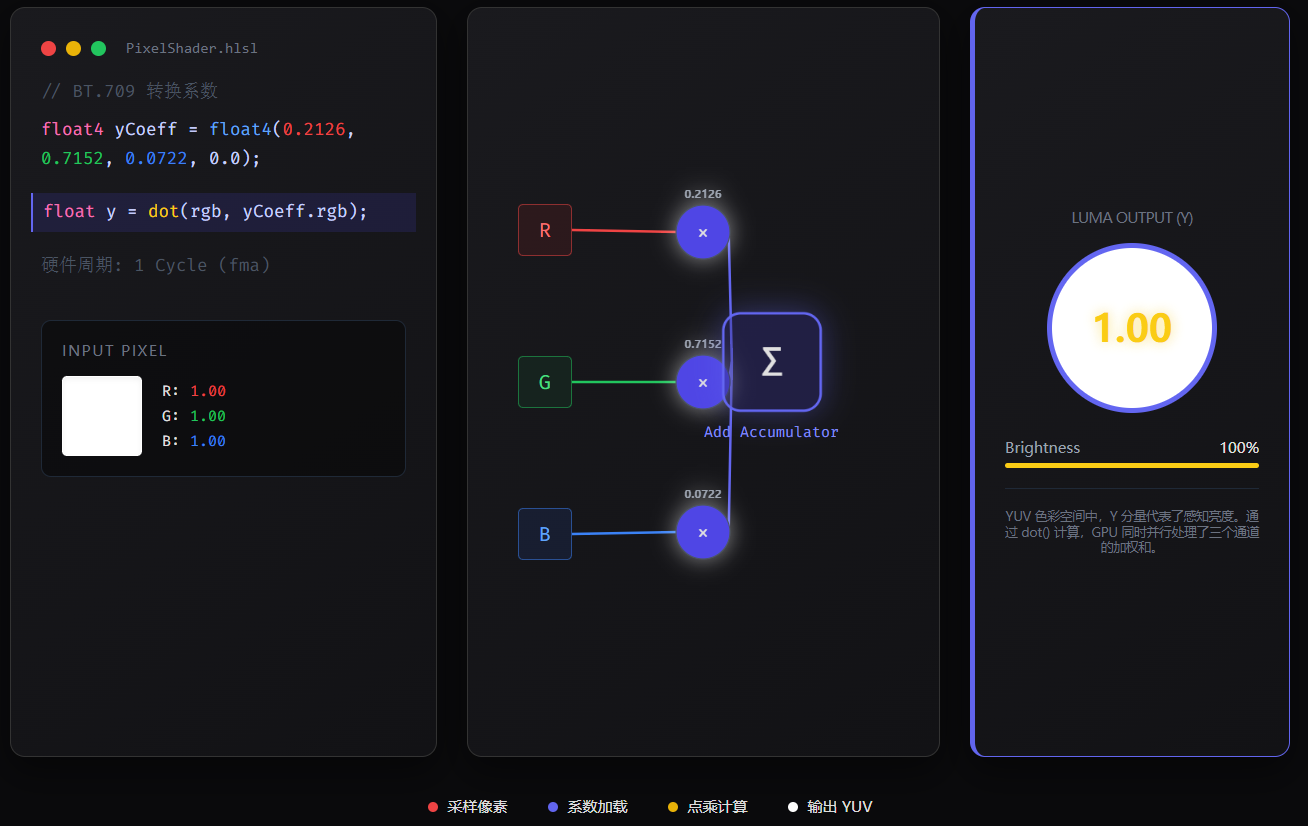
float y = dot(rgb, yCoeff.rgb) + yCoeff.a;
其中:
rgb是包含红绿蓝的3D向量float3.
yCoeff.rgb是C++通过PS_COLOR_BUFFER传进来的转换系数。
dot()指令会在底层硬件中一瞬间把对应位相乘并相加,效率很高。
9 图像输出模块
9.1接口设计
WGC采集,但为了代码的可持续支持:OBS插件采集源、纯摄像头采集源、播放器拉流采集源。
// ISource.h
class ISource {
public:
    virtual bool start() = 0;
    virtual void stop() = 0;
    // 返回的是 D3D11 的 SRV 视图,直接交给 GPU 渲染管线
    virtual Microsoft::WRL::ComPtr<ID3D11ShaderResourceView> getTexture(ID3D11DeviceContext* ctx) = 0;
};
其中:
Micrsoft::WRL::ComPtr :是管理 COM(Component Object Model,组件对象模型) 接口指针的智能指针。
ID3D11Texture2D:是真正存储像素的资源,负责承载纹理数据。
ID3D11ShaderResourceView:这个SRV 相当于 Shader 访问纹理的入口,它是对已有 GPU 资源的一种访问视图,定义着色器能够以什么格式、从哪些子资源读取数据。
这个ISource接口保证了,无论使用什么抓图,最终吐出来的都是标准版的ID3D11ShaderResourceVie(SRV)。渲染层(View层)拿到这个SRV直接丢给Shader就能画出来,完全不需要知道底层是WGC还是摄像头。这个就是高内聚、低耦合。
总结:ISource 解决的是软件架构中的“如何统一访问不同图像源”,比如摄像头捕获的是NV12的图像源,WGC捕获的是BGRA的图像源。
详细的捕获后渲染管线流程可以看这里:《从零理解实时视频渲染管线:纹理池、图像混合与合成输出》