1 架构概述
在实时音视频(RTC)与高并发直播推流的场景中,系统往往面临极高的性能与稳定性要求。
传统的单线程同步推流方案在面对网络抖动或算力瓶颈时,极易导致主渲染管线阻塞,进而造成全局画面的卡顿甚至程序崩溃。
为了构建一个健壮的工业级直播与录制引擎,本系统摒弃了简单的同步回调模型,采用高度解耦的异步流水线(Asynchronous Pipeline)架构与多级生产者-消费者(Producer-Consumer)模型。
在设计前,本架构致力于解决四大企业级核心痛点:
1.1 网络阻塞渲染(I/O瓶颈)
- 推流过程中的网络延迟绝对不能反向阻塞GPU/CPU的渲染帧率。
1.2 多源音画同步(A/V Sync)
- 系统音频、麦克风音频与视频帧在不同时钟域产生,必须在底层实现精准对齐。
1.3 推播矩阵的算力优化
- 针对同时推流至多个平台(如RTMP矩阵)外本地录制的场景,必须避免重复编码带来的算力雪崩。
1.4 弱网抗抖动能力(QoS保障)
- 在带宽突降的恶劣网络环境下,系统需具备则我降级与平滑恢复的动态流控能力。
1.5 架构设计
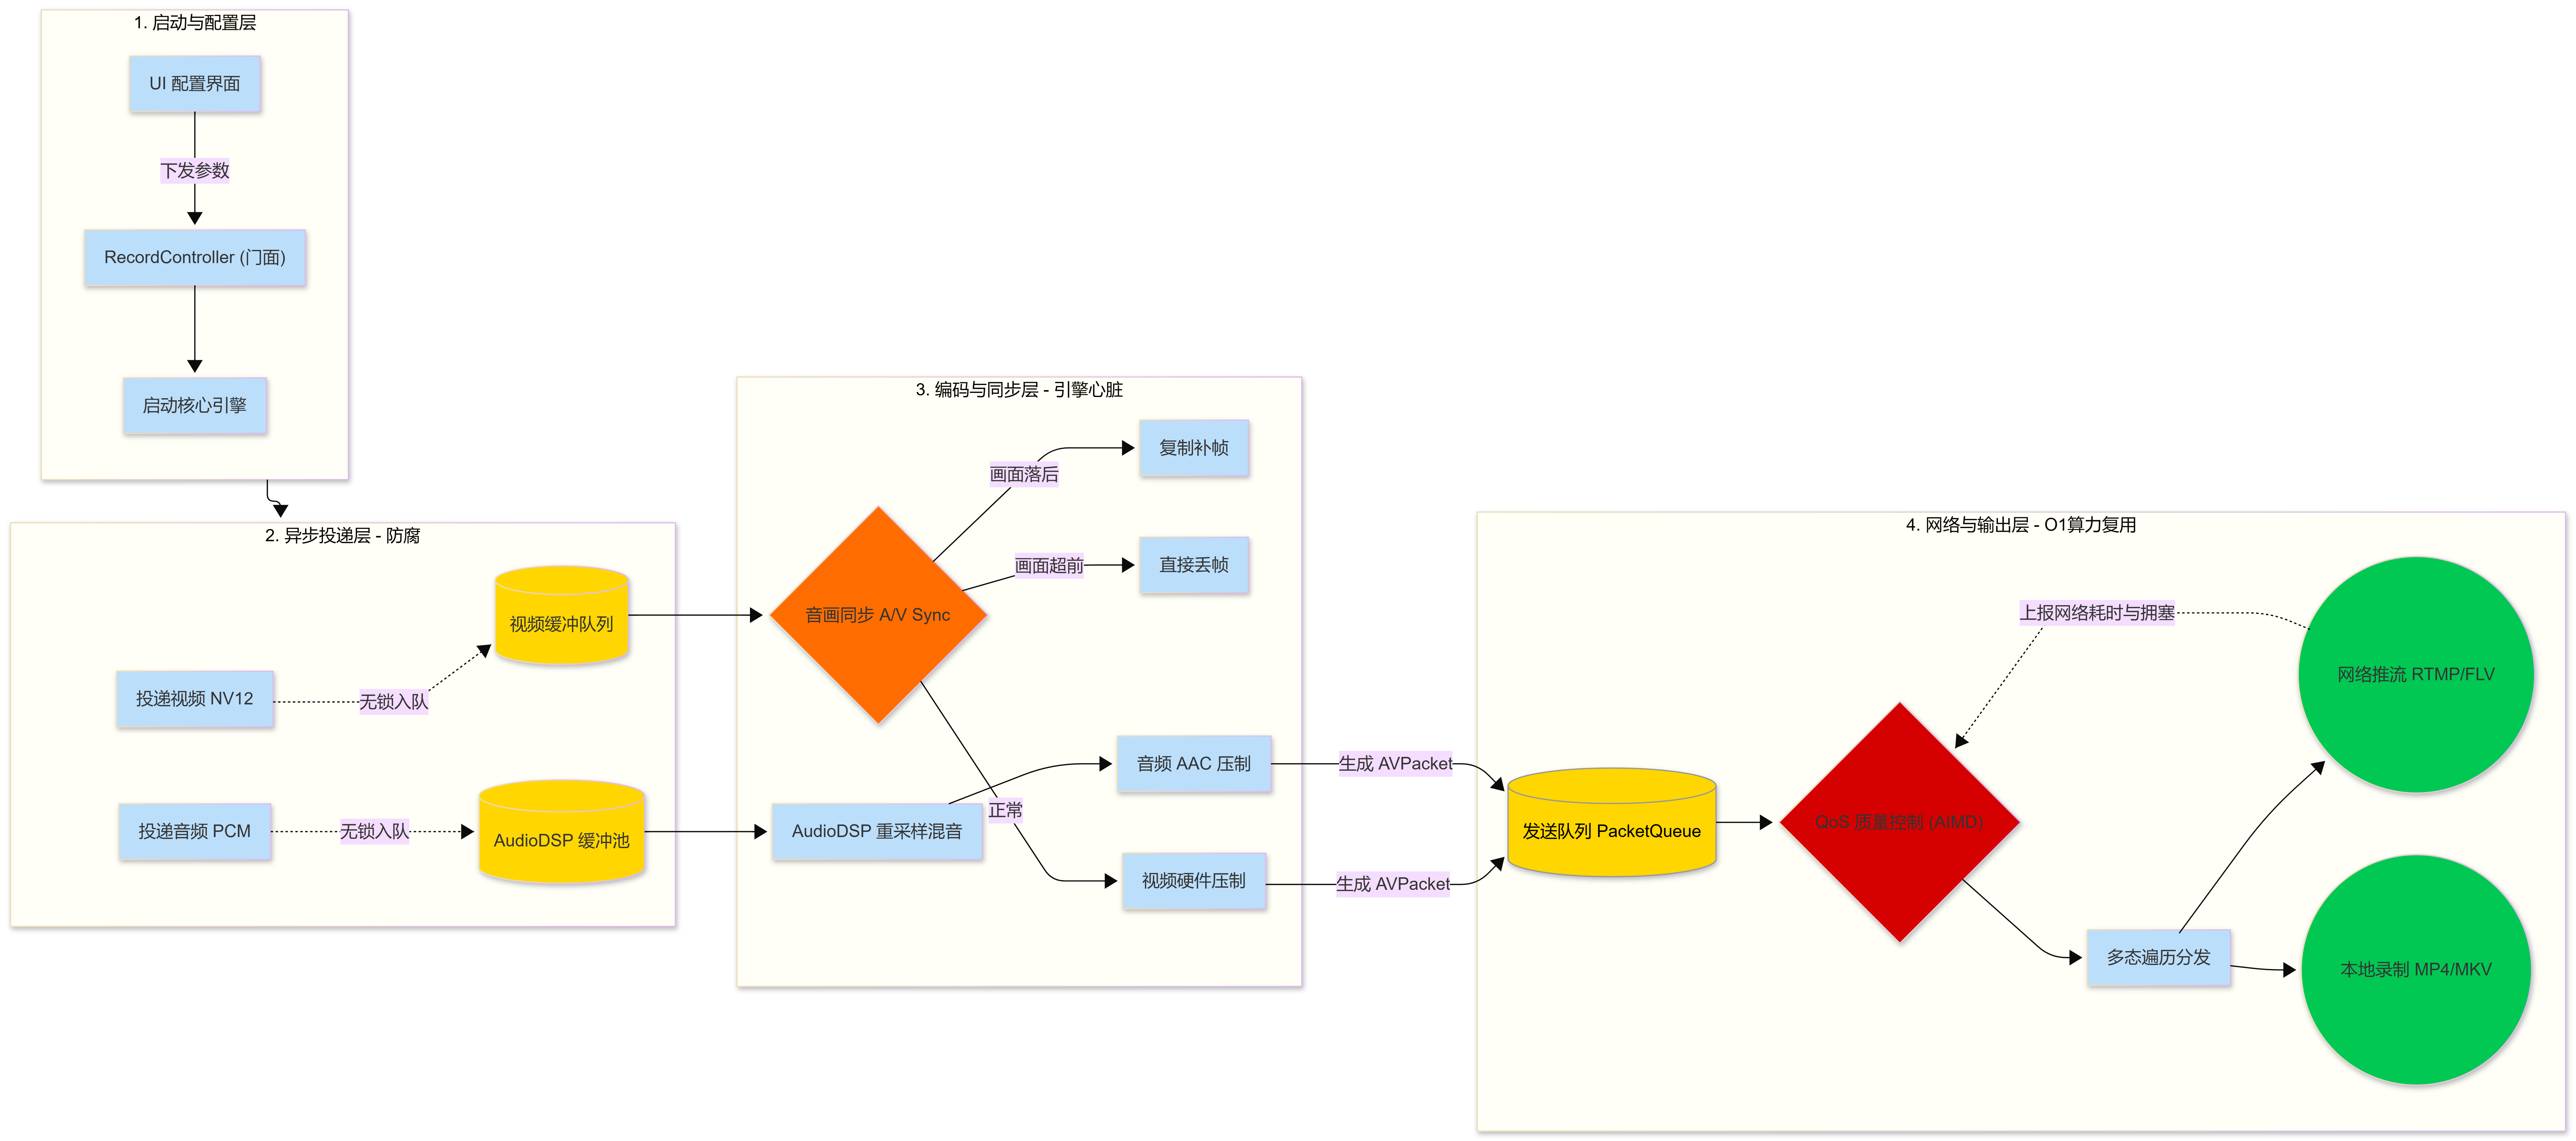
本架构没有采用简单的单队列缓冲,而是根据业务的“计算密集度”与“I/O密集度”差异,设计了两级物理隔离的生产者-消费者边界。
这种设计使得UI渲染、音视频编码、网络发送三大核心模块在各自独立的线程域中全速奔跑。
1.5.1 渲染主线程与编码子线程
目标:绝对保护UI主线程的极致流畅,防止编码耗时拖慢渲染帧率。
生产者(Producer):系统的UI渲染层(如ScreenWindow)。他负责以极高的频率产生NV12视频帧或PCM音频数据,并通过统一门面RecordController的addVideoData和addAudioData接口投递数据。
缓冲队列(Queue):底层维护了轻量级、无锁化(或极低锁争用)的m_videoQueue队列和AudioDSP缓冲池。
消费者(Consumer):FFmpegRecorder作为系统的心脏线程,在主循环中不断从队列中取出原始数据(Raw Data)进行后续处理。
解耦效果:渲染线程执行投递动作后瞬间返回,实现了真正的“非阻塞”调用,彻底切断了C++复杂内存管理对上层业务的干扰。
1.5.2 编码子线程与I/O发送线程
目标:彻底切断网络抖动对音视频压制管线的反噬。
- 生产者(Producer):依然是FFmpegRecorder线程他将原始音视频帧进行软/硬编码后,生成压缩后的数据包(AVPacket)
- 缓冲队列(Queue):线程安全的核心队列PacketQueue。
- 消费者(Consumer):独立的网络/文件I/O线程StreamSender。他负责通过pop()阻塞获取队列中的数据包,并执行耗时的网络Socket发送或磁盘写入。
- 解耦效果:即使推流时遭遇严重断网,av_interleaved_write_frame的阻塞也只会卡住StreamSender线程。此时编码器依然可以全速运转将AVPacket压入队列,为后续的QoS熔断争取了宝贵的缓冲时间。
2 直播vs录播差异
- 直播推流:将编码后的音视频数据,像流水一样实时发送到远端的流媒体服务器(例如通过RTMP协议)。它的核心诉求是低延迟和抗网络抖动。
- 录播/录制:将编码后的数据,按照特定的封装格式(入MP4、MKV)安全地写入磁盘。它的核心诉求是高画质和文件完整性。
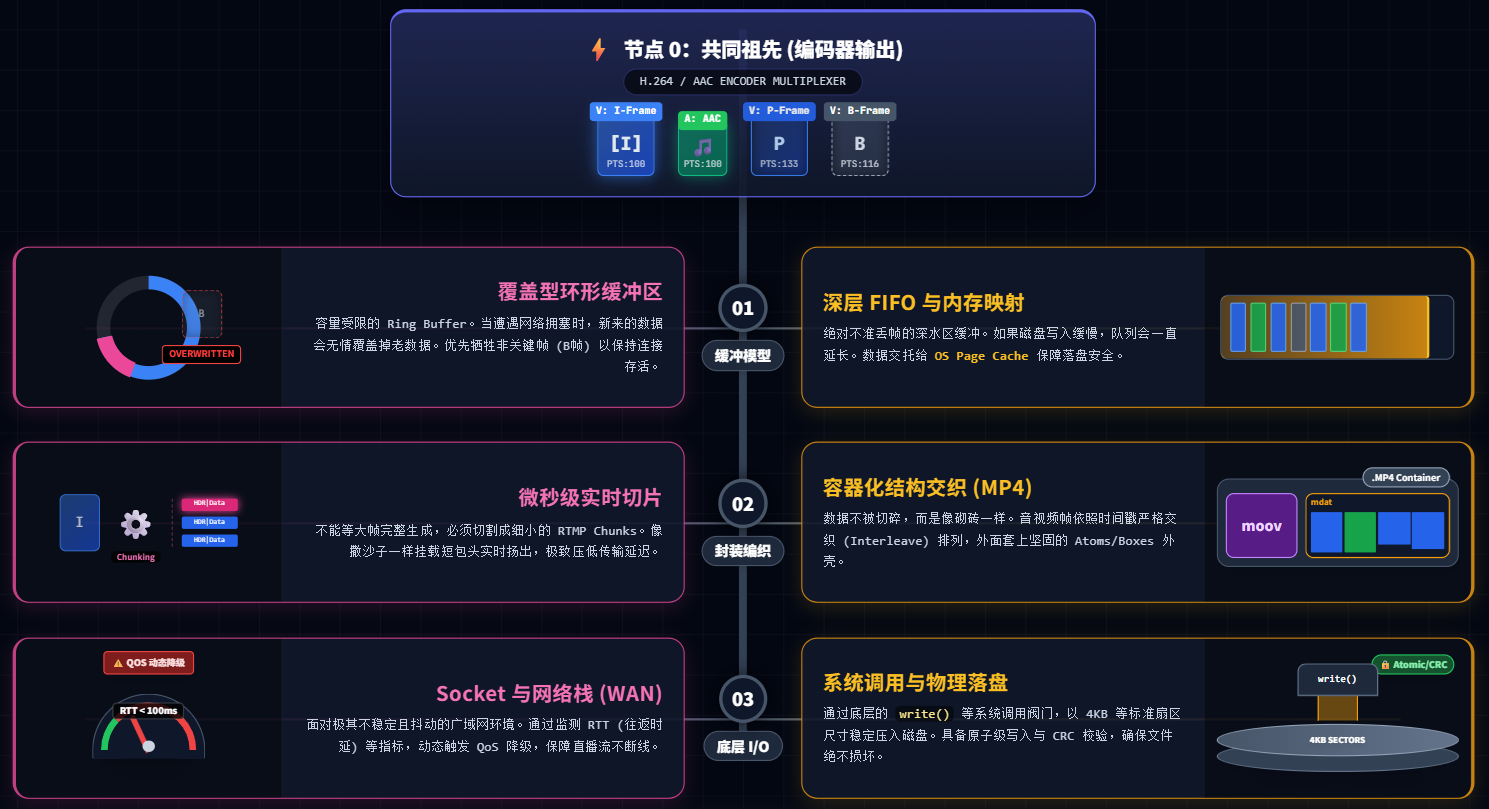
在FFmpeg世界里,无论直播还是录播,前端的采集、重采样、H.264编码过程是完全共用的。他们唯一区别发生在最后一步:复用(Muxing)与IO。
编码器吐出来的是纯粹的H.264视频流,他不能直接传输或播放。我们需要把它装进一个”盒子“(FLV或MP4格式),这个装盒子的过程叫做Muxing。
3 YUV与RGB格式区别
在传统的RGB24格式中,每个像素需要3字节(红、绿、蓝各1字节)。但人类的眼睛有个生理Bug:对亮度(黑白轮廓)极其敏感,但对色彩(亮度)的变化很迟钝。
Y(Luma):代表亮度(黑白画面),必须全部全量保留。
U(Cb)和V(Cr):代表色彩。既然人眼对色彩迟钝,我们干脆让每4个Y共享1个U和1个V。这就是4:2:0色度抽样。
体积锐减50%的魔法算术题:
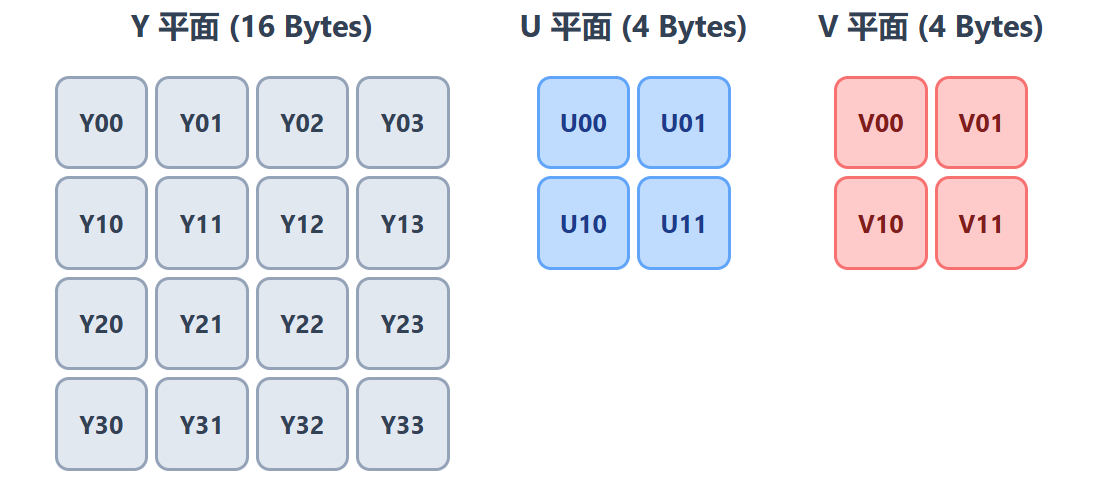
假设有一块4x4的图像(16个像素):
RGB24需要体积:16x3=48字节
YUV420需要体积:16Y+4U+4V=24字节
3.1 YUV4:2:0与NV12内存布局
3.1.1 YUV420P
在内存里,这24个字节的存放方式:Planar(平面格式)的逻辑最简单粗暴:Y、U、V三个平面独立存。
3.1.2 NV12
YUV420P需要维护3个内存指针(Y、U、V),在GPU渲染时,需要发起3次内存读取操作。为了提速,微软和各种硬件厂商主推了NV12(Semi-Planar)格式。 他的规则是:Y依然全部连续存放,U和V交替存放.
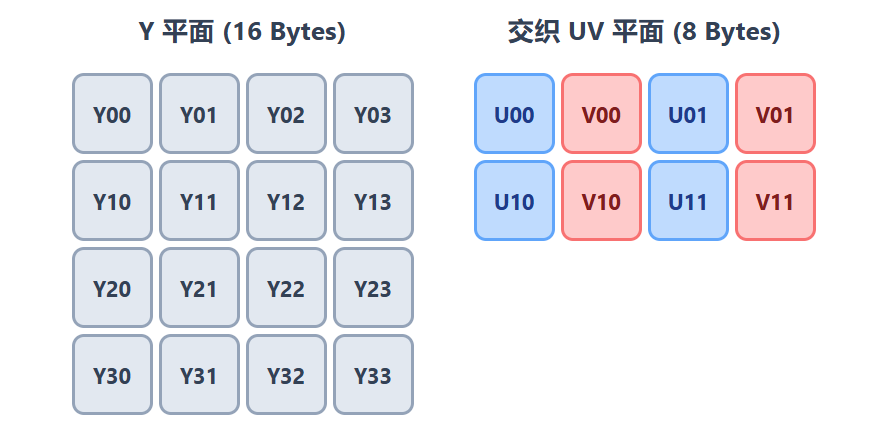
当把NV12丢给OpenGL或Direct3D渲染时,GPU只需要创建2个纹理(Textures)。取色度时,GPU的采样器一次读取2个字节,瞬间就能拿到U和V还原色彩,极大地提高了Cache的命中率。
4 GPU纹理零拷贝(Zero-Copy)
传统的音视频处理中,“GPU渲染”->下载至CPU内存->上传至编码器显存的链路引发严重的PCle总线拥塞与CPU占用突增。
4.1 触发条件
在processVideo函数中,系统回进行校验,当同时满足以下三个条件时,触发零拷贝:
1.传入的数据包含有有效的ID3D11Texture2D显存句柄。
2.编码器为硬件加速模式(如:h264_nvenc)。
3.渲染输出分辨率与目标分辨率完全一致。
4.2 实现原理
//在纯GPU路径中,系统绕过了像素级别的字节操作,直接将D3D11 Texture 的显存地址(Pointer)绑定至AVFrame的数据域。
srcFrame->format = AV_PIX_FMT_D3D11;
srcFrame->data[0] = (uint8_t*)data.texture.Get(); // 显存指针直通
srcFrame->hw_frames_ctx = av_buffer_ref(m_vEncoder->getHWFramesRef());
4.3 容灾与降级方案
当必须使用软件编码器,或目标推流分辨率于渲染分辨率不一致时,系统必须将GPU显存数据回读(Download)至CPU内存。
4.3.1 Staging Texture中转机制
标准的渲染纹理通常位于显卡高速区,禁止CPU直接访问。系统通过创建一个带有D3D11_USAGE_STAGING标志和D3D11_CPU_ACCESS_READ权限的中转纹理,将渲染结果拷贝至此,再通过Map与Unmap接口建立CPU寻址映射。
显存行跨度安全拷贝策略
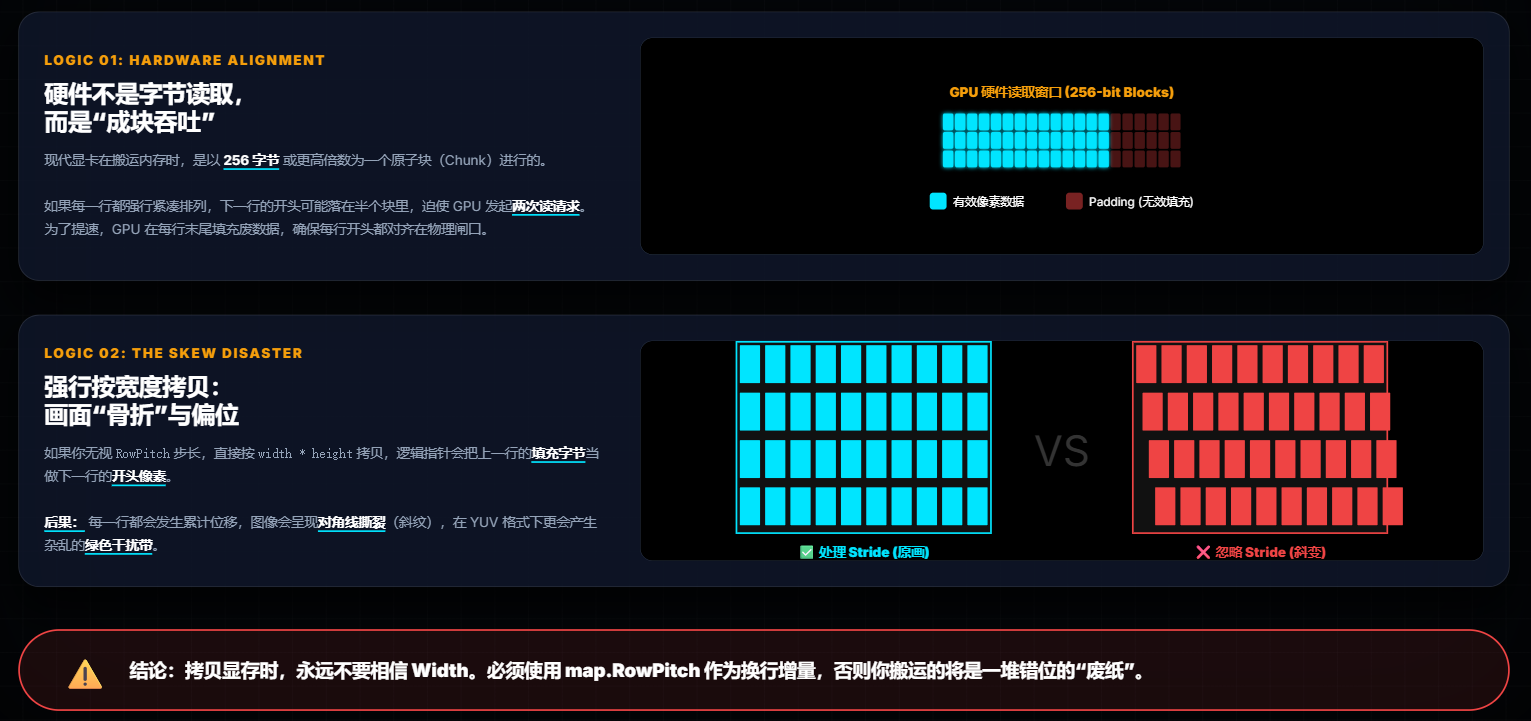
这是图形编程汇总最易引发内存越界和画面畸变(如绿屏、斜纹偏移)的风险点。现代GPU为提升寻址效率,往往会对每一行像素进行字节填充(Padding),以满足特定的字节对齐(如256或512字节对齐)。因此,显存中每一行的实际步长(Row Pitch)往往大于图像的真实有效宽度(Width)。
在downloadTexture函数中,系统严格舍弃了不安全的整块memcpy,采用了基于步长的精确剥离拷贝算法:
// 剥离填充字节,逐行安全拷贝 Y 分量
for (int i = 0; i < height; ++i) {
    memcpy(dstY + i * width, src + i * map.RowPitch, width);
}
// 剥离填充字节,逐行安全拷贝 UV 分量
for (int i = 0; i < height / 2; ++i) {
    memcpy(dstUV + i * width, src + ySize + i * map.RowPitch, width);
}
该算法保证了从异构硬件读取的YUV数据能够完美映射回标准的密集排列内存,根绝了画面的倾斜失真。
4.4 格式转换与缩放
在提取到安全的纯净内存数据后,若业务层配置了分辨率缩放(例如:1080P降采样至720P),系统将介入FFmpeg提供的libswscale组件。
4.4.1 上下文复用机制
为了保障严格条件下的60FPS实时处理要求,系统在initScaler中通过sws_getCachedContext实现了缩放上下文与缓冲内存的生命周期复用。避免了每秒数十次的大对象动态分配操作。
// FFmpegRecorder.cpp
bool FFmpegRecorder::initScaler(int inW, int inH, int inFmt, int outW, int outH, int outFmt) {
    // 如果上下文已存在且参数未变,直接复用
    m_swsCtx = sws_getCachedContext(m_swsCtx,
                                    inW, inH, (AVPixelFormat)inFmt,
                                    outW, outH, (AVPixelFormat)outFmt,
                                    SWS_BICUBIC, nullptr, nullptr, nullptr);

    if (!m_swsCtx) return false;

    // 准备缩放后的 AVFrame 容器,仅在尺寸变化时重新分配 buffer
    if (!m_scaledFrame) {
        m_scaledFrame = av_frame_alloc();
    }
    // ... 检查并执行 av_frame_get_buffer
}
4.4.2 缩放滤波器
根据性能与画质的不同权衡,底层系统支持根据配置枚举应用不同的重采样数学模型:
// 配置定义见 RecorderConfig.h
enum class DownscaleFilter {
    Bilinear,   // 线性插值 (快)
    Bicubic,    // 三次卷积 (清晰)
    Lanczos     // 兰索斯 (锐利, 推荐)
};
- Bilinear(双线性插值):运算耗时最低,但在处理文字边缘时可能出现轻微模糊。
- Bicubic(三次卷积插值):平滑度提升,适合大多数日常场景。
- Lanczos(兰索斯重采样):保留极高的高频细节与锐利度,但CPU计算开销最大。强烈推荐用于复杂游戏画面的推流降采样。
// FFmpegRecorder.cpp
if (needScale) {
    // 1. 确保缩放器已初始化为 NV12 -> NV12
    if (initScaler(data.width, data.height, AV_PIX_FMT_NV12, targetW, targetH, AV_PIX_FMT_NV12)) {
        // 2. 执行真正的图像重采样
        sws_scale(m_swsCtx, srcFrame->data, srcFrame->linesize, 0, data.height,
                  m_scaledFrame->data, m_scaledFrame->linesize);

        // 3. 将工作指针指向缩放后的内存块
        frameToEncode = m_scaledFrame;
    }
}
5 音频重采样
- 采样率(Sample Rate):
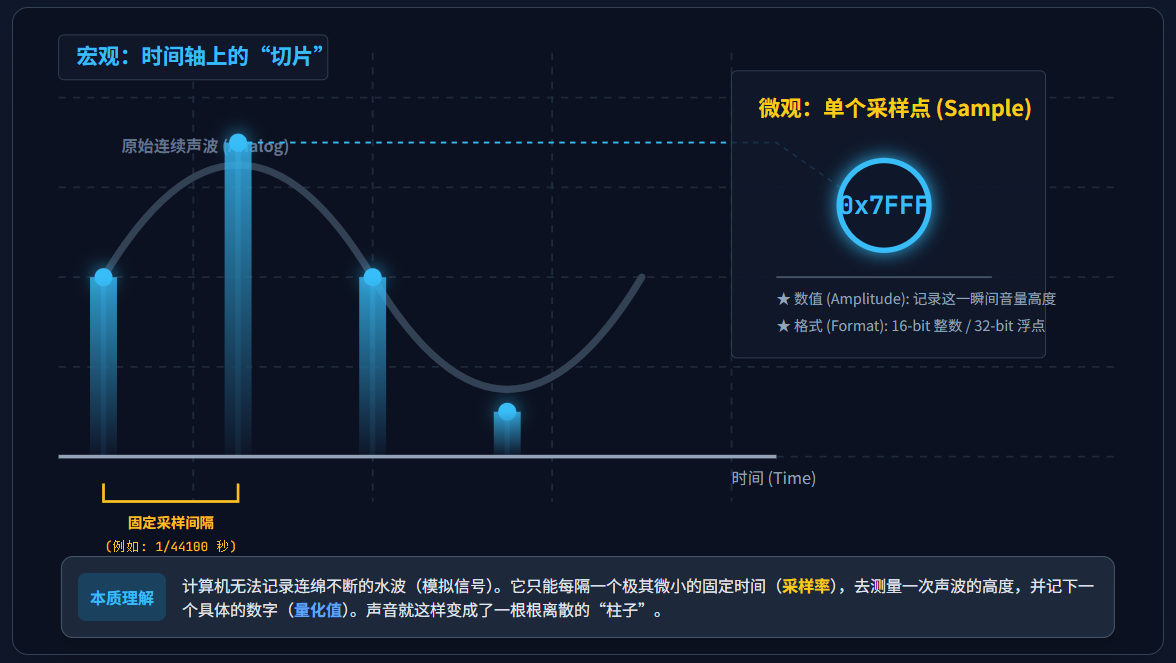
就是计算机一秒钟量多少次。比如常见的44100,就是一秒钟量4410次高度。
什么是重采样?
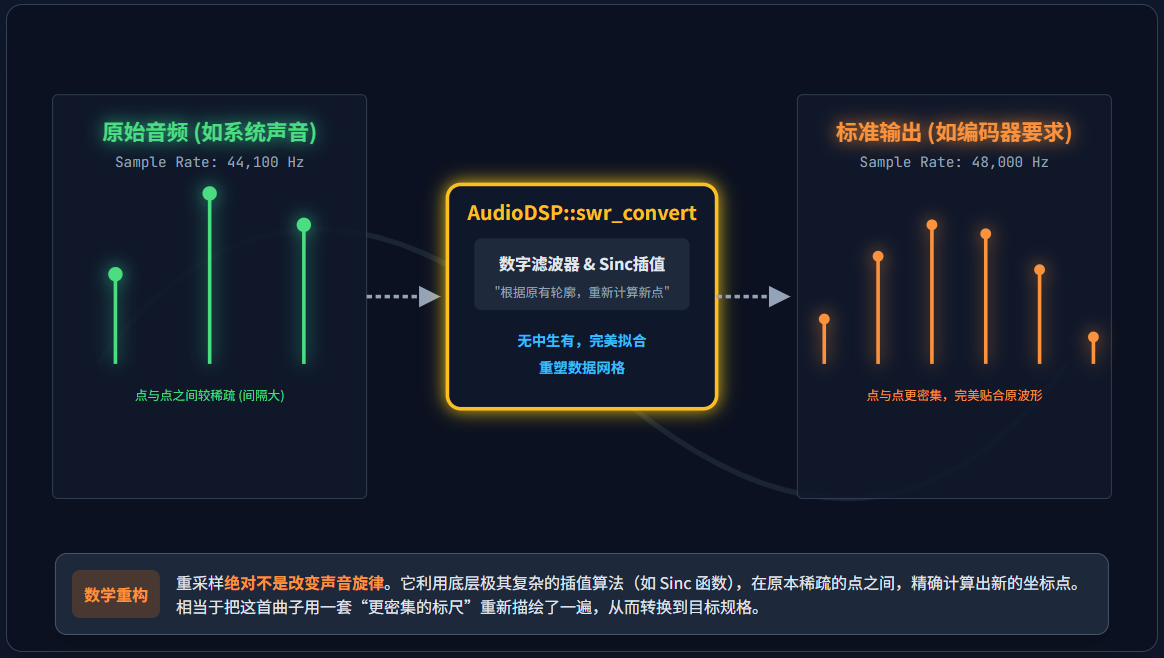
就是把”一秒钟量4万次“的音频,硬生生转换成”一秒钟量4.8万次“的音频。
- 为什么必须重采样?
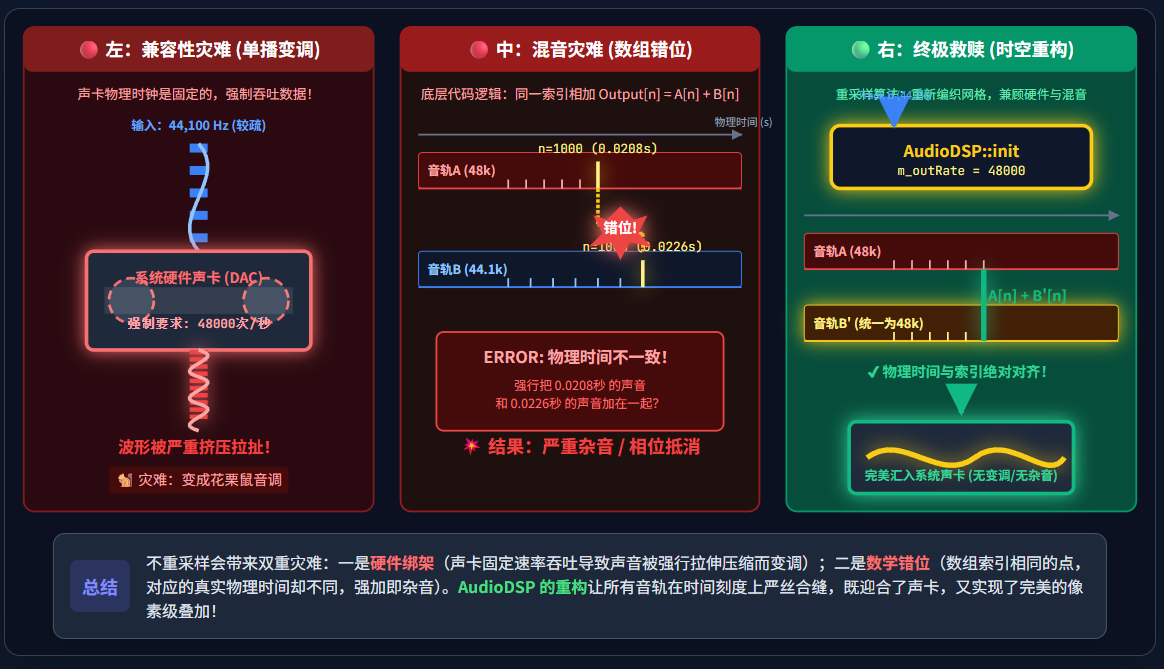
想象,麦克风是一个急性子,一秒钟给你48000个数字。但系统电脑声音是一个慢性子,一秒钟只给你44100个数字。这两个声音就像在说方言。在代码中,我们在AudioDSP::init里设定了一个”普通话“标准(也就是统一的输出采样率m_outRate)。所有声音进来,都必须先被“翻译”成这个统一的标准,这就是重采样。
5.1 基于FFmpeg API
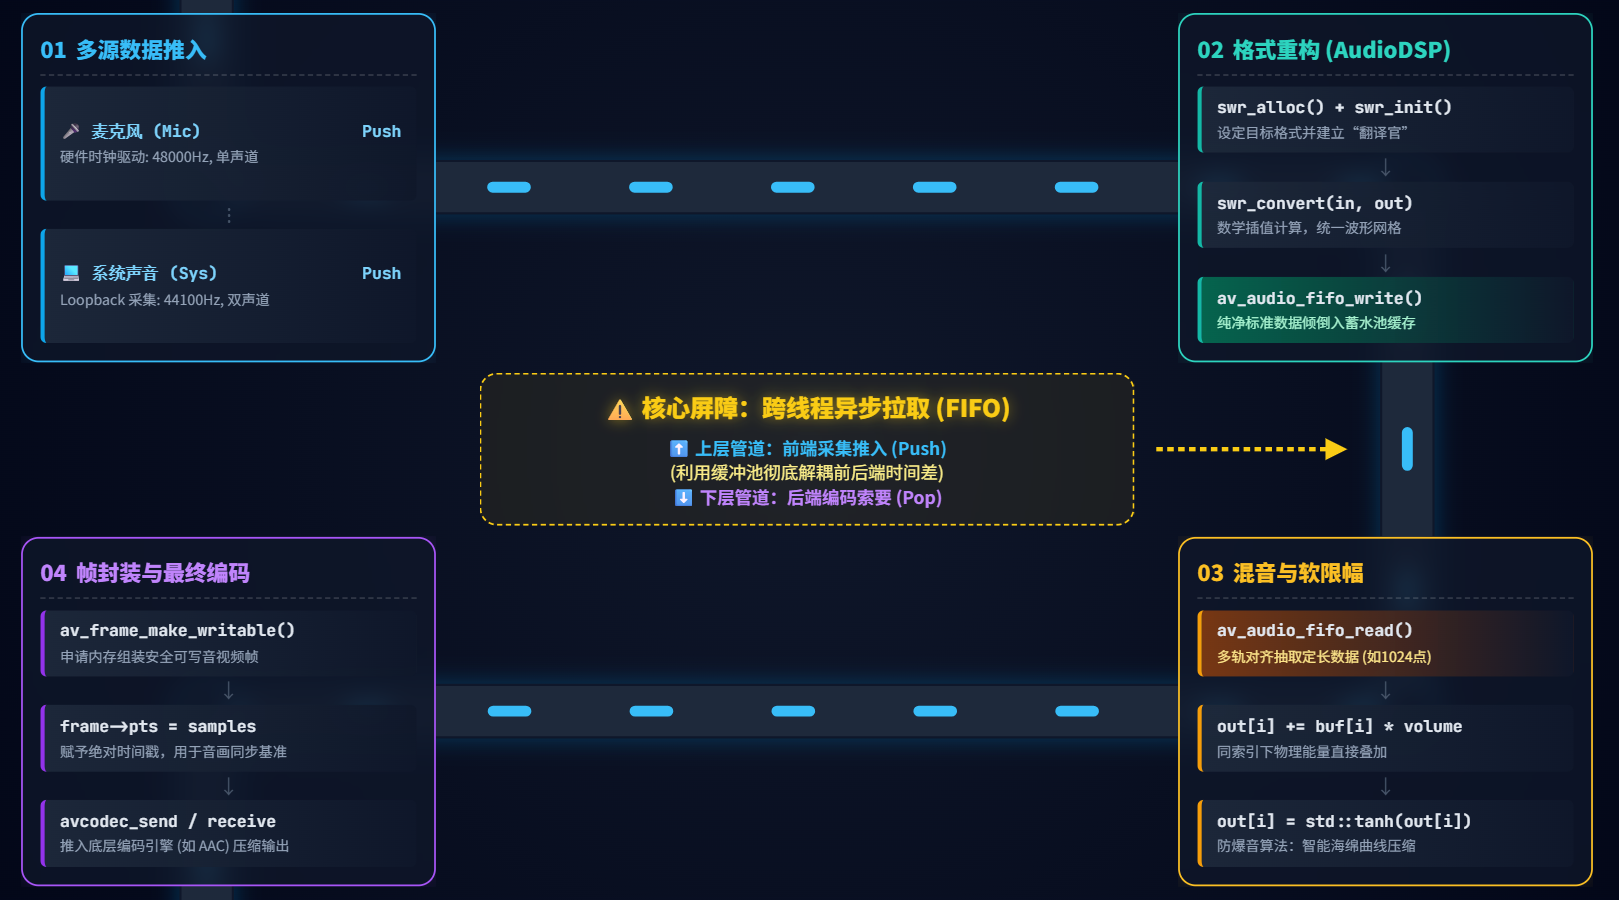
swr_alloc_set_opts2和swr_init(翻译官入职):这就是相当于我们雇佣一个“声音翻译官”。
swr_convert(翻译官干活):实际把一串串音频数字送给翻译官,他帮你转换成目标数字输出出来。
AVAudioFifo(蓄水池):这是一个超级关键的组件。因为麦克风和电脑给声音的速度是一阵一阵的(有时多有时少),而我们后续打包处理声音时,每次需要的量是固定的。所以我们建了一个FIFO“蓄水池”。翻译官翻译完的声音,先倒进这个池子里存着,等后续需要的时候,再用固定的大小将其平稳取出。
6 音频混音
**什么是混音?**简单来说,就是让你在看直播时,既能听到主播说话的声音(麦克风),又能听到游戏里的枪声(系统声音)。
- 底层的“做加法”原理:
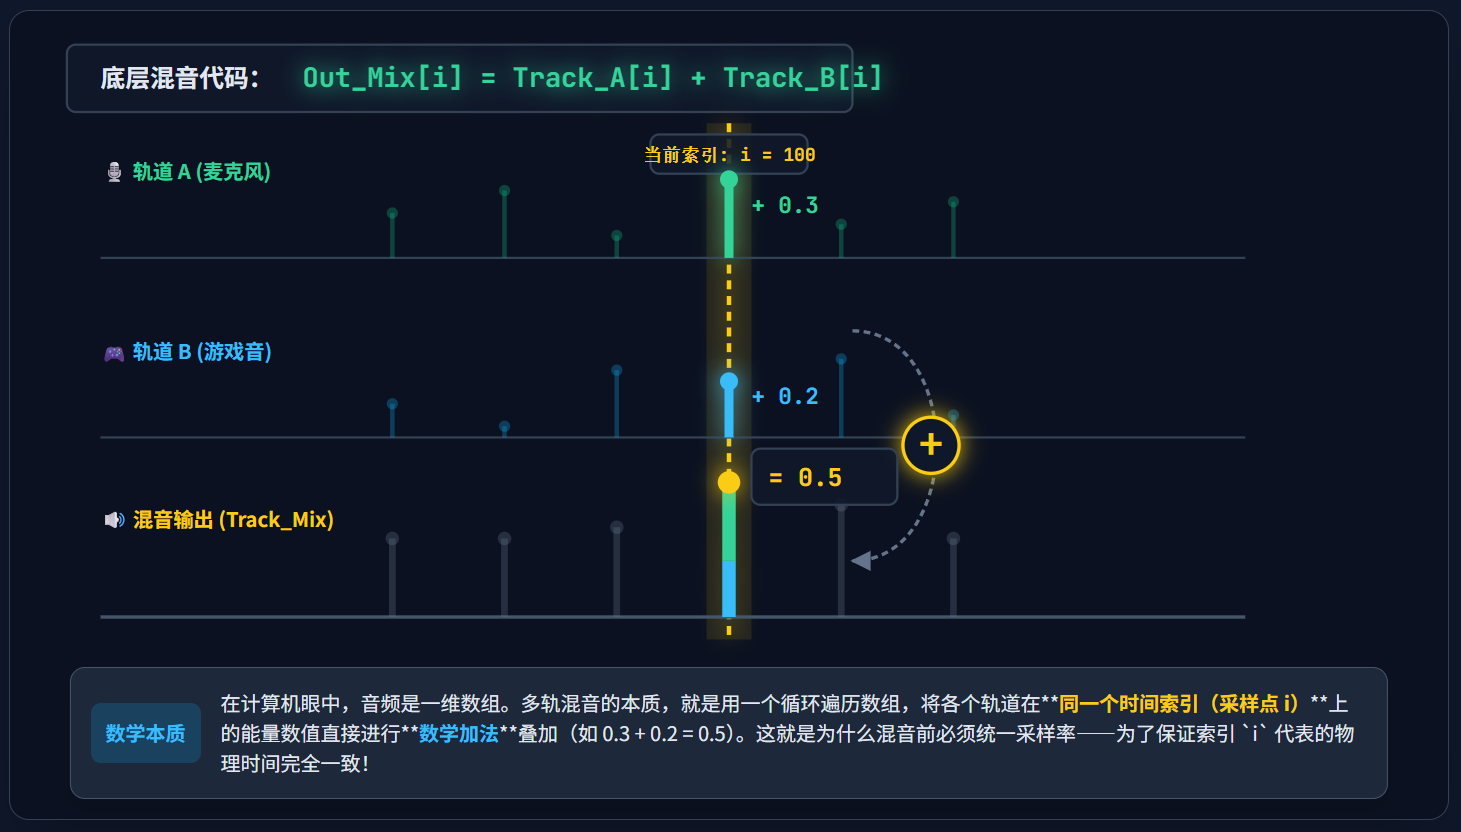
混音的底层逻辑:就是各个轨道音频相加。
- 混音的致命痛点:爆音(Clipping)
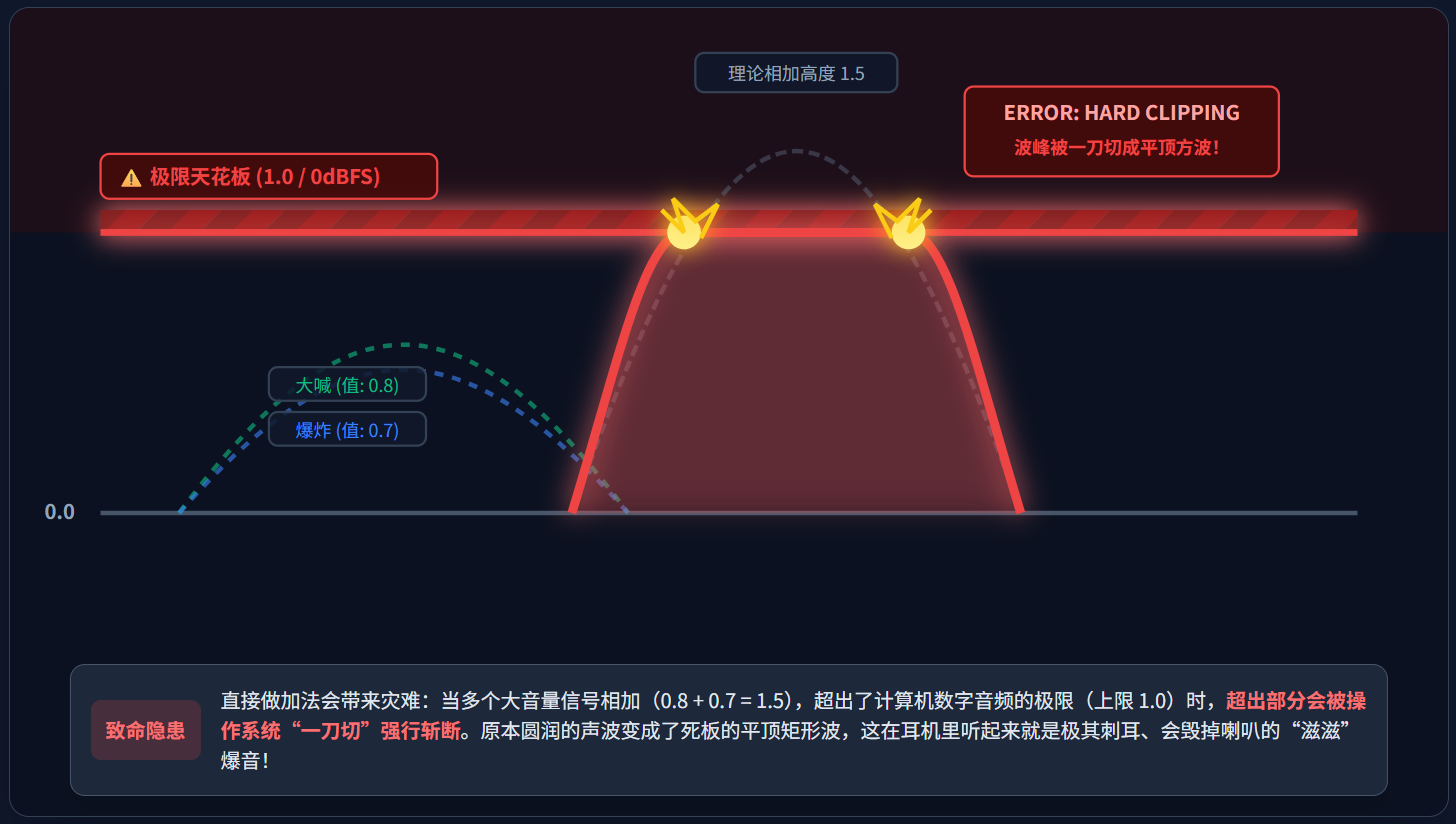
既然是做加法,就会遇到一个大麻烦。计算机记录声音数字的“尺子”是有最大刻度的(通常最大不能超过1.0)。
如果主播大喊一声(数字变成0.8),游戏里刚好发生大爆炸(数字变成0.7),加起来是1.5。1.5超出了尺子的最大刻度1.0。计算机会粗暴地把超过1.0的部分像切菜一样“一刀切”削平。这在耳机里听起来,就是极其刺耳的爆音。
爆音的解决方案:
在AudioDSP类里,用tanh的数学函数。可以把他想象成一块“智能海绵”:
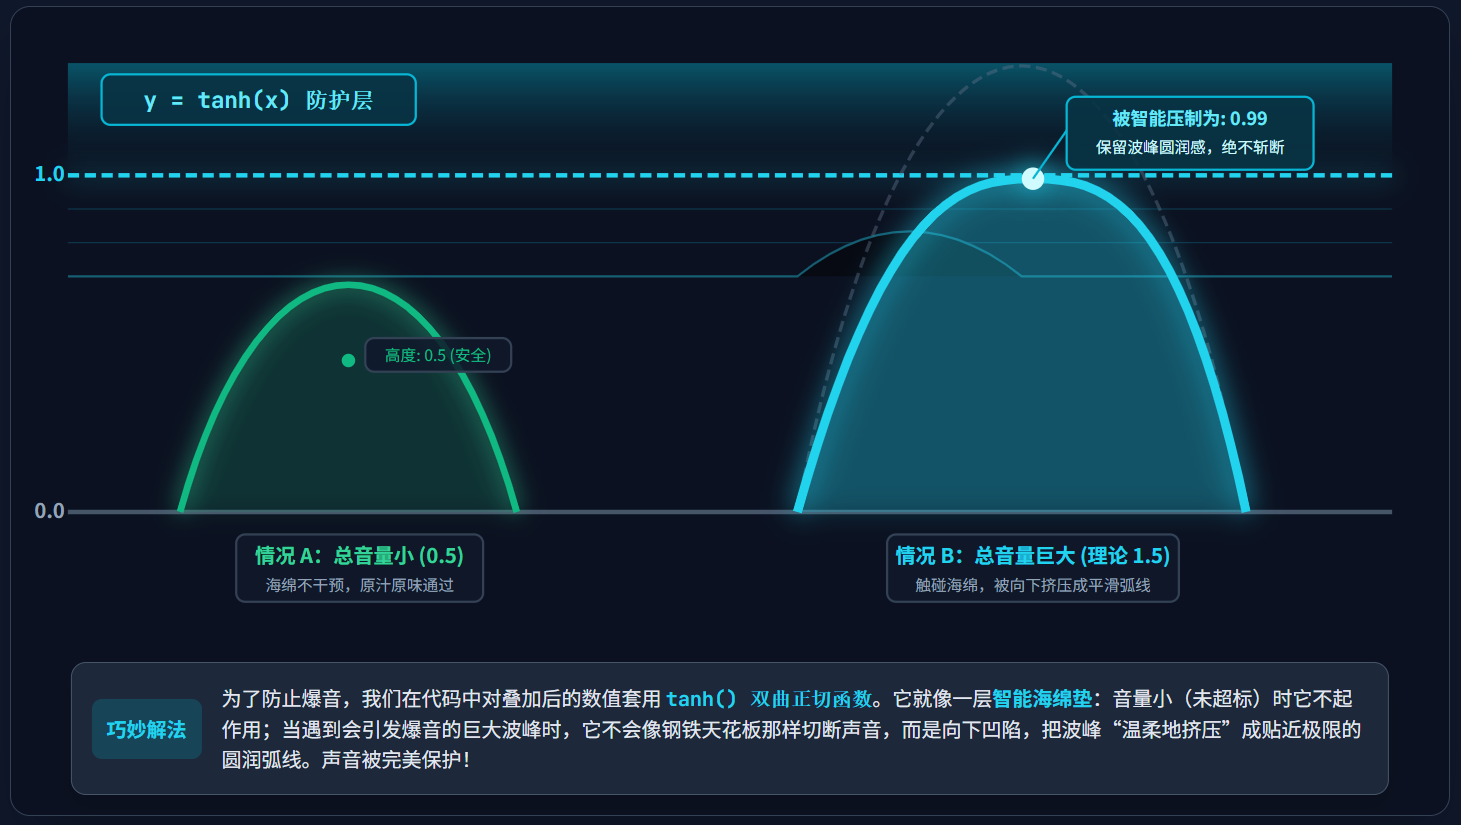
当混音加起来的数字比较小(比如0.5)时,海绵不怎么管它,原汁原味保留。但当数字大到快要超过1.0(比如1.5、2.0)时,这块海绵会把声音“温柔地挤压”一下,让他无限接近1.0,但永远不会超过1.0。
6.1 重采样与混音代码实现
- 初始化
当麦克风或系统声音第一次把数据塞进来时,系统会检查:这里是否有翻译官和水池,于是马上修建。
// 1. 如果没有翻译官 (swr),或者输入的频率变了,就重新入职和建水池
if (!ctx.swr || ctx.lastInputRate != inRate || ctx.lastInputChannels != inChannels) {
    if (ctx.swr) swr_free(&ctx.swr); // 辞退老翻译官

    // 2. 设置输入输出频道标准
    AVChannelLayout outLayout; av_channel_layout_default(&outLayout, m_outChannels);
    AVChannelLayout inLayout; av_channel_layout_default(&inLayout, inChannels);

    // 3. 拟定翻译合同 (swr_alloc_set_opts2),告诉他输入是什么样,我们要的输出是什么样
    swr_alloc_set_opts2(&ctx.swr, &outLayout, AV_SAMPLE_FMT_FLT, m_outRate, &inLayout, AV_SAMPLE_FMT_FLT, inRate, 0, nullptr);

    // 4. 翻译官正式上岗 (swr_init)
    if (swr_init(ctx.swr) < 0) return;

    // 5. 修建蓄水池 AVAudioFifo,用来装翻译后的标准水滴,容量给个 4096
    if (ctx.fifo) av_audio_fifo_free(ctx.fifo);
    ctx.fifo = av_audio_fifo_alloc(AV_SAMPLE_FMT_FLT, m_outChannels, 4096);

    // 6. 准备一个临时脸盆 (resampleBuffer),翻译官刚翻译完的水先放脸盆,再倒进水池
    av_samples_alloc_array_and_samples(&ctx.resampleBuffer, nullptr, m_outChannels, 4096, AV_SAMPLE_FMT_FLT, 0);
}
- 重采样与缓冲
数据源源不断地来,他就不断转换,并倒进各自的蓄水池(FIFO)中。
// 1. 计算这次来了多少原始数据
int inSamples = data.size() / (inChannels * sizeof(float));
const uint8_t* inputData[] = { (const uint8_t*)data.constData() };

// 2. 估算翻译后会有多少数据 (因为频率变了,数量也会变)
int outSamplesMax = av_rescale_rnd(swr_get_delay(ctx.swr, inRate) + inSamples, m_outRate, inRate, AV_ROUND_UP);

// 3. 开始干活!swr_convert 把 inputData 翻译成金色水滴,放进脸盆 ctx.resampleBuffer
int convertedSamples = swr_convert(ctx.swr, ctx.resampleBuffer, outSamplesMax, inputData, inSamples);

// 4. 把脸盆里的水,稳稳地倒进蓄水池 AVAudioFifo 里存起来
if (convertedSamples > 0) av_audio_fifo_write(ctx.fifo, (void**)ctx.resampleBuffer, convertedSamples);
- 提取与混音
编码器急需数据打包,使用者拿着固定大小的“瓢”,去各个水池里舀水。并在通过一个大缸内做加法混合。
// 1. 编码器拿着名为 outL 和 outR 的空盆来了,先洗干净 (置0)
memset(outL, 0, nbSamples * sizeof(float));
memset(outR, 0, nbSamples * sizeof(float));

// 2. 遍历所有的水池(麦克风池、系统池)
for(auto key : sources.keys()) {
    auto& s = sources[key];
    // 3. 检查水池里的水够不够一瓢 (av_audio_fifo_size)
    if (av_audio_fifo_size(s.fifo) >= nbSamples) {

        // 4. 从水池舀出一瓢水,放进 tmpBuf
        void* bufPtr = tmpBuf;
        av_audio_fifo_read(s.fifo, &bufPtr, nbSamples);

        // 5. 核心:小学加法混音!把舀出来的水,乘以音量,加到主盆 outL/outR 里
        for(int i=0; i<nbSamples; ++i) {
            outL[i] += tmpBuf[i*2] * s.volume;   // 左声道相加
            outR[i] += tmpBuf[i*2+1] * s.volume; // 右声道相加
        }
    }
}

// 6. 智能海绵上场:使用 tanh 挤压主盆里的水,防止加起来的数字超过 1.0 (爆音)
for(int i=0; i<nbSamples; ++i) {
    outL[i] = std::tanh(outL[i]);
    outR[i] = std::tanh(outR[i]);
}
return nbSamples; // 返回满满一瓢完美混合的水!
- 封装打包给编码器
混合好的完美音频,最终需要装进FFmpeg认识的箱子(AVFrame)里,送去压缩编码。
// 1. 看看编码器的“瓢”有多大 (frameSize)
int frameSize = m_aEncoder->getContext()->frame_size;

while (true) {
    // 2. 调用上面的步骤,去拿一瓢混合好的水
    int samplesRead = m_audioDSP->popMixedData(m_mixL, m_mixR, frameSize);
    if (samplesRead < frameSize) break; // 如果水不够了,就跳出循环,等下次再来

    // 3. 准备好箱子 (m_aFrame)
    if (av_frame_make_writable(m_aFrame) < 0) return;

    // 4. 把混好的水,小心翼翼地倒进箱子的左半区和右半区
    float* dstL = (float*)m_aFrame->data[0];
    float* dstR = (float*)m_aFrame->data[1];
    memcpy(dstL, m_mixL, frameSize * sizeof(float));
    memcpy(dstR, m_mixR, frameSize * sizeof(float));

    // 5. 贴上时间戳标签 (pts),表示这是什么时候的包裹
    m_aFrame->pts = m_totalAudioSamples + ptsOffset;
    m_totalAudioSamples += frameSize;

    // 6. 送上流水线去编码!
    AVPacket* pkt = m_aEncoder->encode(m_aFrame);
}
全部流程:重采样翻译 -> FIFO蓄水缓冲 -> 按帧提取 -> 数学加法混音 ->Tanh防爆处理 -> AVFrame打包。
7 视频编码
1.原始视频的”恐怖“体积
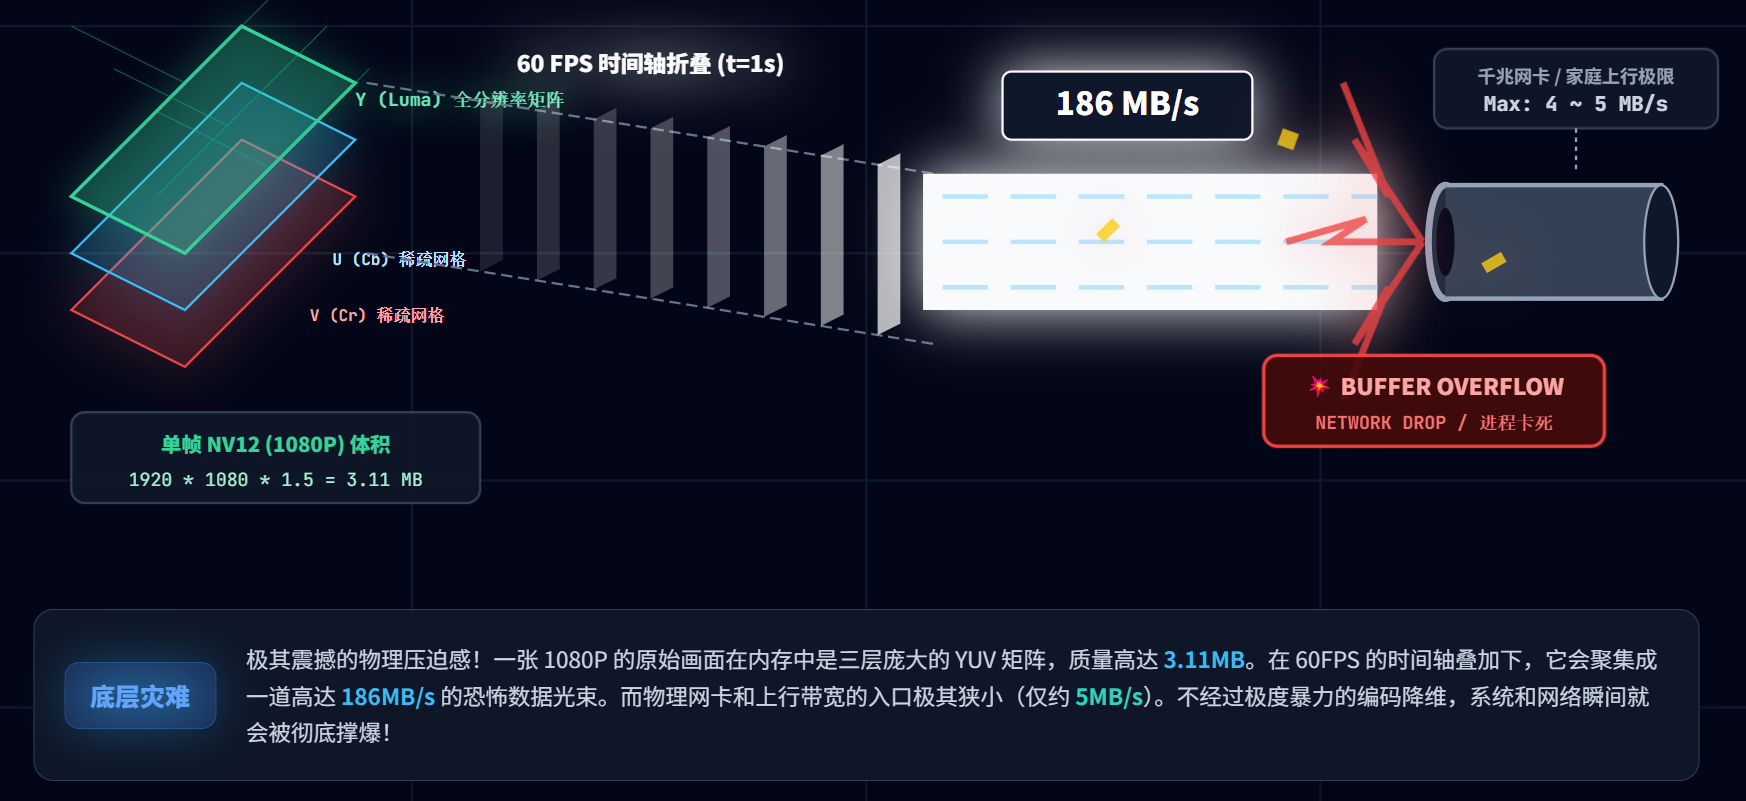
视频就是快速翻动的连环画(帧)。一张1080P的彩色图片(格式是NV12),大约需要1920x1080x1.5≈3.11MB空间。如果帧率是60FPS,那么1秒钟的原始视频提及高达186MB。如果不经过压缩,在快的带宽也扛不住这样的数据洪流。
2.视频编码的底层原理:榨干”冗余“
编码(压缩)之所以可能是因为视频中充满了大量的”废话“(冗余数据):
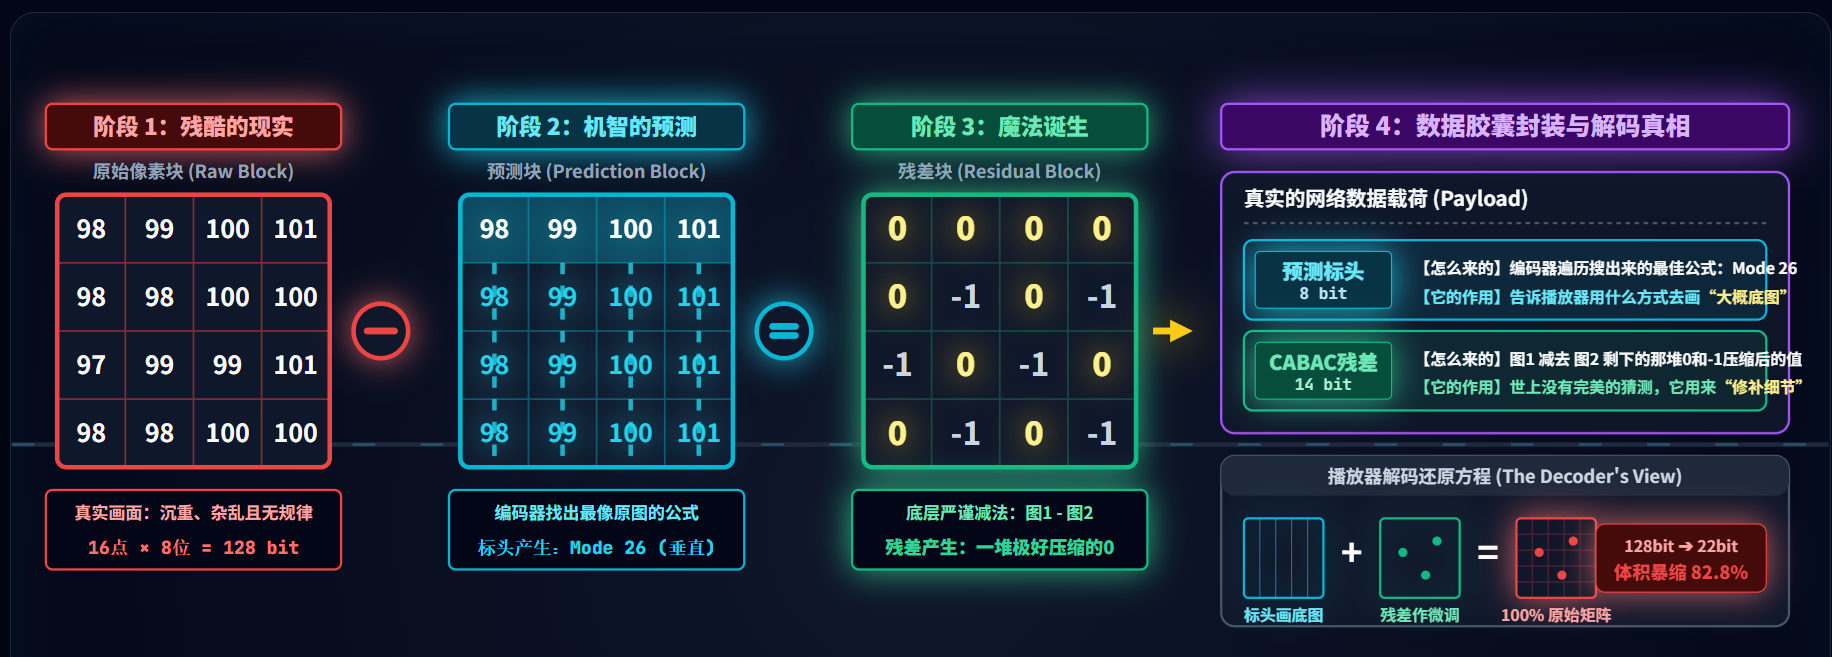
- 空间冗余(帧内压缩):
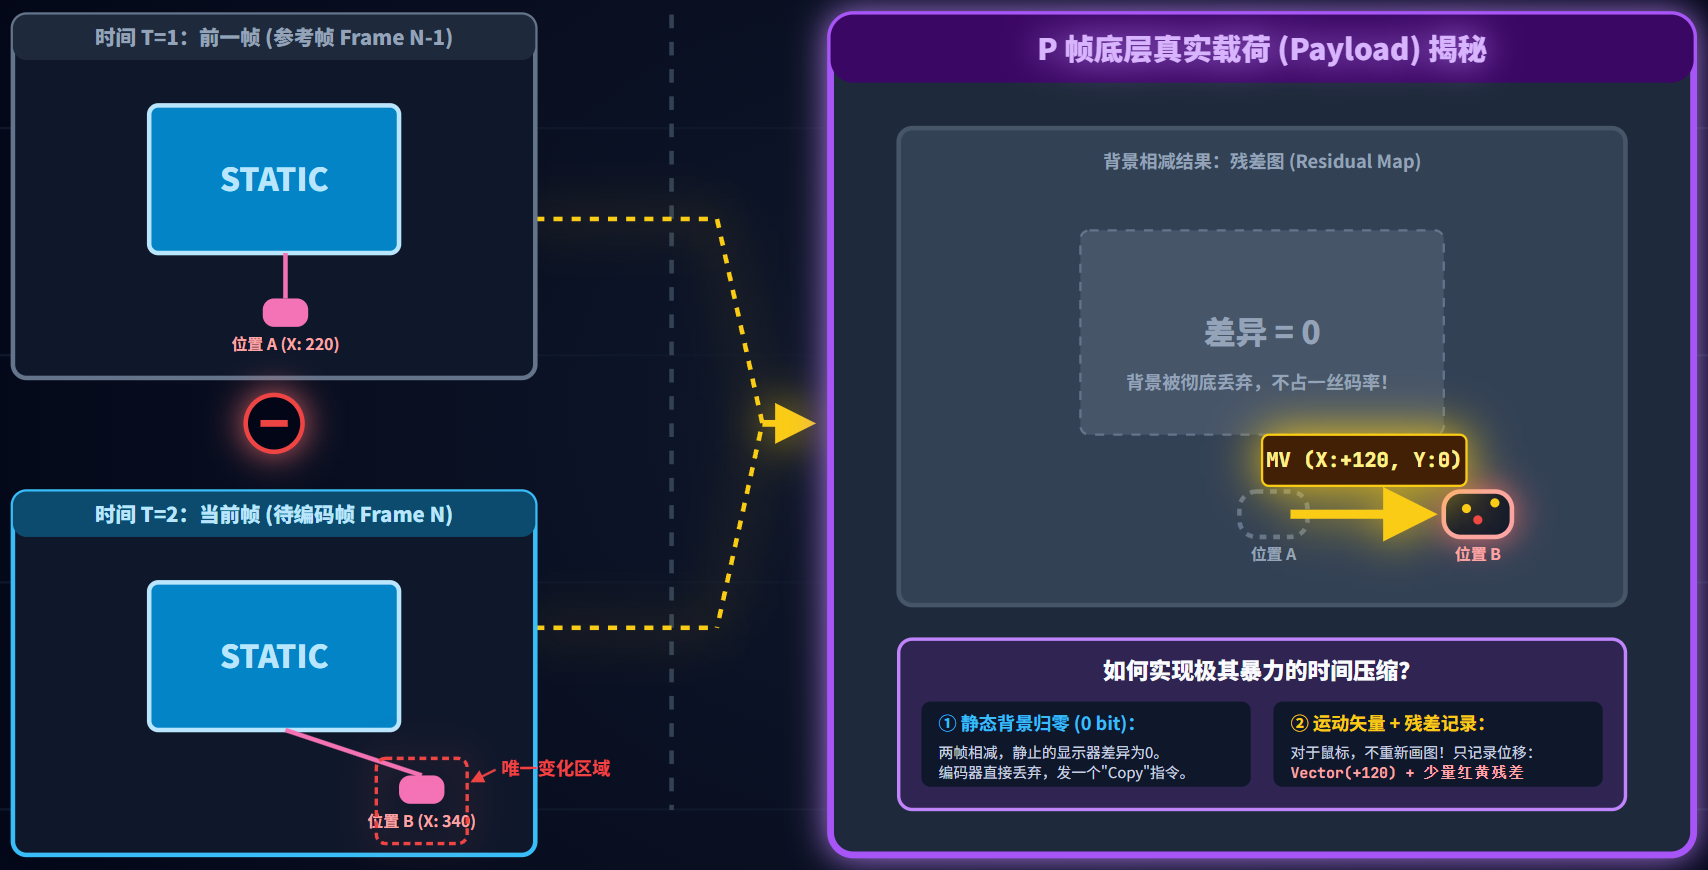
- 时间冗余(帧间压缩):
7.1 I帧、P帧、B帧与GOP
为了实现”时间冗余“的压缩,视频编码有三种帧来实现。
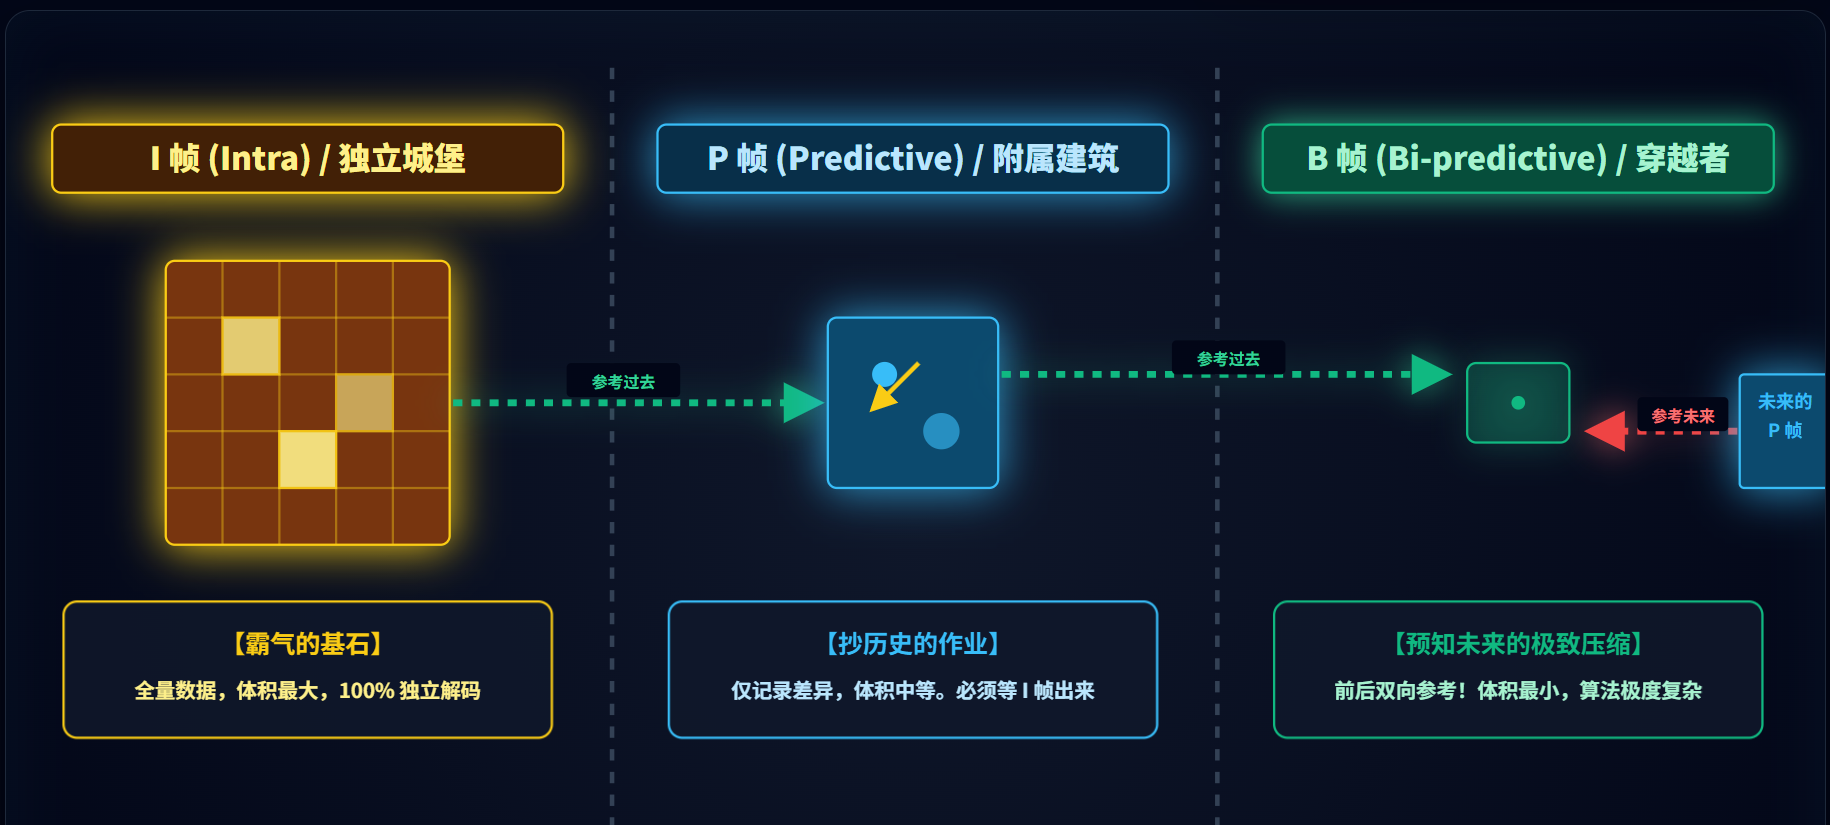
- I帧(关键帧,Intra-coded):这是一张完整的图片,不依赖任何其他真就能解码。他是预测的基础,但体积最大。
- P帧(向前预测帧,Predictive):他只记录当前画面与前面的I帧或P帧不同之处。体积较小。
- B帧(双向预测帧,Bi-predictive):他是机制压缩的产物,不仅参考前面的画面,还有参考后面的画面来计算差异。体积最小。
- GOP(Group of Picture):
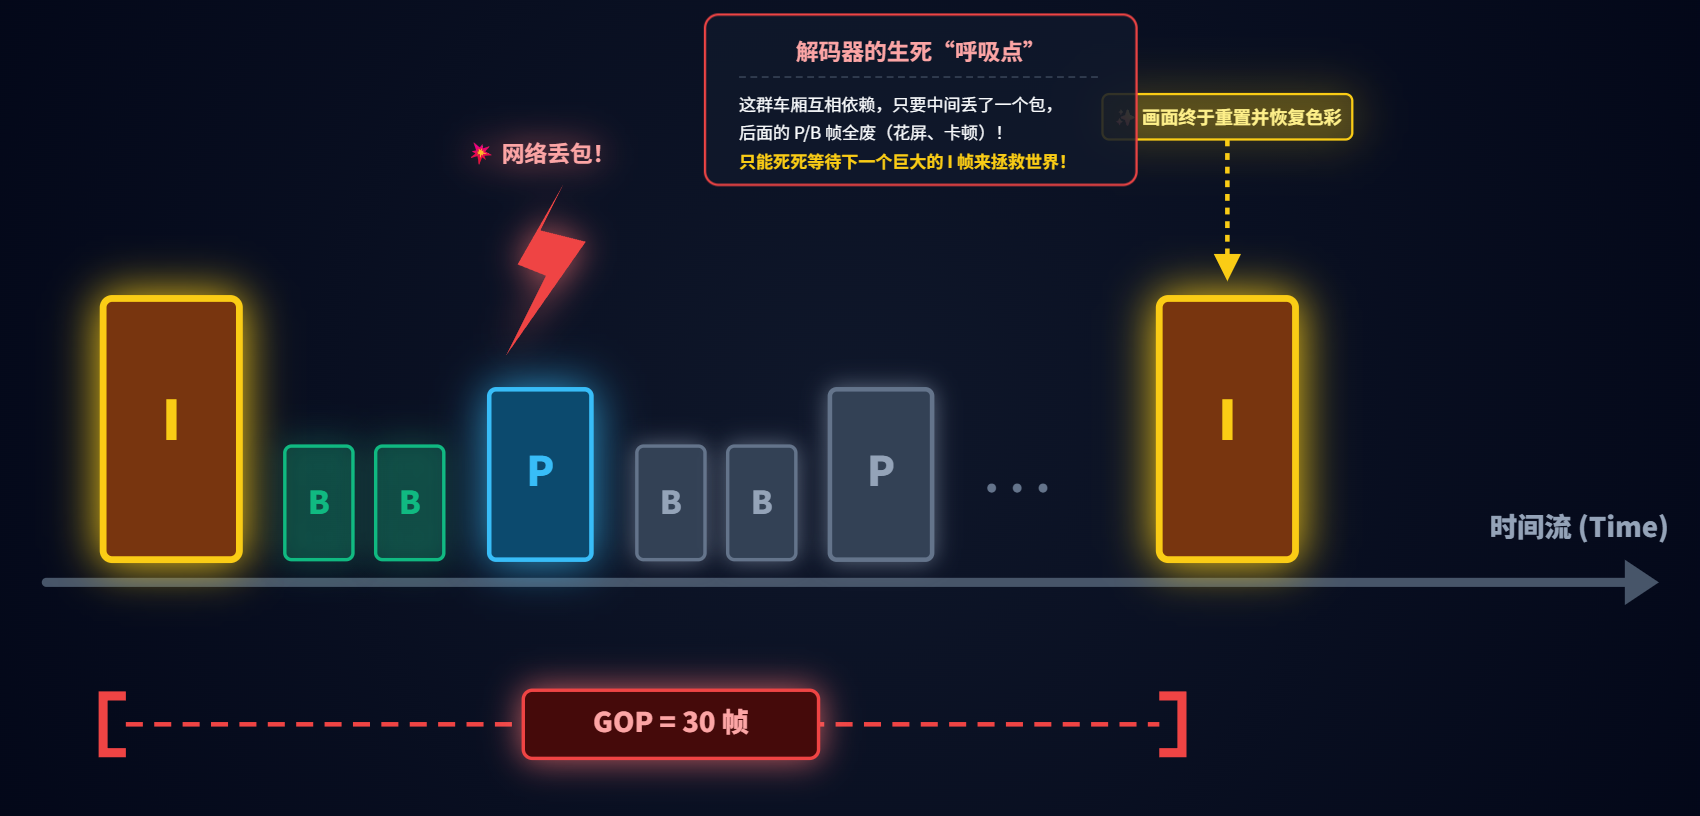 两个I帧之间的距离。比如GOP = 30,意味着每30帧才有一个完整的全景图,中间全是P帧和B帧。
- 低延迟的生死大敌:B帧
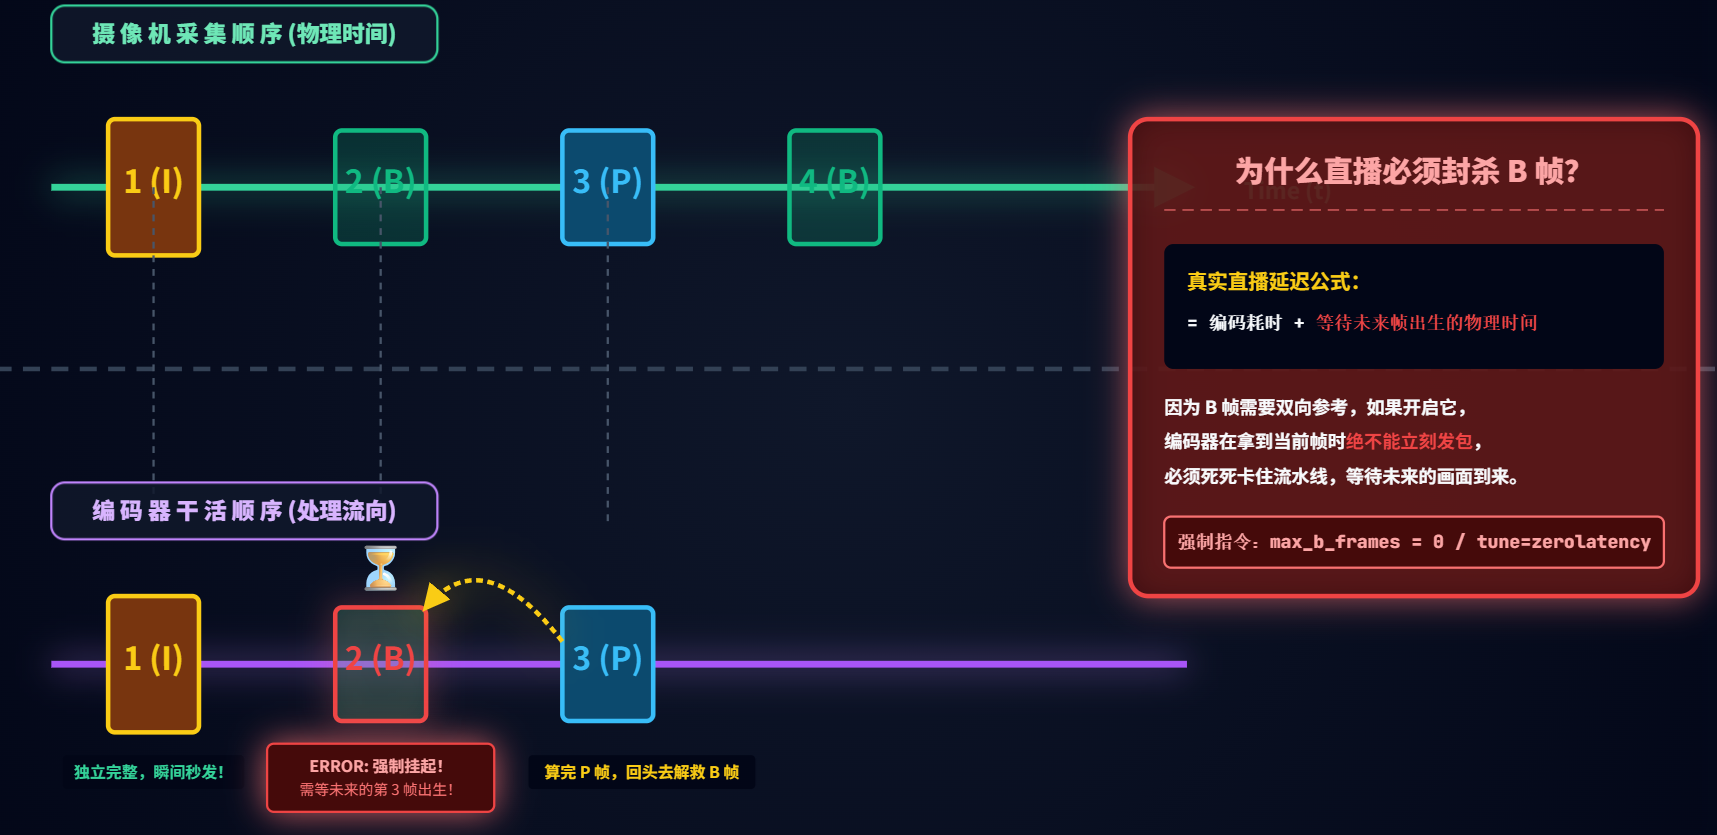
B帧需要参考未来的画面才能生成。这意味,采集到第2帧(如果是B帧)时,编码器不能立即编码发送,他必须把第2帧缓存在手里,死死等待第3帧(甚至第4帧)到来后,才能完成计算。这就是视频直播延迟的万恶之源。
7.2 如何做到极致低延迟
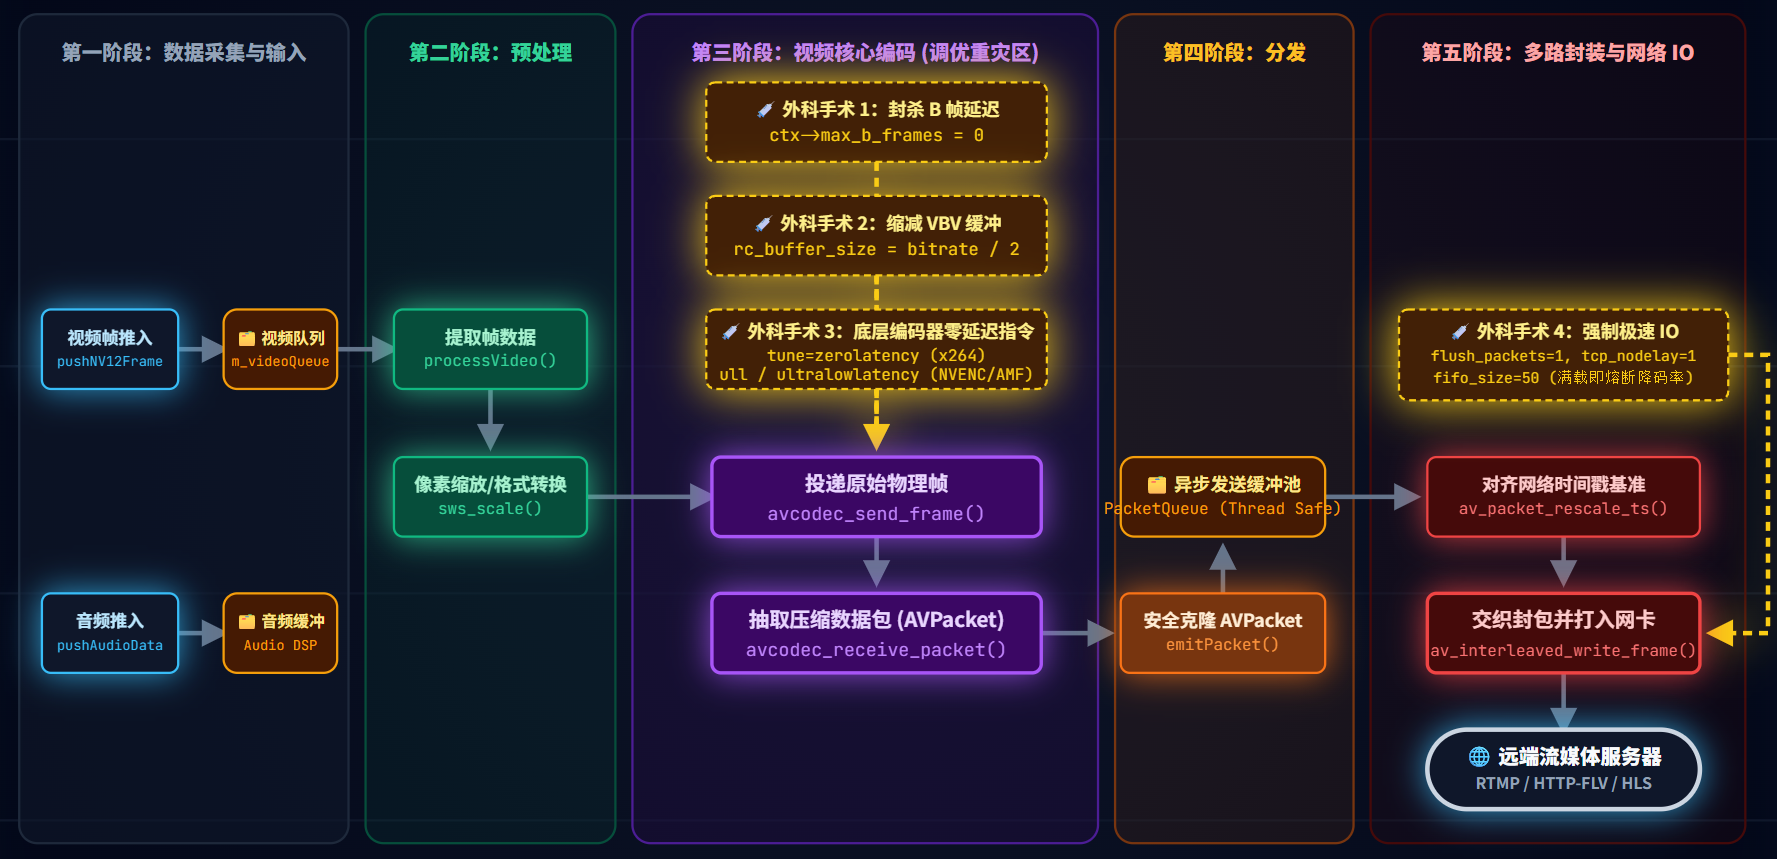
在我们的推流项目中,为了把延迟压榨到毫秒级,我们在VideoEncoder::tryInitEncoder和网络传输层做了一系列极其冷酷的手术。
7.2.1 封杀B帧
原理:宁可牺牲一点点压缩率,也绝不等待未来帧。
**文件**: `FFmpegModules.h`
**类与函数**: `VideoEncoder::tryInitEncoder`
// [企业级优化 1] 强制关闭 B 帧,这是 RTMP 低延迟的核心
// 任何 B 帧都会导致播放器必须等待后续 P 帧到达才能解码,直接引入延迟
ctx->max_b_frames = 0; // 宁可牺牲一点压缩率,也要求编码器做到“出一帧发一帧”
7.2.2 缩减码率控制缓冲
原理:编码器内部有个蓄水池,用来平滑码率峰值。如果设置太大,网络卡顿时数据会挤压在编码器里发不出去,导致巨大延迟。
**文件**: `FFmpegModules.h`
**类与函数**: `VideoEncoder::tryInitEncoder`
// [企业级优化 3] 缩减码率控制缓冲区 (VBV Buffer)
// 默认 buffer 往往是 1-2秒,导致网络波动时数据在编码器内部积压。
// 设为 0.5 秒或更小,迫使编码器在带宽受限时快速降低画质而不是堆积数据。
ctx->rc_buffer_size = bitrate / 2; // 强行把编码器的“大肚皮”勒紧,积压上限减半
7.2.3 零延迟硬件级调优
不同的编码器有不同的内部秘籍:
x264(软编):设置av_opt_set(),这回彻底关闭Lookahead(向前缓冲)。

NVENC(NVIDIA显卡):设置tune为ull,并强制delay为0,这是英伟达转为游戏直播设计的超低延迟模式。

AMF(AMD显卡):设置usage为ultralowlatency。

QSV(Intel显卡):强制async_depth为1,斩断异步深度的缓冲。
**文件**: `FFmpegModules.h`
**类与函数**: `VideoEncoder::tryInitEncoder`
// ----------------------------------------------------------------------
// [企业级优化 4] 针对不同编码器的低延迟参数深度调优
// ----------------------------------------------------------------------

// >>> 1. x264 软编优化
if (name == "libx264") {
    // "zerolatency" 是核心,它会禁用 B 帧,去除 Lookahead,通过牺牲压缩率换取最低延迟
    av_opt_set(ctx->priv_data, "tune", "zerolatency", 0);
...
// >>> 2. NVENC 硬编优化 (NVIDIA)
else if (name.contains("nvenc")) {
...
    // 调优: ull (Ultra Low Latency) 是 NVENC 专门为直播设计的低延迟模式
    av_opt_set(ctx->priv_data, "tune", "ull", 0);

    // 强制 0 延迟缓冲,彻底干掉并行帧处理的延迟
    av_opt_set(ctx->priv_data, "delay", "0", 0);
...
// >>> 3. AMF 硬编优化 (AMD)
else if (name.contains("amf")) {
    // 开启 AMD 的超低延迟模式
    av_opt_set(ctx->priv_data, "usage", "ultralowlatency", 0);
}
// >>> 4. QSV 硬编优化 (Intel)
else if (name.contains("qsv")) {
    // 异步深度设为1,斩断 Intel 硬件编码器的异步缓冲队列
    av_opt_set(ctx->priv_data, "async_depth", "1", 0);
}
7.2.4 IO与缓冲优化
原理:编码好的数据包绝对不能在发送端停留。
在StreamMuxer::applyNetWorkOptions中开启flush_packets=1强制立即发包。开启tcp_nodelay=1禁用系统的Nagle算法(不拼凑小包)。将FFmpeg内部的积压队列fifo_size从默认1万砍到50,一旦网络拥堵立即让上层感知。
**文件**: `FFmpegModules.h`
**类与函数**: `StreamMuxer::applyNetworkOptions`
void applyNetworkOptions(AVDictionary** opts) {
    // ...
    // [优化] 开启 TCP_NODELAY,禁用 Nagle 算法,对低延迟至关重要
    // 让系统有包就发,绝对不为了节省头部开销去“拼凑大包”
    av_dict_set(opts, "tcp_nodelay", "1", 0);
    // ...
    // [关键优化] 减小 FFmpeg 内部的包缓冲。
    // 原来的 10000 包太大了,会导致网络抖动时 FFmpeg 内部积压数秒数据而不报错
    // 改为 100-200,一旦网络堵塞立即让上层(AdaptiveStreamController)感知并降码率
    av_dict_set(opts, "fifo_size", "50", 0);

    // [关键优化] 强制立即发送,不进行微缓冲
    // 数据一旦 mux 完成,绝不在 FFmpeg 的 IO 层做任何停留
    av_dict_set(opts, "flush_packets", "1", 0);
    // ...
}
8 音画同步
1.核心概念:简单来说,音画同步就是保证主播嘴唇动的那一刻,你刚好听到他的声音。
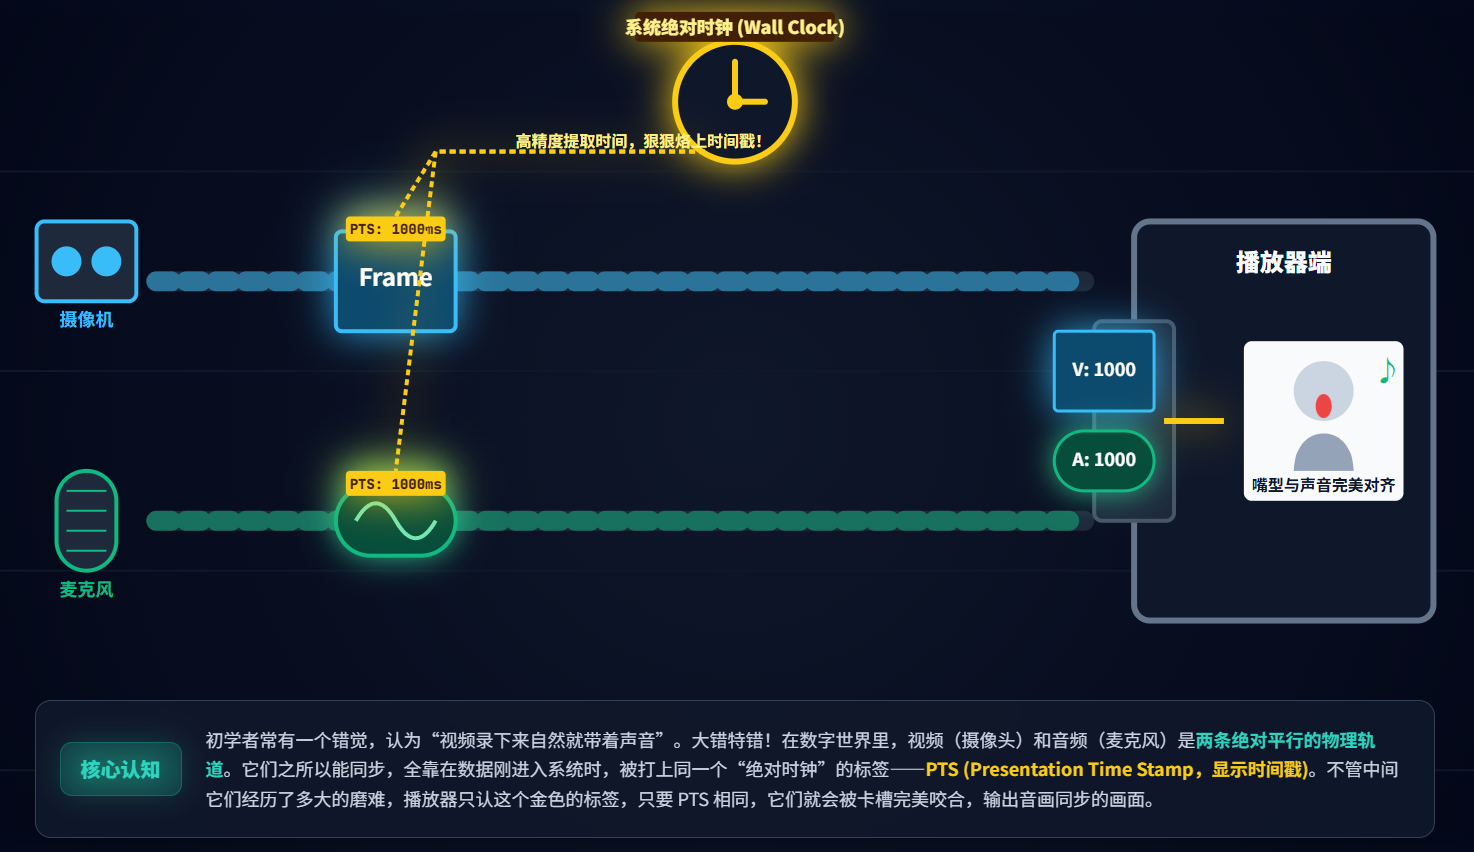
在数字世界里,音频和视频是两条完全独立的流水线。它们被打碎成一个个的数据包(Packet),在网络中传输,最后再由播放器拼装。
为了让它们对齐,我们给每一个画面和每一段声音贴上了一个“时间标签”,这就是PTS(Presentation Time Stamp,显示时间戳)。
2.为什么音视频会跑偏?
- 采集源的“心脏”不同:
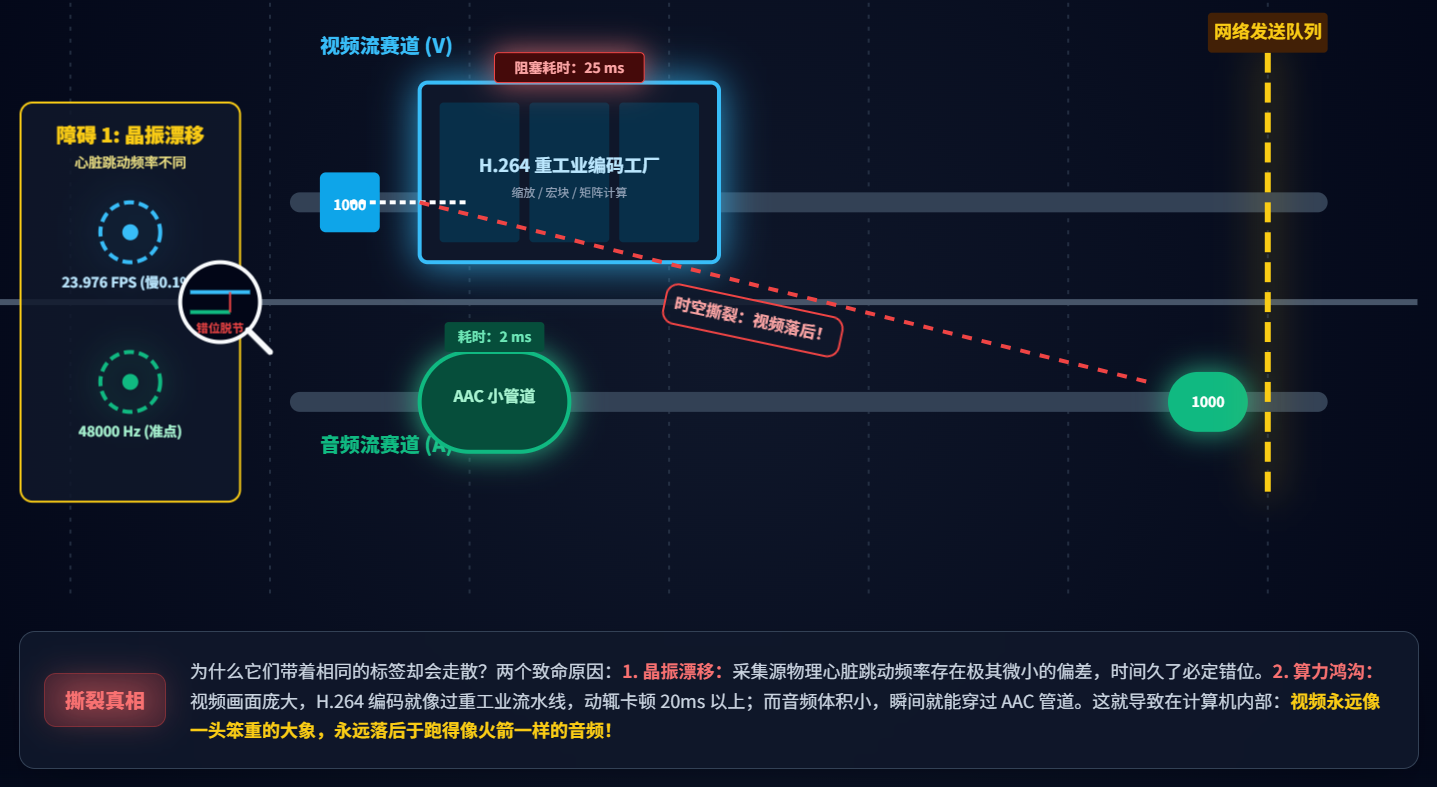
麦克风的硬件时钟晶振和摄像头的硬件时钟晶振存在微小的物理误差。时间久了,一个会比另一个多跑几毫秒。
- 处理耗时不同:
视频编码:(尤其是涉及到GPU、缩放、H.264压缩)的耗时远远大于音频编码。视频容易“迟到”。
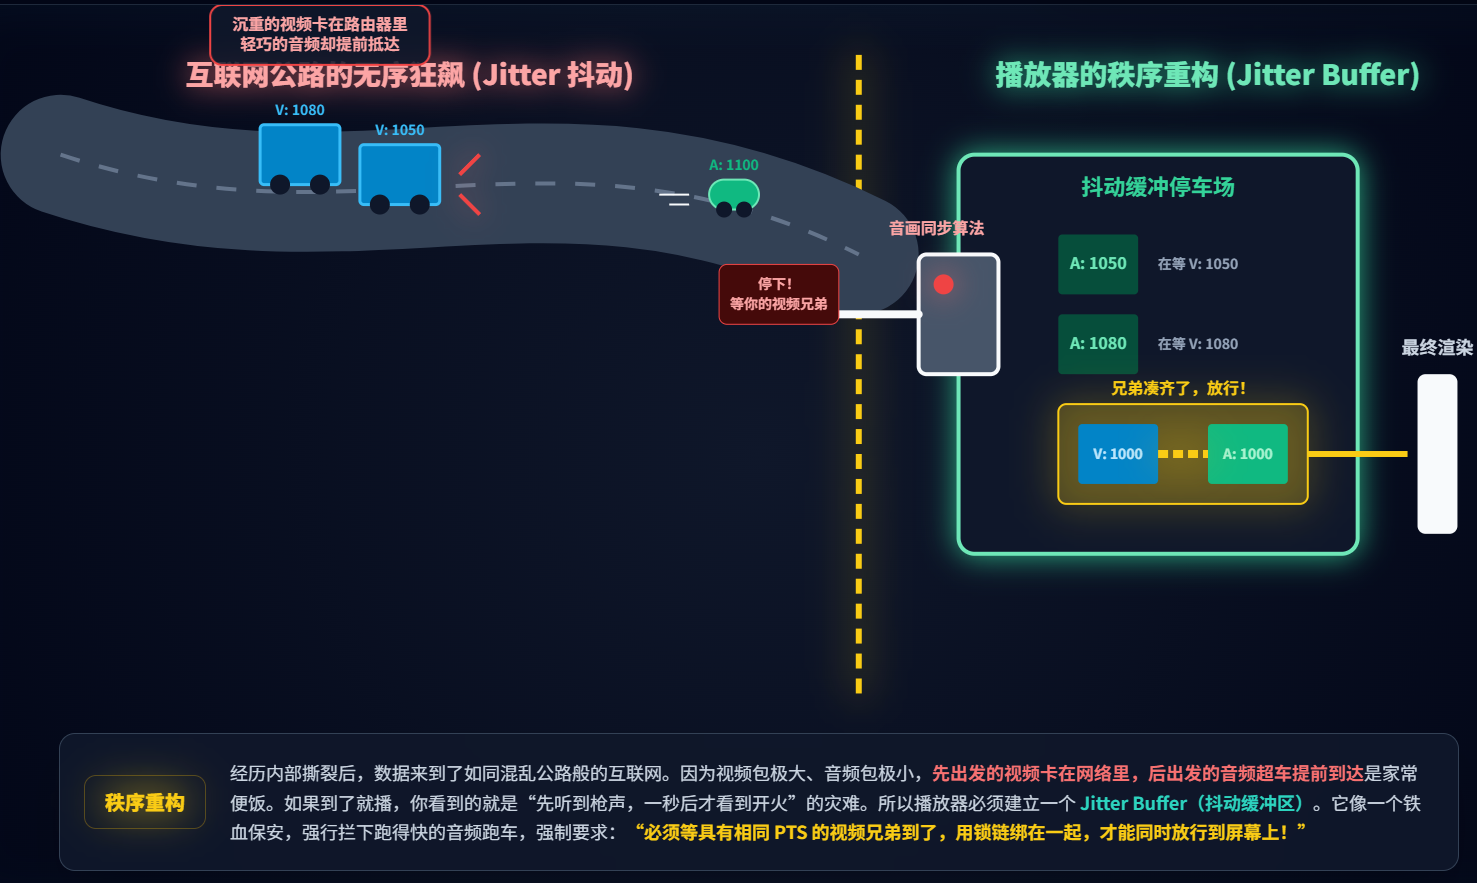
网络抖动:在发送端,音视频包就像公路上的车,有的堵车,有的畅通无阻。
8.1 音画同步算法
为了把这两只脚绑在一起,业界总结了三种主流算法。
1.同步到音频(Video to Audio)——最主流做法
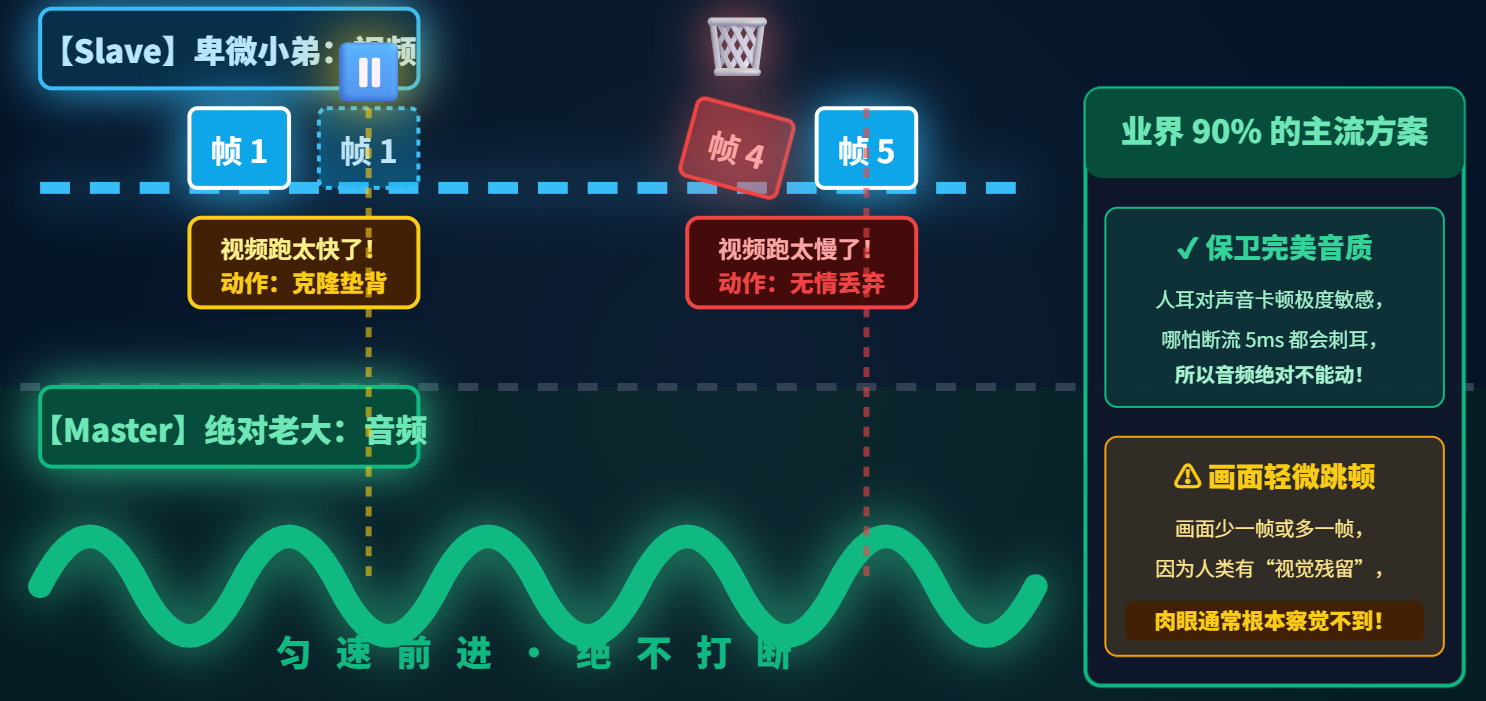
- 底层原理:以音频的播放时间为绝对标准(基准参考)。如果视频跑快了,就让视频“停下来等一等”(重复显示上一帧);如果视频跑慢了,就让视频“快进”(直接丢弃当前帧)。
- 优势:人类的耳朵对声音的卡顿、变调极其敏感(稍微断一下就会觉得刺耳),但人类的眼睛是个“笨蛋”,视频一秒钟少一两帧(丢帧)根本察觉不出来。
- 劣势:视频画面在极其恶劣的网络下可能会出现轻微的跳跃感。
2.同步到视频(Audio to Video)
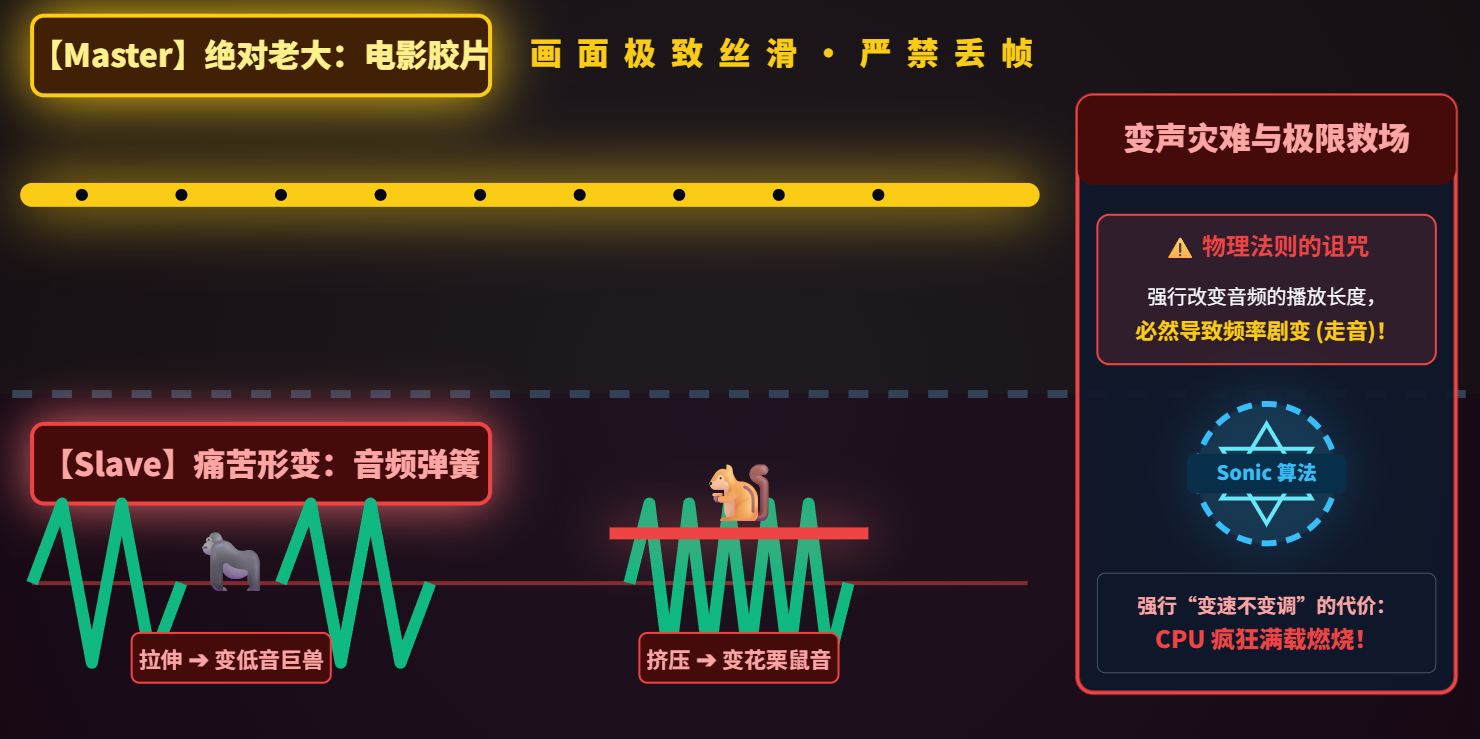
- 底层原理:以视频时间为准。如果音频慢了,就把音频数据“拉伸”(重采样填补空缺);如果音频快了,就把音频“压缩”(丢弃音频采样点)。
- 优势:画面极其平滑流畅。
- 劣势:改变音频长度通常会导致“变调”(声音变尖锐或低沉),需要极其复杂的算法(如Sonic或SoundTouch)来保证变速不变调,极其消耗CPU。
3.同步到外部时钟(Sync to System Time)
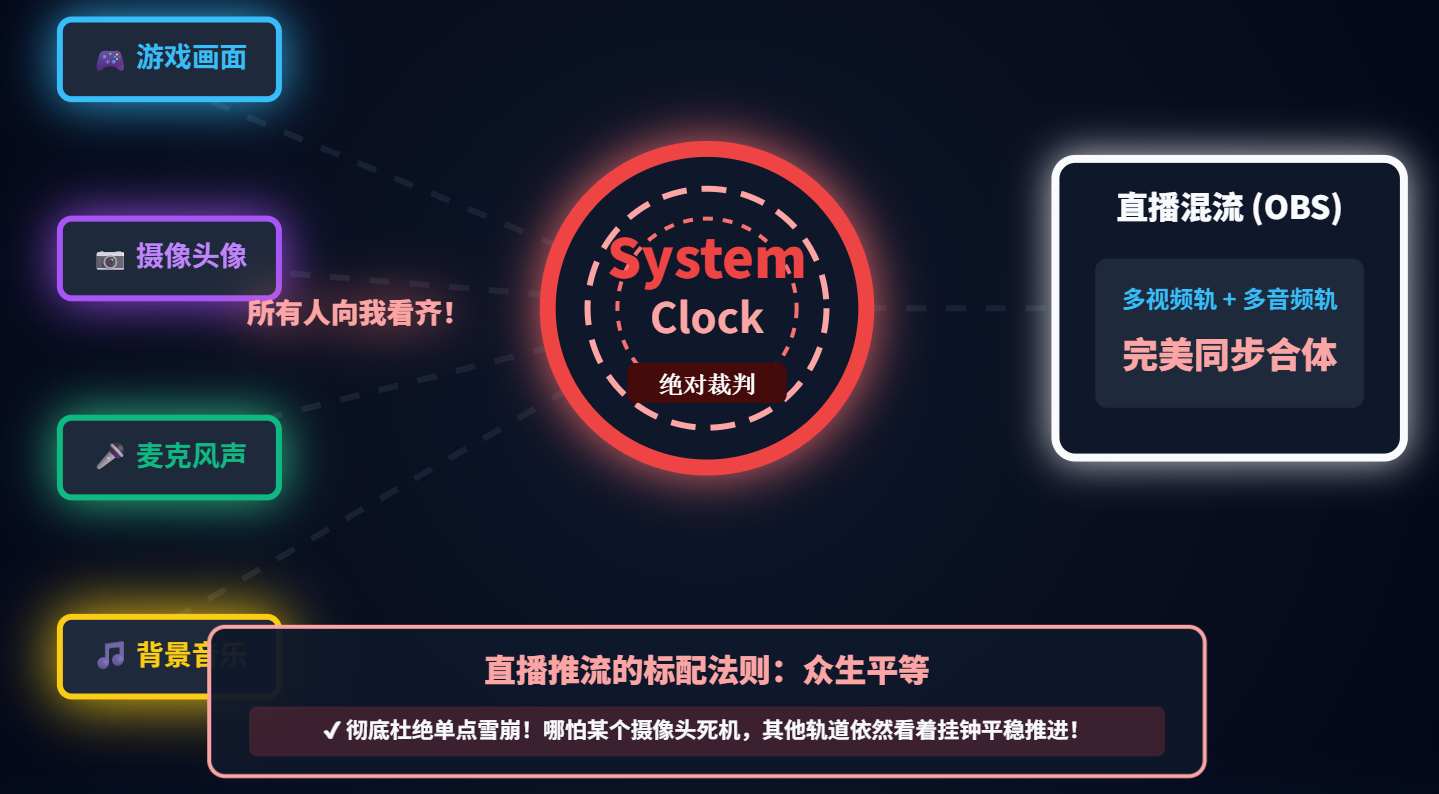
- 底层原理:不偏袒任何一方,那一块客观的“系统秒表”。音频和视频都看这块秒表决定自己的去留。
- 劣势:非常适合直播推流和多路混流的场景。
本项目使用**“基于时间戳统计的视频同步到音频”**策略。因为音频的采样点数量极其稳定,我们用视频来丈量时间。
8.2 音画同步代码
FFmpegRecorder.cpp中把“视频采集慢”与“编码器慢”这两种极其容易混淆的情况,通过**“底层补帧”和”高层截流“**的维度彻底剥离开来。
8.2.1 建立绝对时间轴与丈量差距(Diff)
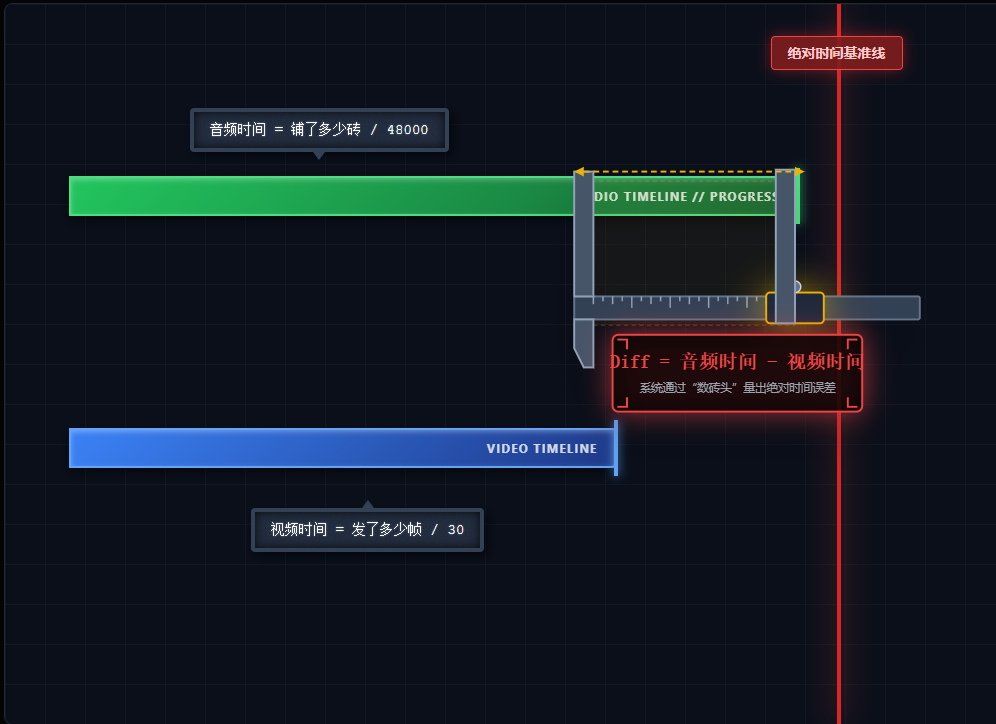
音频一直在均匀采集,视频一直在持续出帧。我们只需要拿“总采样数”和“总帧数”处理它们的速率,就能算出理论上极其精确的物理时间。然后用游标卡尺一量:Diff = 音频时间-视频时间。
**【对应源码 `FFmpegRecorder.cpp -> processVideo`】**
// 算出精准的物理时间
double audioSec = (double)m_totalAudioSamples / m_config.audio.sampleRate;
double videoSec = (double)m_videoPtsCounter / m_config.base.fps;
double frameDur = 1.0 / m_config.base.fps; // 1帧的标准时长 (如 0.033s)

// 计算差距 (Diff)
double diff = audioSec - videoSec;
8.2.2 视频跑太快
如果视频跑太快,绝对不能调用Sleep()睡眠等待,否则整条推流线程都会卡死,声音直接断流。一旦发现视频帧超过前一帧(diff + framDur < 0)直接将这张刚渲染好的画面当场销毁,绝不阻塞流水线。
**【对应源码 `FFmpegRecorder.cpp -> processVideo`】**
if (diff < -frameDur) {
    dropFrame = true;     // 宣判死刑
    m_droppedFrames++;    // 记录罪证
}

// ...
if (dropFrame) {
    av_frame_free(&srcFrame); // 物理销毁内存,直接扫进垃圾桶
    return; // 立刻返回,绝不阻塞线程!
}
8.2.3 视频跑太慢
当Diff > 0.033s时,视频落后了。此时有两个情况:
1.摄像头没采集到(采集慢)
2.显卡算不过来(编码慢)
8.2.3.1 场景一:摄像头卡了
此时显卡很闲,但时间轴上缺了画面。代码会启动“克隆印章”,把当前好不容易拿到的一张画面,连续加盖时间戳,向编码器连塞好几次(最高限制补5帧防止死循环)。用静止的画面填满时间轴黑洞,保住不黑屏。
**【对应源码 `FFmpegRecorder.cpp -> processVideo`】**
if (diff > frameDur) {
    // 算出缺了几个坑位
    duplicateCount = (int)(diff / frameDur);
    if (duplicateCount > 5) duplicateCount = 5; // 限制最多补5帧
    m_duplicatedFrames += duplicateCount;
}

// 处理补帧 (疯狂印章)
for (int i = 0; i < duplicateCount; ++i) {
    frameToEncode->pts = m_videoPtsCounter;
    encodeAndWriteVideo(frameToEncode); // 连续多次塞给编码器
    m_videoPtsCounter++; // 时间轴向前推进
}
8.2.3.2 场景二:GPU编译器慢了
如果编码器已经卡冒烟,继续使用刚刚的策略,系统会崩溃。
所以跳出processVideo,看我们在run()线程循环里写的最高级防线:**外部自适应流控!**当发现耗时超标,会在源头直接拦截,强行把30FPS砍到20FPS,把帧扔进垃圾桶。
**【对应源码 `FFmpegRecorder.cpp -> run` 主循环】**
// 获取 AI 流控策略
StreamConfig strategy = m_adaptiveCtrl->getCurrentConfig();
bool shouldDrop = false;

// 发现网络/编码质量差,源头强行降帧
if (strategy.quality == NetworkQuality::Poor) {
    if (m_frameIdx % 3 == 0) shouldDrop = true; // 30fps 强降 20fps
}

if (shouldDrop) {
    // 拦截:根本不进 processVideo 的同步算法!直接丢弃保命!
} else {
    processVideo(vFrame); // 机器健康,才放行处理
}
8.2.4 音频的绝对统治
音频的代码异常安静。它不需要看别人脸色,不需要任何复杂的if-else。它只做一件事:老老实实的的把采样点加起来做为自己的时间戳。
**【对应源码 `FFmpegRecorder.cpp -> processAudio`】**
// 没有丢弃,没有克隆,单纯的累加就是真理
int64_t ptsOffset = av_rescale_q(m_config.audio.globalSyncOffsetMs, {1, 1000}, m_aEncoder->getContext()->time_base);
m_aFrame->pts = m_totalAudioSamples + ptsOffset;
m_totalAudioSamples += frameSize; // 老老实实铺砖
9 基于FFMPEG实现直播录制过程
9.1 全局与网络环境初始化
音视频流转之前,必须初始化FFmpeg的全局网络组件以及系统的硬件加速上下文(如D3D11)。
- 实际意义:为后续的RTMP/SRT等网络协议推流加载底层Socket库,并为硬件编码器(如NVENC)准备GPU内存交互通道。
- 代码位置:FFmpegRecorder.cpp -> FFmpegRecorder::initNetwork()和startRecord()
代码片段:
void FFmpegRecorder::initNetwork() {
    avformat_network_init();
}

// 在 startRecord 中初始化 D3D 设备
if (!m_d3dDevice) {
    setD3DDevice(DX11Context::instance().device());
}
- 核心FFmpeg API 解析:
- avformat_network_init():这是一个全局函数。它会在底层注册所有的网络协议(如HTTP、RTMP、TCP、UDP)。如果不调用此函数,后续使用avio_open2尝试连接直播服务器,会直接报错“找不到协议”。
9.2 编码器初始化
这是决定**“直播超低延迟”和”录播高画质“**分水岭的一步。系统通过读取配置,针对性地设置编码器参数。
- 实际意义:
- 直播:极致压缩缓冲,强行关闭B帧,牺牲部分压缩率换取绝对的实时性。
- 录播:允许较大的GOP和B帧,使用VBR/CBR追求更高的画面质量。
- 代码位置:FFmpegRecorder.cpp -> FFmpegRecorder::run()(预处理配置)以及FFmpegModules.h -> VideoEncoder::tryInitEncoder。
// 在 FFmpegRecorder::run() 中针对直播强制覆盖低延迟参数
if (m_config.streaming.enable) {
    m_config.streaming.tune = "zerolatency";
    m_config.streaming.preset = "superfast";
    m_config.streaming.max_b_frames = 0; // 核心:禁用 B 帧
}

// 在 FFmpegModules.h 中执行底层初始化
ctx = avcodec_alloc_context3(codec);
ctx->max_b_frames = 0; // 对应直播
ctx->rc_buffer_size = bitrate / 2; // 控制 VBV 缓冲区
// ...
av_opt_set(ctx->priv_data, "tune", "zerolatency", 0);
int ret = avcodec_open2(ctx, codec, nullptr);
- 核心FFmpeg API 解析:
- avcodec_find_encoder_by_name():通过字符串(如”libx264“,“h264_nvenc”)在FFmpeg注册表中查找对应的编码器驱动。
- av_opt_set():极其关键的底层调优接口。FFmpeg的编码器(尤其是第三方库如x264/nvenc)有大量的私有参数(priv_data)。设置”runes“,”zerolatency“会在底层指示x264禁用Lookahead(未来帧预测)并抛弃B帧,确保画面输入后立马能被编码器出来。不会驻留编码器内部。
- avcodec_open2():根据上述配置,正式向操作系统申请内存并打开编码器实例。
9.3 封装器初始化与网路握手
编码器准备好后,需要创建容器(FLV/MP4)来承载编码后的数据。这里通过多态(FileMuxer和StreamMuxer)实现了同时写本地和推网络。
- 实际意义:
- 录播:在本地磁盘创建**.mp4**文件并写入文件头(Moov Box)。
- 直播:与远程流媒体服务器(如Nginx-RTMP。BiliBili)建立TCP连接,完成RTMP握手,并发送FLV Metadata(包含流媒体信息)。
// StreamMuxer 网络推流初始化
av_dict_set(&opts, "tcp_nodelay", "1", 0);       // 禁用 Nagle 算法
av_dict_set(&opts, "flush_packets", "1", 0);     // 无缓冲立即发送
av_dict_set(&opts, "rw_timeout", "3000000", 0);  // 3秒超时

ret = avformat_alloc_output_context2(&fmtCtx, nullptr, "flv", m_path.toStdString().c_str());
ret = avio_open2(&fmtCtx->pb, m_path.toStdString().c_str(), AVIO_FLAG_WRITE, nullptr, &opts);
avformat_write_header(fmtCtx, nullptr);
核心FFmpeg API 解析:
- avformat_alloc_output_context2():自动根据后缀(.mp4)或强指定格式(“flv”)分配上下文AVFormatContext。
- avio_open2:这是I/O层的核心。对于直播URL,它会阻塞执行DNS解析、TCP三次握手和应用层握手。代码中传入字典opts(如tcp_nodelay=1)直接作用于底层Socket API,避免数据包在系统缓冲中滞留。
- avformat_write_header():将参数(如视频宽高、音频采样率)格式化并写入容器头部。直播时,这一步实际上就把流配置发给了服务器,服务器此时才知道即将收到什么流。
9.4 数据预处理
在将画面和声音发送给编码器前,必须将其转化为编码器唯一认识的格式(如视频NV12,音频FLTP)。
- 实际意义:处理用户采集的任意分辨率画面和多路音频(麦克风+系统音)的混合,统一采样率和格式。
- 代码位置:FFmpegRecorder.cpp -> initScaler/processVideo 以及FFmpegModules.h -> AudioDSP::pushData。
// 视频缩放与格式转换
m_swsCtx = sws_getCachedContext(..., SWS_BICUBIC, ...);
sws_scale(m_swsCtx, srcFrame->data, srcFrame->linesize, 0, data.height, m_scaledFrame->data, m_scaledFrame->linesize);

// 音频重采样
int convertedSamples = swr_convert(ctx.swr, ctx.resampleBuffer, outSamplesMax, inputData, inSamples);
av_audio_fifo_write(ctx.fifo, (void**)ctx.resampleBuffer, convertedSamples);
- 核心FFmpeg API 解析:
- sws_scale():底层利用CPU SIMD指令集(如AVX/SSE)对图像进行高效的矩阵运算和插值(如双三次插值SWS_BICUBIC),以实现色彩空间转换(RGB->YUV)和画面缩放。
- swr_convert()& av_audio_fifo_write():swr_convert使用FIR滤波器对音频采样点进行重新计算(如48khz转44.1khz)。由于音频编码要求固定大小的帧(如AAC每帧1024个采样点),重采样后数据量往往不规整,因此底层必须用AVAudioFifo(环形缓冲区)暂存数据,以便后续定长抽取。
9.5 核心编码
将庞大的裸数据(YUV/PCM)压缩成体积极小的包(H.264/AAC)。
- 实际意义:节省网络带宽和磁盘空间。
- 代码位置:FFmpegModules.h —>VideoEncoder::sendAndReceive。
AVPacket* VideoEncoder::sendAndReceive(AVFrame* frame) {
    int ret = avcodec_send_frame(ctx, frame); // 送入裸帧
    if (ret < 0 && ret != AVERROR_EOF) return nullptr;

    ret = avcodec_receive_packet(ctx, pkt);   // 取出压缩包
    if (ret == 0) return av_packet_clone(pkt);
    return nullptr;
}
- 核心FFmpeg API解析:
- avcodec_send_frame() & avcodec_receive_packet():这是FFmpeg 3.x 引入的异步收发API。
- 底层逻辑:调用send时,FFmpeg会将帧拷贝到内部缓冲队列或提交给GPU(硬件编码)。调用receive时,尝试获取压缩结果。
- 直播与录播的差异表现:在直播模式(0B帧)下,送入1帧通常马上能receive一个包。而在录播模式下,可能需要送入各多帧后(为了计算B帧),才能拉取到第一个包(存在一定的滞后性)。
- avcodec_send_frame() & avcodec_receive_packet():这是FFmpeg 3.x 引入的异步收发API。
9.6 封包写入与异步发送
为了防止推流时网络波动卡住主编码线程,代码将生成的AVPacket压入队列,由单独的StreamSender线程复责实际的网络发送和文件写入。
- 实际意义:完成最终的音画同步(时间戳转换),并将数据安全地落地到磁盘和推送到远端。
- 代码位置:FFmpegModules.h -> BaseMuxer::writePacket 与 StreamSender::run。
int BaseMuxer::writePacket(AVPacket* pkt, const AVRational& sourceTimeBase, bool isVideo) {
    // 转换时间基
    av_packet_rescale_ts(localPkt, sourceTimeBase, outStream->time_base);
    // 交织写入
    int ret = av_interleaved_write_frame(fmtCtx, localPkt);
    return ret;
}
核心FFmpeg API解析:
av_packet_rescale_ts():时间基转换。编码器通常以帧率作为时间基(如1/30),而容器(如FLV)通常以毫秒(1/1000)为时间基。此函数按比例精确缩放PTS和DTS,防止播放端出现音画不同步或快放/慢放现象。
av_interleaved_write_frame():
底层逻辑:不仅仅是"写入"。interleaved意味着他会在内部维护一个缓存,自动将视频包和音频包按时间戳顺序交织排序(例如:
交替排布1s视频和1s音频)。这能确保播放器在拉流时顺序读取既可以完美回放,不需要在内存里缓存大量数来对齐。
结合前面的flush_packets=1选项,当交织完成后,底层会立即调用Socket send()将其发送网络,实现直播的极低延迟。
10 ABR?为什么要防阻塞?
1.什么是自适应码率(Adaptive Bitrate,ABR)?
在流媒体推流中,ABR是一种根据当前网络实时带宽,动态调整视频编码输出码率(画质/帧率)的技术。
2.为什么需要ABR和防阻塞?
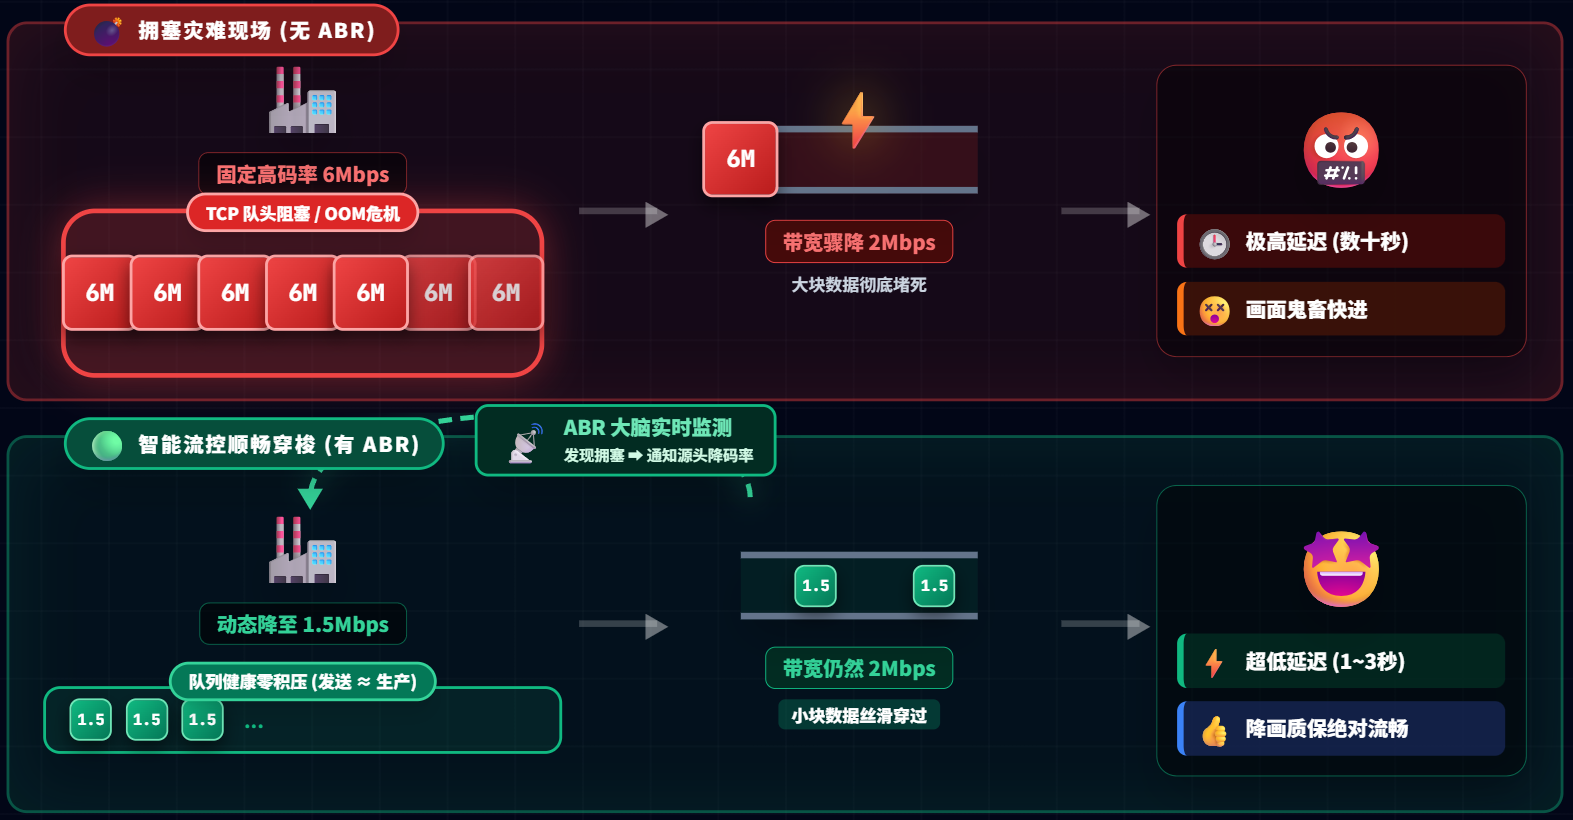
- 网络抖动的必然性:由于Wi-Fi信号干扰、基站切换、宽带共享等原因,主播端的上行带宽经常发生剧烈波动。
- 不进行干预的恐怖后果(TCP头部阻塞):直播推流通常使用RTMP(基于TCP)。当网络拥堵(发送速度<编码速度)时,数据包会在操作系统和发送缓冲区和FFmpeg内部队列中疯狂积压。
- 后果一:极高的延迟。
- 后果二:内存爆满,甚至导致程序OOM(Out of Memory)崩溃。
- 后果三:当队列终于排空时,播放端会瞬间收到大量过期数据,导致画面鬼畜式快进。
10.1 AIMD防拥塞算法
在本项目中,AdativeStreamController的核心灵魂是AIMD算法(加法增大,乘法减小)。这也是TCP拥塞控制的核心思想。
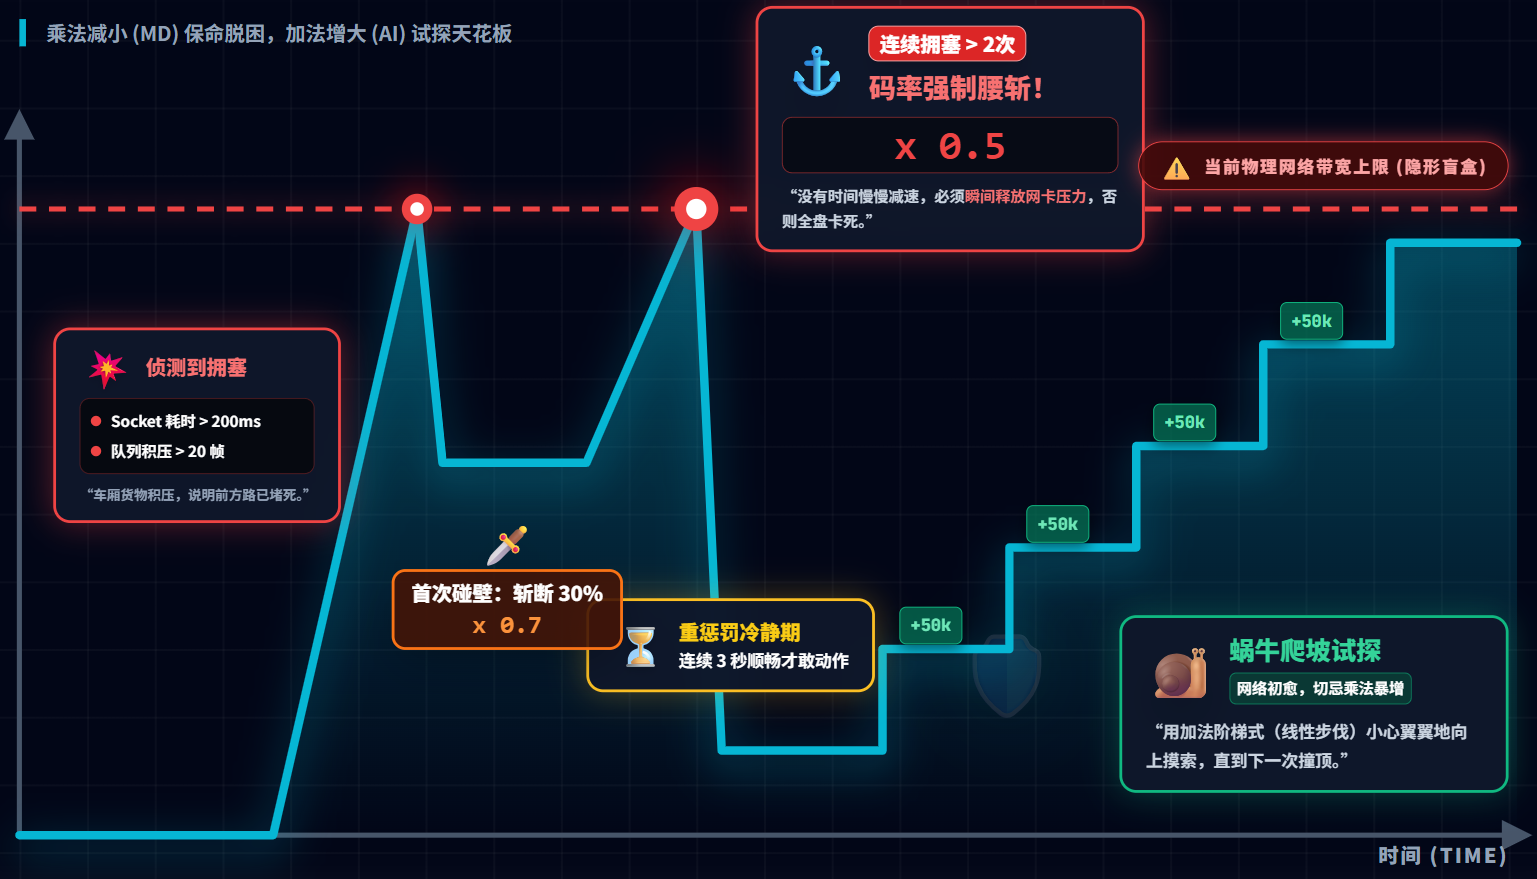
1.侦测拥塞
流媒体程序就像坐在车里的司机,看不到前面的路况,智能通过“感觉”来判断。
- 判断A:发送耗时变长。
//AdaptiveStreamController::reportSentStats()
// --- 核心算法:判断拥塞 ---
// 判据1: socket 发送阻塞超过 100ms (说明带宽满了)
// 判据2: 平均延迟持续升高
bool isCongested = (durationMs > 200) || (m_avgLatency > 150);
如果在正常网络下发送一个包只要5ms,现在却要200ms。说明网卡堵了。
- 判断B:队列积压。
//FFmpegRecorder::checkNetworkHealth
int queueSize = m_sender->getQueueSize();
// [调优] 放宽丢帧阈值,高分辨率下包可能会更多
const int THRESHOLD_DROP = 30;       // 原 30 -> 100 (给予更多缓冲时间)
const int THRESHOLD_CONGESTION = 20;  // 原 10 -> 20
// ...
else if (queueSize > THRESHOLD_CONGESTION) {
    // ... 处理轻微拥塞
}
在FFmpegRecorder::checkNetworkHealth中,如果发现m_sender里积压队列超过了THRESHOLD_CONGESTION,说明发送速度已经跟不上编码速度了。
2.AIMD算法
乘法减小(MD)——遇到拥堵,重拳出击保命:
在AdaptiveStreamController::adjustBitrate中,一旦判断网络拥塞,我们会断崖式降低码率。
如果连续拥塞次数少,码率乘以0.7(砍掉30%)
如果连续拥塞超过2次,码率直接乘以0.5(腰斩)。
底层逻辑:拥塞发生时,带宽雪崩是瞬间的,必须要最猛烈的手段清空拥塞窗口,否则死路一条。
//AdaptiveStreamController::adjustBitrate
if (isCongested) {
    // [乘法减小] Multiplicative Decrease
    m_consecutiveCongestionCount++;
    m_consecutiveGoodCount = 0;
    // 拥塞越严重,降得越快
    float dropFactor = (m_consecutiveCongestionCount > 2) ? 0.5f : 0.7f;
    m_currentBitrate = static_cast<int>(m_currentBitrate * dropFactor);
    qWarning() << "[Adaptive] Network Congestion! Dropping Bitrate to:" << m_currentBitrate / 1000 << "kbps";
    m_lastAdjustmentTime = now;
}
- 加法增大(AI)——网络恢复,小心试探:
- 连续持续3s以上网络顺畅(m_consecutiveGoodCount > 3),我们每次只增加50kbps。
- 底层逻辑:不能加的太猛,否则会立刻再次引发拥塞。这种线性的试探可以安全地摸索出当前带宽的真正上限。
//AdaptiveStreamController::adjustBitrate
else {
    // [加法增大] Additive Increase
    m_consecutiveCongestionCount = 0;
    m_consecutiveGoodCount++;
    // 网络稳定 3秒后才开始试探性增加
    if (m_consecutiveGoodCount > 3) {
        m_currentBitrate += 50000; // 每次加 50kbps
        m_lastAdjustmentTime = now;
    }
}